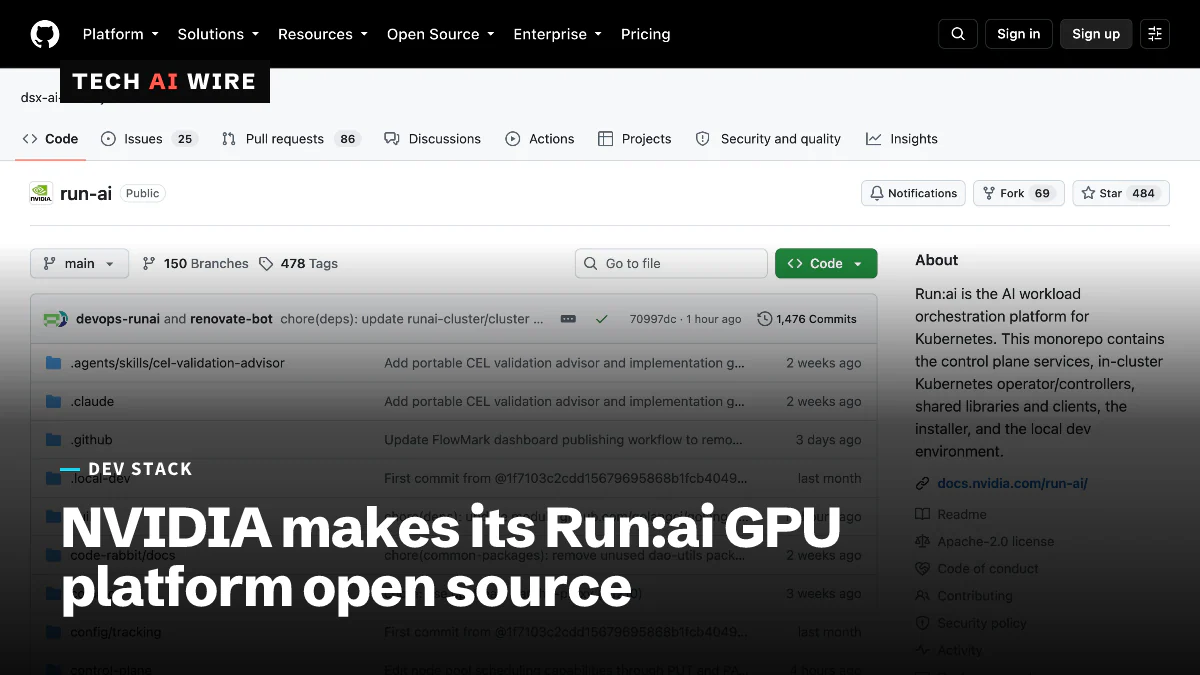
NVIDIA Run:ai pasa a ser de código abierto, con el reparto de GPU incluido
NVIDIA publicó el 13 de octubre toda su plataforma de orquestación de GPU Run:ai como código abierto, dividida en cuatro módulos que los equipos pueden adoptar de uno en uno.
4 min de lectura
En cifras
- modules that can be adopted one at a time
- 4
- partner platforms integrating it at launch
- 8
- of full-GPU throughput at half a GPU, in Nebius tests
- 77%
- subscription needed; NVIDIA support not included
- $0
NVIDIA publicó toda su plataforma Run:ai como código abierto el 13 de octubre de 2026. Run:ai es un software que decide qué trabajos de IA se ejecutan en qué GPU de un clúster. Hasta ahora, la mayor parte era un producto de pago. Cualquier equipo que use GPU de NVIDIA sobre Kubernetes ya puede instalarlo sin suscripción.
Esto importa porque las GPU son caras y a menudo están inactivas. La función principal de Run:ai es meter más trabajo en los mismos chips.
Qué ha publicado NVIDIA
Según el anuncio de NVIDIA, toda la plataforma es ahora de código abierto como parte de su DSX AI Factory Platform. NVIDIA compró Run:ai a finales de 2024, señala Techstrong.ai.
La plataforma funciona sobre Kubernetes, el sistema muy extendido para ejecutar software en muchos servidores. NVIDIA la dividió en cuatro partes que los equipos pueden adoptar por separado: KAI Scheduler, el GPU Fractioning Operator, KAI Resource Management y Workload Map.
| Elemento | Detalle |
|---|---|
| Publicación | 13 de octubre de 2026 |
| Módulos | KAI Scheduler, GPU Fractioning Operator, KAI Resource Management, Workload Map |
| Dónde conseguirlo | NGC Community Product, instalado con un Helm chart |
| Precio | No requiere suscripción de pago |
| Soporte | No incluye el soporte empresarial de NVIDIA |
| Licencia de KAI Scheduler | Apache 2.0, un proyecto Sandbox de la CNCF |
| Socios de lanzamiento | 8 |
NGC es el catálogo de software de NVIDIA. Un Helm chart es un paquete de instalación listo para usar en Kubernetes.
KAI Scheduler en sí no es nuevo en el código abierto. Está disponible con licencia Apache 2.0 desde abril de 2025 y se cedió a la CNCF, la fundación detrás de Kubernetes, como proyecto Sandbox en fase inicial. El código del resto está en la organización DSX AI Factory de NVIDIA en GitHub. La publicación de NVIDIA dice que se distribuye bajo «licencias de código abierto aplicables», sin nombrar una para toda la plataforma.
Cómo funciona el reparto de GPU
La función estrella es el fraccionamiento, es decir, dividir una GPU entre varios trabajos. Un modelo pequeño que atiende un chatbot rara vez necesita una GPU de centro de datos entera. Sin reparto, recibe una de todos modos, y el resto queda sin usar.
Techstrong.ai informa de que el fraccionamiento pasa de la versión propietaria de NVIDIA a tener soporte nativo en CUDA 13.4, el kit de herramientas de programación de GPU de NVIDIA. El operador de código abierto añade la capa de Kubernetes por encima.
Nebius, proveedor de nube y socio de lanzamiento, publicó resultados de pruebas. Usaron la versión comercial 2.24 de Run:ai, no la nueva versión abierta:
- Con media GPU, las cargas de trabajo mantuvieron el 77 % del rendimiento de una GPU completa.
- Con media GPU, mantuvieron el 86 % de los usuarios que podía atender una GPU completa: 8.768 frente a 10.200.
- Ejecutar juntos modelos de chat, razonamiento y embeddings en GPU compartidas permitió atender a unas tres veces más usuarios que dar a cada uno su propia GPU.
«Si media GPU ofrece el 77 % del rendimiento, la asignación de todo o nada deja capacidad ociosa», escribe Nebius.
Quién la respalda
Ocho socios integran la plataforma en el lanzamiento, según NVIDIA: Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud y vCluster. Nebius la ofrece en su servicio gestionado de Kubernetes.
NVIDIA también cita resultados de Model Streamer, una herramienta relacionada que carga más rápido los archivos de modelos en las GPU. Microsoft Azure informa de cargas de tres a seis veces más rápidas, a 80 Gbps constantes frente a unos 40 Gbps por la ruta predeterminada.
La pega: sigue funcionando sobre CUDA
Techstrong.ai señala el límite. El reparto de GPU depende de CUDA, así que solo funciona en hardware de NVIDIA. Run:ai dijo en su día que daría soporte a chips de AMD e Intel, y esta publicación no aborda ese punto.
«El código abierto no equivale a neutralidad de hardware, y los compradores deberían juzgar esta publicación con ese criterio», dijo Mitch Ashley, de The Futurum Group. «La verdadera prueba llegará cuando un segundo fabricante de aceleradores entre en el centro de datos».
Qué significa para los desarrolladores
Para los equipos de plataforma que usan GPU sobre Kubernetes:
- Empiece por un módulo. KAI Scheduler es la pieza más madura, con más de un año como código abierto. Pruébelo en un clúster de pruebas antes de añadir el reparto de GPU.
- Mida el reparto con sus propios modelos. La cifra del 77 % salió de las pruebas de Nebius con la versión comercial. Los trabajos de inferencia con tráfico estable y bajo son los mejores candidatos. Los grandes trabajos de entrenamiento suelen seguir necesitando GPU completas.
- Planifique el soporte por su cuenta. La versión gratuita llega sin el soporte empresarial de NVIDIA. Reserve tiempo de ingeniería para operarla o recurra a uno de los ocho socios.
- Revise las licencias repositorio por repositorio. NVIDIA indica Apache 2.0 para KAI Scheduler, pero ninguna licencia única para toda la plataforma. Pida al equipo legal que revise cada componente que despliegue.
- Calcule la dependencia. El fraccionamiento nativo necesita CUDA 13.4. Si prevé añadir AMD u otros aceleradores, conserve opciones de planificación que no dependan de él.
Fuentes
Artículos relacionados
ZLUDA añade soporte de cuFFT para GPU AMD vía hipFFT
Una pull request ya fusionada añade la biblioteca cuFFT de NVIDIA a ZLUDA, permitiendo que las GPU AMD ejecuten unidades de Folding@Home basadas en CUDA sin cambiar el código.

Nouveau arranca en el DGX Spark GB10 de Nvidia, de forma extraoficial
Un ingeniero de Red Hat consiguió que el controlador libre Nouveau y NVK funcionen en el DGX Spark GB10 de Nvidia. Hicieron falta unos 100 parches, y aún no está decidido cómo integrarlos oficialmente.
Microsoft se retiraría del centro de datos de Nscale en Loughton
Microsoft habría abandonado su acuerdo como inquilino ancla del emplazamiento de Nscale en Loughton, donde la electricidad podría no llegar hasta la década de 2030, semanas antes de una salida a bolsa de 3.000 millones de dólares.