NVIDIA Run:aiがオープンソース化、GPU共有機能も含めて公開
NVIDIAは10月13日、GPUオーケストレーション基盤Run:ai(ランエーアイ)の全体をオープンソースとして公開しました。GPU分割(フラクショニング)を含む4つのモジュールに分かれ、1つずつ導入できます。
4 分で読めます
数字で見る
- modules that can be adopted one at a time
- 4
- partner platforms integrating it at launch
- 8
- of full-GPU throughput at half a GPU, in Nebius tests
- 77%
- subscription needed; NVIDIA support not included
- $0
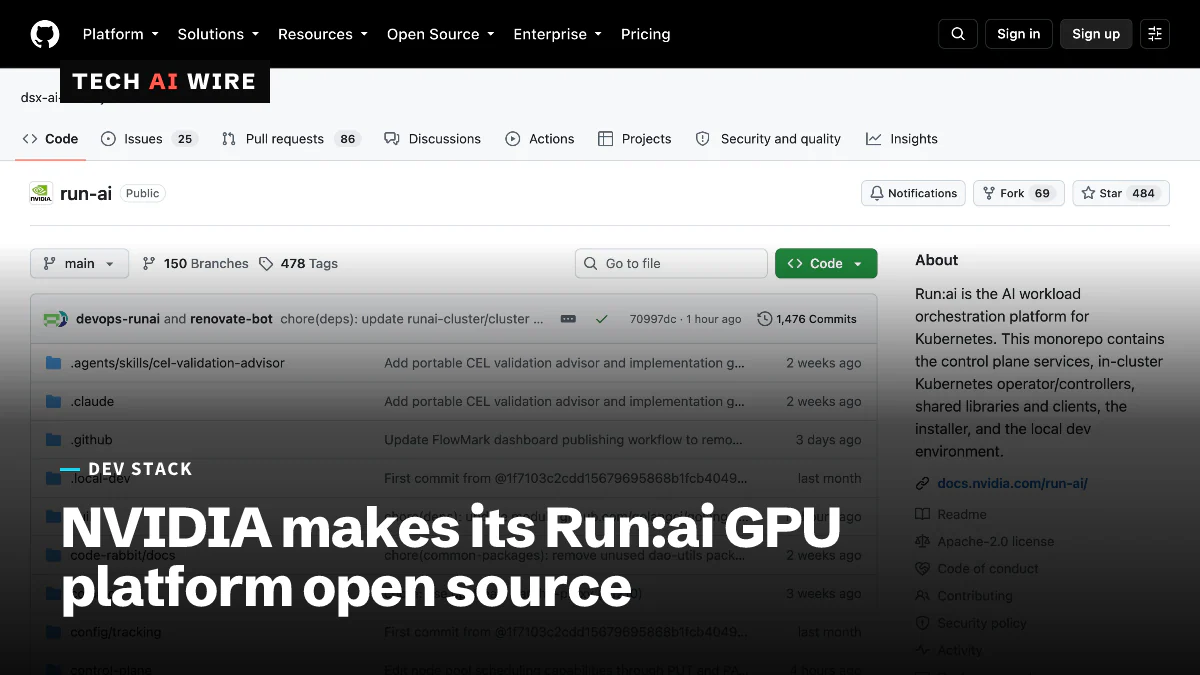
NVIDIAは2026年10月13日、Run:aiプラットフォームの全体をオープンソースとして公開しました。Run:aiは、クラスター内のどのGPUでどのAIジョブを動かすかを決めるソフトウェアです。これまでは、その大半が有料製品でした。Kubernetes上でNVIDIAのGPUを動かしているチームなら、サブスクリプションなしで導入できるようになりました。
GPUは高価で、使われずに遊んでいることも多いため、これは重要です。Run:aiの主な役割は、同じチップにより多くの作業を詰め込むことです。
NVIDIAが公開したもの
NVIDIAの発表によると、プラットフォーム全体がDSX AI Factory Platformの一部としてオープンソースになりました。Techstrong.aiによると、NVIDIAは2024年末にRun:aiを買収しています。
このプラットフォームはKubernetes上で動きます。Kubernetesは、多数のサーバーにまたがってソフトウェアを動かすために広く使われているシステムです。NVIDIAはこれを4つの部分に分け、チームが個別に導入できるようにしました。KAI Scheduler、GPU Fractioning Operator、KAI Resource Management、Workload Mapです。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年10月13日 |
| モジュール | KAI Scheduler、GPU Fractioning Operator、KAI Resource Management、Workload Map |
| 入手先 | NGC Community Product(Helm chartでインストール) |
| 価格 | 有料サブスクリプションは不要 |
| サポート | NVIDIAのエンタープライズサポートは含まれない |
| KAI Schedulerのライセンス | Apache 2.0、CNCFのSandboxプロジェクト |
| ローンチパートナー | 8社 |
NGCはNVIDIAのソフトウェアカタログです。Helm chartは、Kubernetes向けの既製のインストールパッケージです。
KAI Scheduler自体は、オープンソースとしては新しいものではありません。2025年4月からApache 2.0ライセンスで公開されており、Kubernetesを支える財団であるCNCFに、初期段階のSandboxプロジェクトとして寄贈されています。残りの部分のコードは、GitHub上にあるNVIDIAのDSX AI Factoryの組織アカウントに置かれています。NVIDIAの投稿は「適用されるオープンソースライセンス」で提供するとしており、プラットフォーム全体としてのライセンス名は挙げていません。
GPU共有の仕組み
目玉となる機能はフラクショニング、つまり1つのGPUを複数のジョブで分け合うことです。チャットボットを動かす小さなモデルが、データセンター向けGPUを丸ごと必要とすることはめったにありません。共有がなければ、それでもGPUが丸ごと1つ割り当てられ、残りは使われないままになります。
Techstrong.aiによると、フラクショニングはNVIDIAの独自版から、CUDA 13.4のネイティブサポートへと移ります。CUDAは、NVIDIAのGPUプログラミング用ツールキットです。オープンソースのオペレーターは、その上にKubernetesの層を加えます。
クラウド事業者でローンチパートナーでもあるNebiusが、テスト結果を公表しました。使われたのは新しいオープン版ではなく、商用のRun:aiバージョン2.24です。
- GPUを半分にしても、ワークロードはGPU1つ分のスループットの77%を維持しました。
- GPUを半分にしても、GPU1つで対応できるユーザー数の86%(8,768人対10,200人)を維持しました。
- チャット、推論、埋め込みのモデルを共有GPUでまとめて動かすと、それぞれに専用のGPUを割り当てる場合のおよそ3倍のユーザーに対応できました。
「GPUの半分でスループットの77%が出るなら、全か無かの割り当てでは容量を遊ばせていることになる」とNebiusは書いています。
支援している企業
NVIDIAによると、ローンチ時点で8社のパートナーがこのプラットフォームを統合しています。Crusoe、Mirantis、Nebius、OpenNebula Systems、Rafay、Saturn Cloud、Spectro Cloud、vClusterです。Nebiusは、自社のマネージドKubernetesサービスで提供しています。
NVIDIAは、関連ツールであるModel Streamerの結果も挙げています。Model Streamerは、モデルファイルをGPUにより速く読み込むツールです。Microsoft Azureは、読み込みが3倍から6倍速くなったと報告しています。標準の経路では約40 Gbpsのところ、安定して80 Gbpsが出たとのことです。
落とし穴: 今もCUDAの上で動く
Techstrong.aiは、その限界を指摘しています。GPU共有はCUDAに依存するため、NVIDIAのハードウェアでしか動きません。Run:aiはかつてAMDやIntelのチップに対応すると表明していましたが、今回の公開はその点に触れていません。
「オープンソースはハードウェア中立と同じではない。購入する側は、その線引きでこのリリースを判断すべきだ」と、The Futurum GroupのMitch Ashley氏は述べました。同氏は「本当の試金石は、2社目のアクセラレーターベンダーがデータセンターに入ってきたときに訪れる」とも述べています。
開発者にとっての意味
Kubernetes上でGPUを動かすプラットフォームチームに向けたポイントです。
- まず1つのモジュールから始める。 KAI Schedulerは最も成熟した部分で、オープンソースになってから1年以上が経っています。GPU共有を加える前に、テスト用のクラスターで試してください。
- 自社のモデルで共有のベンチマークを取る。 77%という数字は、Nebiusが商用版で行ったテストの結果です。トラフィックが安定していて小さい推論ジョブが、最も向いています。大規模な学習ジョブは、今も多くの場合GPUを丸ごと必要とします。
- サポートは自分たちで計画する。 無料版には、NVIDIAのエンタープライズサポートが付きません。運用のためのエンジニアリング時間を予算に組み込むか、8社のパートナーのいずれかを利用してください。
- ライセンスはリポジトリごとに確認する。 NVIDIAはKAI SchedulerについてApache 2.0を挙げていますが、プラットフォーム全体の単一のライセンスは示していません。導入する各コンポーネントを、法務部門に確認してもらってください。
- ロックインを見積もる。 ネイティブのフラクショニングにはCUDA 13.4が必要です。AMDなど他のアクセラレーターを追加する予定があるなら、それに依存しないスケジューリングの選択肢を残しておいてください。
出典
関連記事
ZLUDA、hipFFT経由でAMD GPU向けcuFFT対応を追加
マージされたプルリクエストによりZLUDA(ズルーダ)にNVIDIAのcuFFTライブラリが追加された。AMD GPUはコード変更なしでCUDAベースのFolding@Homeユニットを実行できる。

NouveauがNvidiaのDGX Spark GB10で非公式に起動
Red HatのエンジニアがオープンソースのNouveauドライバーとNVKを、NvidiaのDGX Spark GB10で動かしました。約100件のパッチが必要で、アップストリーム入りはまだ決まっていません。
Microsoft、NscaleのLoughtonデータセンターから撤退と報道
Microsoftが、Nscale(エヌスケール)のLoughton拠点でアンカーテナントとなる契約を取りやめたと報じられています。同拠点は電力が2030年代まで届かない可能性があり、30億ドル規模のIPOを数週間後に控えた時期です。