kernel.org diz que só 2% do seu tráfego git vem de desenvolvedores reais
Konstantin Ryabitsev publicou números concretos em 29 de agosto de 2026: o git.kernel.org recebe 6 milhões de requisições por dia e só cerca de 2% parecem humanas.
3 min de leitura
Em números
- requests a day to git.kernel.org
- 6M
- of that traffic judged legitimate
- 2%
- of scrapers blocked by the challenge
- 66%
Apenas cerca de 2% do tráfego que chega ao git.kernel.org parece vir de um desenvolvedor real. Konstantin Ryabitsev publicou essa estimativa em 29 de agosto de 2026, num texto chamado "Creepy crawlies". O restante são raspadores a serviço de IA, e eles já custam à infraestrutura do próprio núcleo Linux mais poder de processamento do que todos os usos legítimos somados.
Ryabitsev é o mantenedor da infraestrutura do núcleo, como o descreve o LWN.net. Ele opera o git.kernel.org, o site público que permite a qualquer pessoa navegar pelo histórico do código-fonte do Linux em um navegador.
Os números por trás da afirmação
O site recebe cerca de 6 milhões de requisições por dia. A maioria pede para ver um commit antigo qualquer. Um commit é uma única alteração registrada no código, e o site precisa montar uma página web para cada uma delas sob demanda.
Esse trabalho se acumula. Ryabitsev escreve que 14 a 16 dos 90 núcleos de processador do site estão ocupados a todo momento fazendo apenas uma coisa: gerar páginas de commits para raspadores. Isso é cerca de um quinto de toda a capacidade do sistema, distribuída por cinco servidores em diferentes partes do mundo.
O resumo dele é direto. "We spend more CPU cycles rendering commits for scrapers than we spend on all other kinds of legitimate access, including git clones", escreveu: gasta-se mais ciclos de processador com raspadores do que com todos os acessos legítimos juntos, clones incluídos.
A página de verificação não os detém
O kernel.org já roda o Anubis, implantado há cerca de um ano. O Anubis é uma barreira de prova de trabalho. Antes de servir uma página, ele faz o navegador do visitante resolver um pequeno problema matemático. Para uma pessoa é trivial; para um programa que baixa milhões de páginas, é caro.
Funciona, em parte. Ryabitsev relata que o Anubis barra de imediato 66% dos raspadores. Mas 33% agora resolvem o problema e passam pela barreira mesmo assim. Pagar o custo de processamento aparentemente compensa para quem coleta os dados.
Por que bloquear endereços IP não funciona
A solução óbvia seria bloquear os endereços responsáveis. Segundo a reportagem do LWN, isso falha aqui. Os raspadores operam por meio de proxies residenciais, que encaminham as requisições por conexões domésticas comuns, alugadas de fornecedores como a Bright Data. Cada requisição chega de um endereço residencial diferente, então uma lista de bloqueio nunca alcança.
Separar os dois grupos é o problema mais difícil. "It's impossible to tell with certainty which of these are bots and which are real humans", escreveu Ryabitsev: é impossível dizer com certeza quais são robôs e quais são humanos reais. A regra prática dele é boa. Quem pede um commit antigo em um fork antigo escolhido ao acaso provavelmente não é um desenvolvedor trabalhando.
Comentaristas no Lobsters notaram que o ClaudeBot, o rastreador da Anthropic, aparece com destaque nos registros de servidores git expostos. Um leitor apontou o desperdício dos dois lados. Os raspadores escolhem, nas palavras dele, "the stupidest possible way of doing it - by rendering everything as HTML commit by commit and then parsing it": o jeito mais burro possível, gerar tudo como HTML commit a commit e depois analisar.
O que isso significa para os desenvolvedores
Se você hospeda um servidor git público, presuma que isso já está acontecendo com você. Os números do núcleo são extremos porque o núcleo é famoso, mas os rastreadores não escolhem alvos. Verifique que fatia do seu tráfego pede URLs profundas de commits em vez de clones. Essa proporção é o indício.
Ofereça o caminho barato em vez do caro. Um git clone é uma única transferência eficiente. Já um raspador que percorre todas as páginas de commits força seu servidor a montar milhares de documentos. Limitar a taxa da visualização web, deixando clone e fetch intactos, protege o orçamento sem bloquear o trabalho real.
Espere que páginas de verificação se espalhem, e espere que elas incomodem. O Anubis e ferramentas semelhantes já ficam na frente de muitos sites de projetos de código aberto. Quando um script de build ou um job de integração contínua de repente falha ao baixar um patch, uma barreira de prova de trabalho é uma causa provável. Aponte a automação para o protocolo git ou para um espelho, não para a interface web.
O ponto mais profundo é de financiamento. Uma infraestrutura mantida por voluntários está absorvendo o custo de uma coleta de dados de treinamento que ela nunca concordou em fornecer. Ninguém cobra dos rastreadores, então a conta sobra para os projetos.
Fontes
- Creepy crawlies - people.kernel.org
- Ryabitsev: Creepy crawlies - LWN.net
Artigos relacionados
Jemalloc 5.4.0 traz 160 commits após retomada da Meta
A primeira versão do jemalloc desde a retomada do investimento da Meta traz mais de 160 commits, uma nova camada de abstração de sistema e seleção de arena por CPU.
Kubernetes 1.37 promove o modo rootless a beta
O Kubernetes 1.37 promove o KubeletInUserNamespace a beta. O kubelet, os runtimes de contentores, os plugins CNI e o kube-proxy passam a poder correr como utilizador comum.
Hugging Face abre pré-vendas do robô open source Microduck por US$ 399
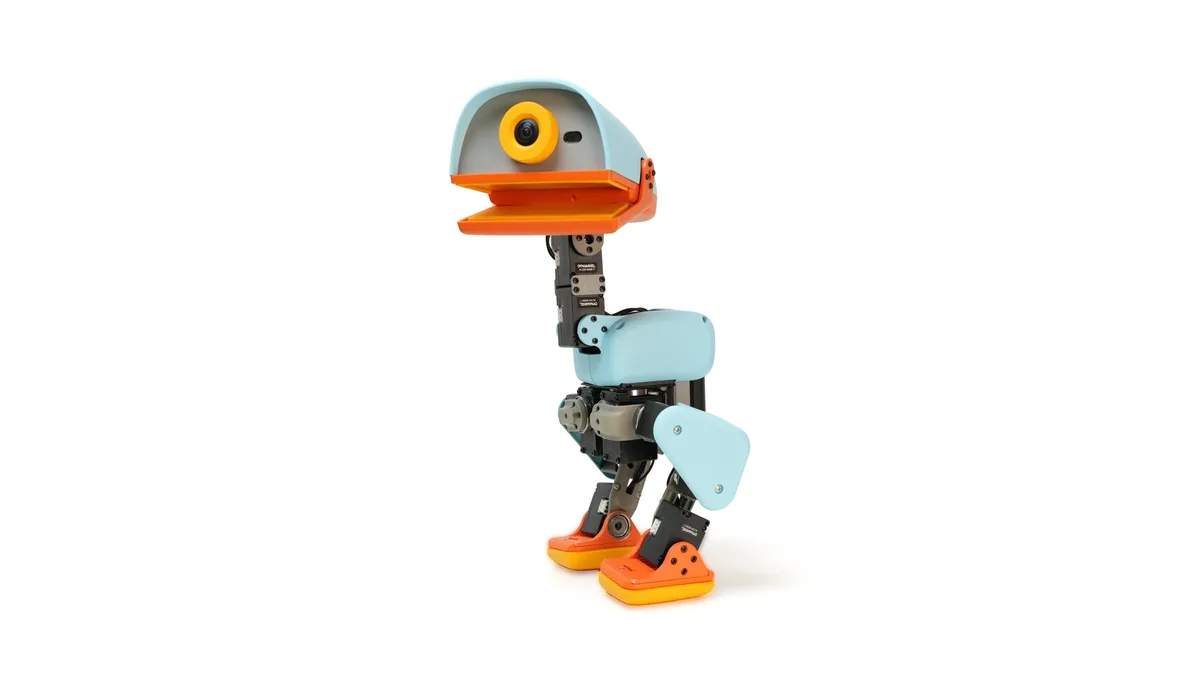
A Hugging Face está aceitando pré-vendas de US$ 399 do Microduck, um robô que anda e tem 25 cm de altura. Toda a pilha de aprendizado por reforço sai sob Apache 2.0, então você pode retreiná-lo.