kernel.org、git トラフィックのうち本物の開発者はわずか2%と公表
コンスタンティン・リャビツェフ氏が2026年8月29日に具体的な数字を公開した。git.kernel.org は1日600万リクエストを受けるが、人間らしいものは約2%にすぎない。
3 分で読めます
数字で見る
- requests a day to git.kernel.org
- 6M
- of that traffic judged legitimate
- 2%
- of scrapers blocked by the challenge
- 66%
git.kernel.org に届くトラフィックのうち、本物の開発者らしいものはおよそ2%にすぎない。コンスタンティン・リャビツェフ氏が2026年8月29日、「Creepy crawlies」と題した記事でこの推計を公開した。残りは AI スクレイパーであり、いまや Linux カーネル自身のインフラにとって、正当な利用すべてを合わせたよりも多くの計算資源を消費している。
リャビツェフ氏は、LWN.net の表現によればカーネルインフラのメンテナーである。同氏は git.kernel.org を運用している。これは Linux カーネルのソース履歴を誰でもブラウザーで閲覧できる公開ウェブサイトだ。
主張を支える数字
このサイトは1日あたり約600万件のリクエストを受ける。その大半は、無作為な古いコミットの表示を求めるものだ。コミットとはコードへの記録された1回の変更を指し、サイトはその一つひとつに対して、要求のたびにウェブページを組み立てなければならない。
その処理は積み重なる。リャビツェフ氏によれば、サイトが持つ90個のプロセッサーコアのうち、常時14〜16個がスクレイパー向けにコミットを描画するだけに費やされている。これはシステム全体のおよそ5分の1にあたり、世界各地の5台のサーバーに分散している。
同氏の総括は率直だ。「We spend more CPU cycles rendering commits for scrapers than we spend on all other kinds of legitimate access, including git clones」(git clone を含むあらゆる正当なアクセスの合計よりも、スクレイパー向けのコミット描画に多くの CPU サイクルを費やしている)と書いている。
認証ページでは止まらない
kernel.org はすでに Anubis を約1年前から運用している。Anubis はプルーフ・オブ・ワーク方式の関門だ。ページを返す前に、訪問者のブラウザーに小さな計算問題を解かせる。人ひとりにとっては些細だが、数百万ページを取得するプログラムには高くつく。
効果は、部分的にはある。リャビツェフ氏の報告では、Anubis はスクレイパーの66%をその場で追い返す。しかし33%はいまや問題を解いて関門を通り抜けている。データを集める側にとっては、計算コストを払う価値があるということだろう。
IP アドレスの遮断が効かない理由
分かりやすい対策は、問題のあるアドレスを遮断することだ。LWN の報道によれば、ここではそれが通用しない。スクレイパーは residential proxy を経由している。これは Bright Data のような業者から借りた一般家庭のインターネット回線を通してリクエストを送る仕組みだ。リクエストごとに別の家庭のアドレスから届くため、遮断リストは決して追いつかない。
より難しいのは、両者を見分けることだ。「It's impossible to tell with certainty which of these are bots and which are real humans」(どれがボットでどれが本物の人間かを確実に見分けるのは不可能だ)とリャビツェフ氏は書いた。同氏の経験則は的を射ている。無作為な古いフォークの古いコミットを求める相手は、仕事中の開発者ではまずない。
Lobsters のコメント欄では、Anthropic のクローラーである ClaudeBot が、公開された git サーバーのプロキシログに目立って現れると指摘された。ある読者は双方にとっての無駄を言い当てた。スクレイパーは、その表現を借りれば "the stupidest possible way of doing it — by rendering everything as HTML commit by commit and then parsing it"(考えうる最も愚かなやり方、つまり全部をコミットごとに HTML として描画させてから解析する)を選んでいる。
これが開発者にとって意味すること
公開の git サーバーを運用しているなら、すでに自分にも起きていると考えたほうがいい。カーネルの数字が極端なのはカーネルが有名だからだが、クローラーは相手を選ばない。自分のトラフィックのうち、クローンではなく深いコミット URL を求める割合を確認しよう。その比率が手がかりになる。
高くつく経路ではなく、安い経路を提供すること。git clone は効率のよい1回の転送で済む。一方、全コミットのページを巡回するスクレイパーは、サーバーに何千もの文書を組み立てさせる。クローンとフェッチはそのままに、ウェブ表示だけに流量制限をかければ、実作業を妨げずに費用を守れる。
認証ページは今後増えるだろうし、煩わしくもなるだろう。Anubis のような仕組みは、すでに多くのオープンソースプロジェクトのサイトの前に置かれている。ビルドスクリプトや CI ジョブが急にパッチを取得できなくなったら、プルーフ・オブ・ワークの関門が原因である可能性が高い。自動処理はウェブ画面ではなく、git プロトコルかミラーに向けよう。
より根本的な論点は資金の問題だ。有志が支えるインフラが、供給に同意した覚えのない学習データ収集の費用を肩代わりしている。誰もクローラーに請求しないので、請求書はプロジェクトに回ってくる。
出典
- Creepy crawlies - people.kernel.org
- Ryabitsev: Creepy crawlies - LWN.net
関連記事
Jemalloc 5.4.0、Metaの再投資後に160超のコミット
Metaが再投資を表明して以降で初のjemalloc(ジェマロック)リリースは、160を超えるコミット、新しいOS抽象化層、CPUごとのarena選択を含みます。
Kubernetes 1.37、rootlessモードがベータに昇格
Kubernetes 1.37でKubeletInUserNamespaceがベータになりました。kubelet、コンテナランタイム、CNIプラグイン、kube-proxyのすべてを非rootユーザーで動かせます。
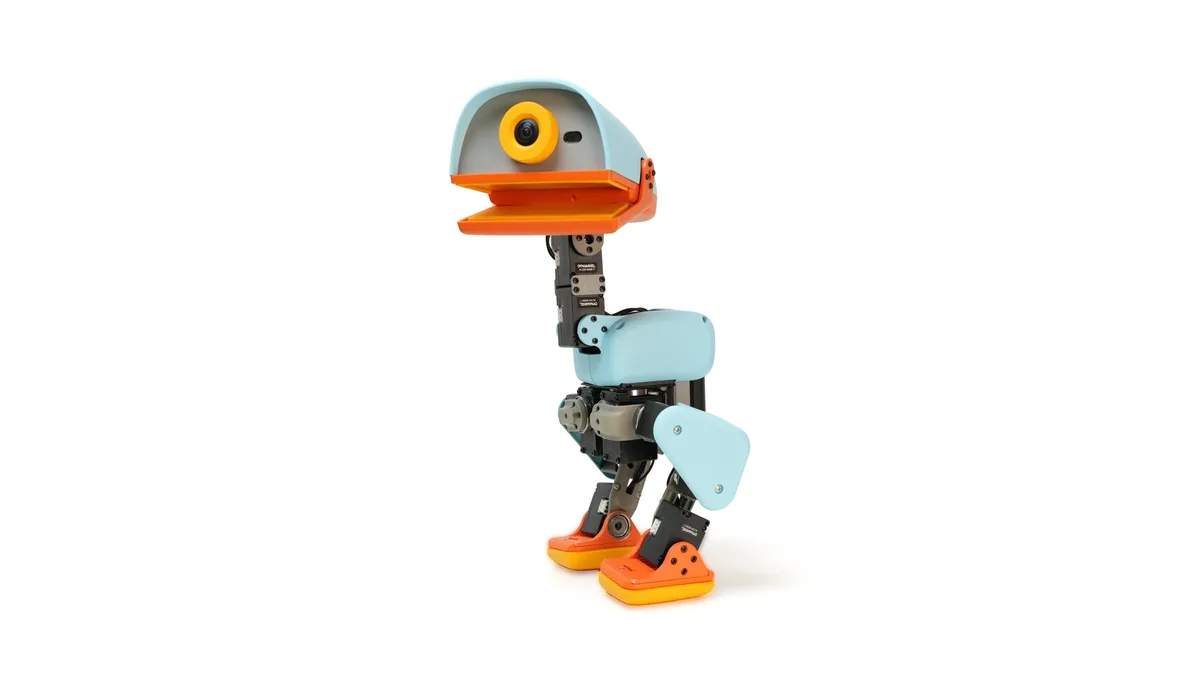
Hugging Face、399ドルのオープンソースロボットMicroduckの予約受付を開始
Hugging Faceは、歩行する25センチのロボットMicroduckを399ドルで予約受付中だ。強化学習スタックはすべてApache 2.0で公開されるので、自分で再学習できる。