kernel.org dice que solo el 2 % de su tráfico git son desarrolladores reales
Konstantin Ryabitsev publicó cifras concretas el 29 de agosto de 2026: git.kernel.org recibe 6 millones de peticiones al día y solo un 2 % parece humano.
3 min de lectura
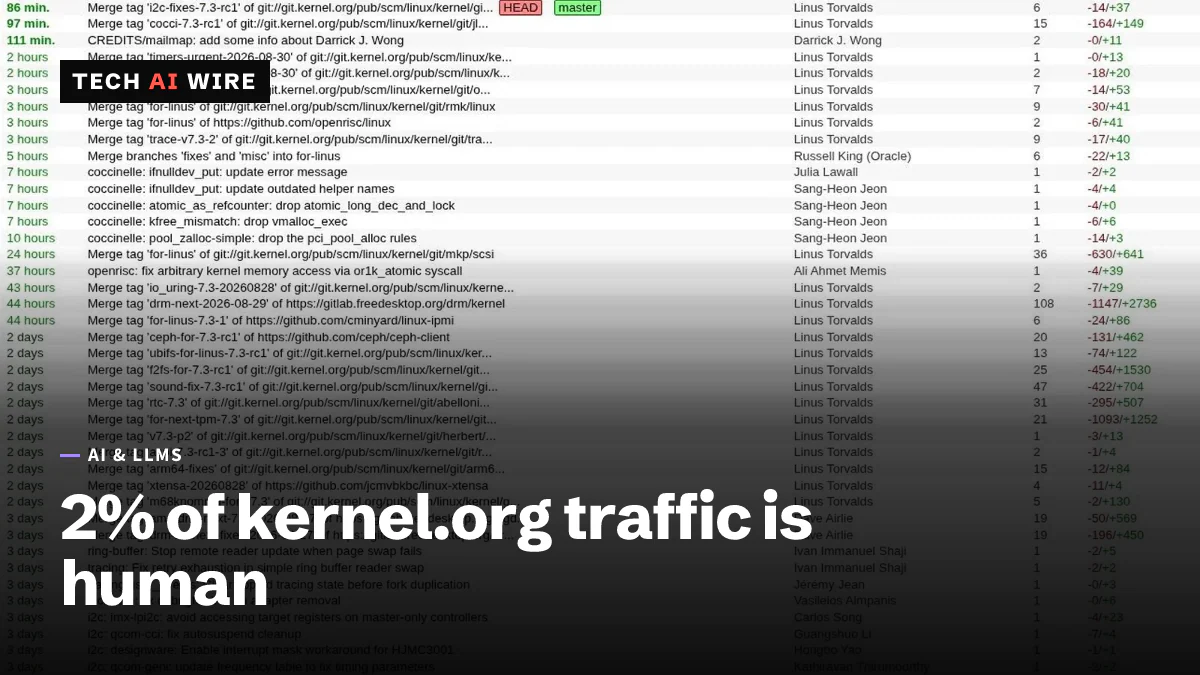
En cifras
- requests a day to git.kernel.org
- 6M
- of that traffic judged legitimate
- 2%
- of scrapers blocked by the challenge
- 66%
Solo alrededor del 2 % del tráfico que llega a git.kernel.org parece de un desarrollador real. Konstantin Ryabitsev publicó esa estimación el 29 de agosto de 2026 en una entrada titulada "Creepy crawlies". El resto son rastreadores de IA, y ya cuestan a la infraestructura del núcleo Linux más potencia de cálculo que todos los usos legítimos juntos.
Ryabitsev es el mantenedor de la infraestructura del núcleo, según lo describe LWN.net. Él administra git.kernel.org, el sitio público que permite a cualquiera consultar el historial del código fuente de Linux desde un navegador.
Las cifras detrás de la afirmación
El sitio recibe unos 6 millones de peticiones al día. La mayoría pide ver un commit antiguo al azar. Un commit es un único cambio registrado en el código, y el sitio tiene que construir una página web para cada uno bajo demanda.
Ese trabajo se acumula. Ryabitsev escribe que entre 14 y 16 de los 90 núcleos de procesador del sitio están ocupados en todo momento sin hacer otra cosa que generar páginas de commits para los rastreadores. Eso es aproximadamente una quinta parte de toda la capacidad del sistema, repartida entre cinco servidores en distintas partes del mundo.
Su resumen es rotundo. "We spend more CPU cycles rendering commits for scrapers than we spend on all other kinds of legitimate access, including git clones", escribió: se gastan más ciclos de procesador en los rastreadores que en todos los accesos legítimos juntos, clones incluidos.
La página de verificación no los detiene
kernel.org ya ejecuta Anubis, desplegado hace aproximadamente un año. Anubis es una barrera de prueba de trabajo. Antes de servir una página, obliga al navegador del visitante a resolver un pequeño problema matemático. Para una persona es trivial; para un programa que descarga millones de páginas, es caro.
Funciona, en parte. Ryabitsev informa de que Anubis rechaza de entrada al 66 % de los rastreadores. Pero el 33 % ya resuelve el problema y cruza la barrera igualmente. Pagar el coste de cálculo parece merecer la pena para quien recopila los datos.
Por qué bloquear direcciones IP no sirve
La solución obvia sería bloquear las direcciones infractoras. Según el informe de LWN, aquí falla. Los rastreadores operan a través de proxies residenciales, que enrutan las peticiones por conexiones domésticas corrientes alquiladas a proveedores como Bright Data. Cada petición llega desde la dirección de un hogar distinto, así que una lista de bloqueo nunca alcanza el ritmo.
Distinguir a los dos grupos es el problema más difícil. "It's impossible to tell with certainty which of these are bots and which are real humans", escribió Ryabitsev: es imposible saber con certeza cuáles son bots y cuáles humanos reales. Su regla práctica es buena. Quien pide un commit antiguo en un fork antiguo elegido al azar probablemente no es un desarrollador haciendo su trabajo.
Los comentaristas en Lobsters señalaron que ClaudeBot, el rastreador de Anthropic, aparece de forma destacada en los registros de los servidores git expuestos. Un lector señaló el desperdicio por ambos lados. Los rastreadores eligen, en sus palabras, "the stupidest possible way of doing it - by rendering everything as HTML commit by commit and then parsing it": la forma más tonta posible, generar todo como HTML commit a commit y luego analizarlo.
Qué significa esto para los desarrolladores
Si alojas un servidor git público, da por hecho que ya te está pasando. Las cifras del núcleo son extremas porque el núcleo es famoso, pero los rastreadores no seleccionan. Comprueba qué proporción de tu tráfico pide URL profundas de commits en lugar de clones. Esa proporción es la señal.
Sirve el camino barato en lugar del caro. Un git clone es una única transferencia eficiente. Un rastreador que recorre todas las páginas de commits obliga a tu servidor a generar miles de documentos. Limitar la frecuencia de la vista web, dejando intactos el clonado y el fetch, protege el presupuesto sin bloquear el trabajo real.
Espera que las páginas de verificación se extiendan, y que te molesten. Anubis y herramientas similares ya se sitúan delante de muchos sitios de proyectos de código abierto. Cuando un script de compilación o un trabajo de integración continua falla de repente al descargar un parche, una barrera de prueba de trabajo es una causa probable. Apunta la automatización al protocolo git o a un espejo, no a la interfaz web.
El fondo del asunto es una cuestión de financiación. Una infraestructura sostenida por voluntarios está absorbiendo el coste de una recogida de datos de entrenamiento que nunca aceptó suministrar. Nadie factura a los rastreadores, así que la factura cae sobre los proyectos.
Fuentes
- Creepy crawlies - people.kernel.org
- Ryabitsev: Creepy crawlies - LWN.net
Artículos relacionados
Jemalloc 5.4.0 llega con 160 commits tras el regreso de Meta
La primera versión de jemalloc desde que Meta renovó su inversión trae más de 160 commits, una nueva capa de abstracción del sistema y selección de arena por CPU.
Kubernetes 1.37 pasa el modo rootless a beta
Kubernetes 1.37 pasa KubeletInUserNamespace a beta. El kubelet, los runtimes de contenedores, los plugins CNI y kube-proxy ya pueden ejecutarse como usuario corriente.
Hugging Face abre reservas del robot Microduck de código abierto por 399 dólares
Hugging Face acepta reservas de 399 dólares para Microduck, un robot que camina de 25 cm. Todo el stack de aprendizaje por refuerzo se publica bajo Apache 2.0, así que puedes reentrenarlo.