kernel.org: Nur 2 % des Git-Traffics stammen von echten Entwicklern
Konstantin Ryabitsev veröffentlichte am 29. August 2026 harte Zahlen: git.kernel.org erhält 6 Millionen Anfragen am Tag, davon wirken nur rund 2 % menschlich.
3 Min. Lesezeit
Die Zahlen
- requests a day to git.kernel.org
- 6M
- of that traffic judged legitimate
- 2%
- of scrapers blocked by the challenge
- 66%
Nur etwa 2 % des Traffics auf git.kernel.org sehen nach einem echten Entwickler aus. Konstantin Ryabitsev veröffentlichte diese Schätzung am 29. August 2026 in einem Beitrag mit dem Titel "Creepy crawlies". Der Rest sind KI-Scraper, und sie kosten die Infrastruktur des Linux-Kernels inzwischen mehr Rechenleistung als alle legitimen Zugriffe zusammen.
Ryabitsev ist laut LWN.net der Maintainer der Kernel-Infrastruktur. Er betreibt git.kernel.org, die öffentliche Website, auf der sich die Versionsgeschichte des Linux-Kernels im Browser durchsehen lässt.
Die Zahlen hinter der Aussage
Die Seite erhält rund 6 Millionen Anfragen pro Tag. Die meisten davon fragen einen zufälligen alten Commit ab. Ein Commit ist eine einzelne festgehaltene Änderung am Code, und die Seite muss für jeden davon auf Anfrage eine Webseite erzeugen.
Diese Arbeit summiert sich. Ryabitsev schreibt, dass jederzeit 14 bis 16 der 90 Prozessorkerne der Seite ausschließlich damit beschäftigt sind, Commits für Scraper zu rendern. Das ist etwa ein Fünftel der gesamten Systemkapazität, verteilt auf fünf Server in verschiedenen Weltregionen.
Sein Fazit fällt deutlich aus. "We spend more CPU cycles rendering commits for scrapers than we spend on all other kinds of legitimate access, including git clones", schrieb er - man verbrauche mehr Rechenzyklen für Scraper als für alle legitimen Zugriffe zusammen, Klone eingeschlossen.
Die Prüfseite hält sie nicht auf
kernel.org betreibt bereits Anubis, seit etwa einem Jahr. Anubis ist eine Proof-of-Work-Schranke. Bevor eine Seite ausgeliefert wird, lässt sie den Browser des Besuchers ein kleines Rechenrätsel lösen. Für einen Menschen ist das belanglos, für ein Programm mit Millionen Seitenabrufen teuer.
Es wirkt, aber nur teilweise. Ryabitsev berichtet, dass Anubis 66 % der Scraper direkt abweist. Doch 33 % lösen das Rätsel inzwischen und gehen einfach durch die Schranke. Die Rechenkosten zu zahlen lohnt sich offenbar für denjenigen, der die Daten sammelt.
Warum das Sperren von IP-Adressen nicht funktioniert
Die naheliegende Lösung wäre, die auffälligen Adressen zu sperren. Laut dem Bericht von LWN scheitert das hier. Die Scraper laufen über Residential Proxies, die Anfragen über gewöhnliche private Internetanschlüsse leiten, gemietet bei Anbietern wie Bright Data. Jede Anfrage kommt von einer anderen Haushaltsadresse, sodass eine Sperrliste nie hinterherkommt.
Das schwierigere Problem ist, beide Gruppen auseinanderzuhalten. "It's impossible to tell with certainty which of these are bots and which are real humans", schrieb Ryabitsev - mit Sicherheit lasse sich nicht sagen, was Bot und was Mensch sei. Seine Faustregel ist gut: Wer einen alten Commit in einem zufälligen alten Fork abruft, ist vermutlich kein Entwickler bei der Arbeit.
Kommentatoren auf Lobsters wiesen darauf hin, dass ClaudeBot, der Crawler von Anthropic, in den Proxy-Logs offener Git-Server prominent auftaucht. Ein Leser benannte die Verschwendung auf beiden Seiten. Die Scraper wählten, wie er es formulierte, "the stupidest possible way of doing it - by rendering everything as HTML commit by commit and then parsing it": den denkbar dümmsten Weg, alles Commit für Commit als HTML rendern zu lassen und dann zu parsen.
Was das für Entwickler bedeutet
Wer einen öffentlichen Git-Server betreibt, sollte davon ausgehen, dass es ihm bereits so ergeht. Die Zahlen des Kernels sind extrem, weil der Kernel berühmt ist, doch die Crawler sind nicht wählerisch. Prüfen Sie, welcher Anteil Ihres Traffics tiefe Commit-URLs statt Klone anfragt. Dieses Verhältnis ist das Warnzeichen.
Bieten Sie den günstigen Weg statt des teuren an. Ein git clone ist eine einzige effiziente Übertragung. Ein Scraper, der jede Commit-Seite abläuft, zwingt Ihren Server dagegen zu Tausenden von Dokumenten. Ein Rate-Limit auf die Weboberfläche schützt das Budget, während Klonen und Abrufen unangetastet bleiben und echte Arbeit möglich ist.
Rechnen Sie mit mehr Prüfseiten, und rechnen Sie damit, dass sie stören. Anubis und ähnliche Werkzeuge stehen inzwischen vor vielen Open-Source-Projektseiten. Wenn ein Build-Skript oder ein CI-Job plötzlich einen Patch nicht mehr laden kann, ist eine Proof-of-Work-Schranke eine wahrscheinliche Ursache. Richten Sie Automatisierung auf das Git-Protokoll oder einen Spiegel aus, nicht auf die Weboberfläche.
Der tiefere Punkt betrifft die Finanzierung. Ehrenamtlich betriebene Infrastruktur trägt die Kosten einer Datensammlung für KI-Training, der sie nie zugestimmt hat. Niemand stellt den Crawlern eine Rechnung, also landet sie bei den Projekten.
Quellen
- Creepy crawlies - people.kernel.org
- Ryabitsev: Creepy crawlies - LWN.net
Ähnliche Artikel
Jemalloc 5.4.0 bringt 160 Commits nach Metas Neustart
Die erste jemalloc-Version seit Metas erneuertem Engagement bringt über 160 Commits, eine neue Betriebssystem-Abstraktionsschicht und Arena-Auswahl pro CPU.
Kubernetes 1.37 hebt den Rootless-Modus auf Beta
Kubernetes 1.37 setzt KubeletInUserNamespace auf Beta. Kubelet, Container-Runtimes, CNI-Plugins und kube-proxy können nun alle als normaler Benutzer laufen.
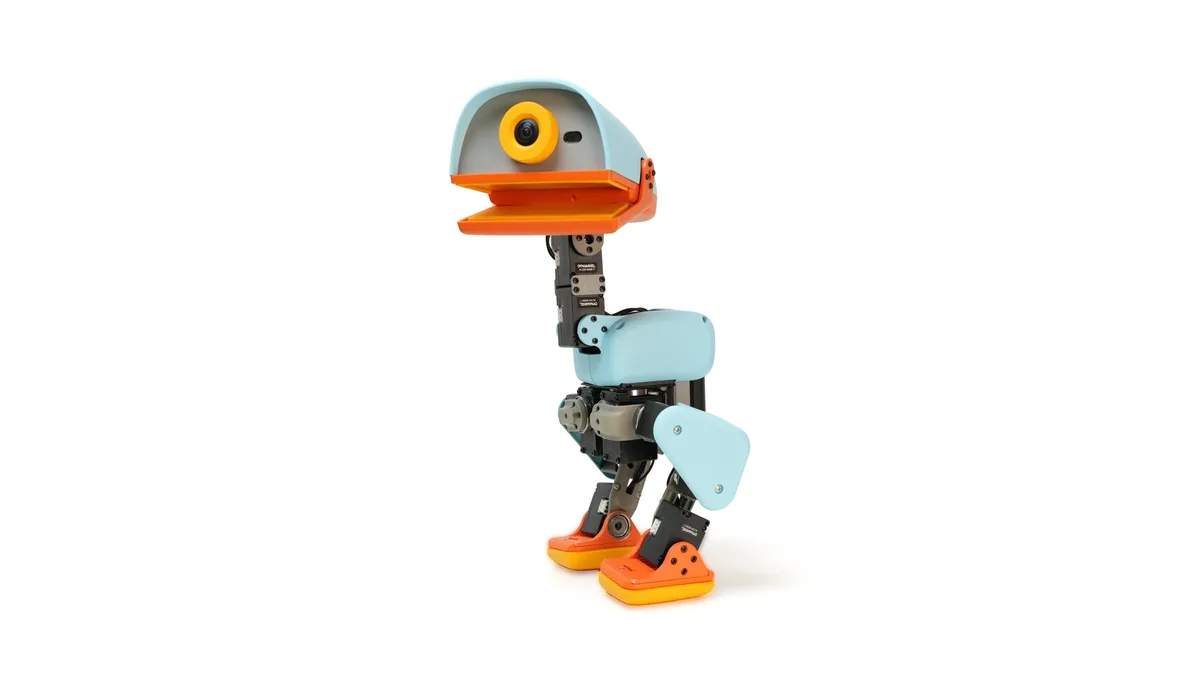
Hugging Face startet Vorbestellungen: Open-Source-Roboter Microduck für 399 Dollar
Hugging Face nimmt Vorbestellungen für Microduck an, einen 25 cm großen Laufroboter für 399 Dollar. Der komplette Reinforcement-Learning-Stack steht unter Apache 2.0. Sie können ihn also neu trainieren.