kernel.org : à peine 2 % de son trafic git vient de vrais développeurs
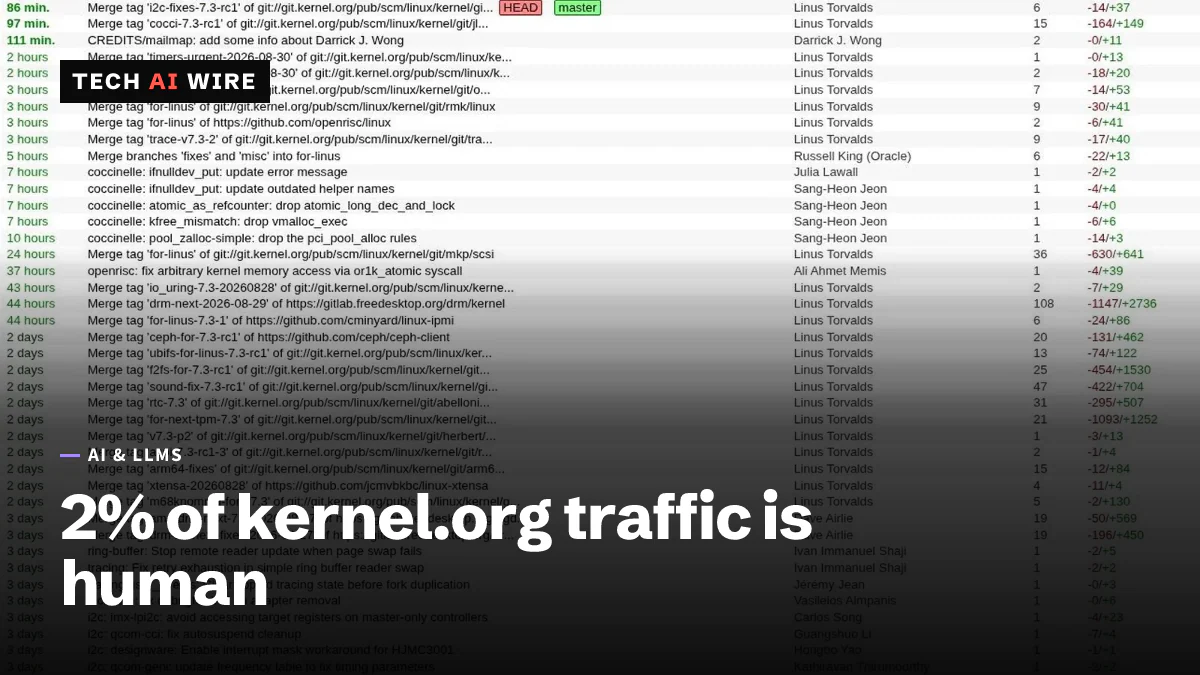
Konstantin Ryabitsev a publié des chiffres précis le 29 août 2026 : git.kernel.org reçoit 6 millions de requêtes par jour, dont environ 2 % seulement semblent humaines.
3 min de lecture
En chiffres
- requests a day to git.kernel.org
- 6M
- of that traffic judged legitimate
- 2%
- of scrapers blocked by the challenge
- 66%
Environ 2 % seulement du trafic qui arrive sur git.kernel.org ressemble à un vrai développeur. Konstantin Ryabitsev a publié cette estimation le 29 août 2026, dans un billet intitulé "Creepy crawlies". Le reste, ce sont des robots d'aspiration au service de l'IA. Ils coûtent désormais à l'infrastructure du noyau Linux plus de puissance de calcul que tous les usages légitimes réunis.
Ryabitsev est le mainteneur de l'infrastructure du noyau, selon la description qu'en donne LWN.net. Il administre git.kernel.org, le site public qui permet à quiconque de parcourir l'historique du code source de Linux dans un navigateur.
Les chiffres derrière l'affirmation
Le site reçoit environ 6 millions de requêtes par jour. La plupart demandent à voir un vieux commit pris au hasard. Un commit est une modification enregistrée du code, et le site doit construire une page web pour chacune, à la demande.
Ce travail s'accumule. Ryabitsev écrit que 14 à 16 des 90 cœurs de processeur du site sont occupés à tout moment à ne faire qu'une chose : produire des pages de commits pour des robots. Cela représente près d'un cinquième de la capacité totale, répartie sur cinq serveurs situés dans différentes régions du monde.
Son résumé est direct. "We spend more CPU cycles rendering commits for scrapers than we spend on all other kinds of legitimate access, including git clones", a-t-il écrit : le site dépense plus de cycles processeur pour les robots que pour tous les accès légitimes réunis, clones compris.
La page de vérification ne les arrête pas
kernel.org fait déjà tourner Anubis, déployé il y a environ un an. Anubis est une barrière à preuve de travail. Avant de servir une page, elle fait résoudre au navigateur du visiteur une petite énigme mathématique. L'exercice est insignifiant pour une personne et coûteux pour un programme qui récupère des millions de pages.
Cela fonctionne, en partie. Ryabitsev indique qu'Anubis repousse d'emblée 66 % des robots. Mais 33 % résolvent désormais l'énigme et franchissent la barrière. Payer le coût de calcul en vaut visiblement la peine pour ceux qui collectent les données.
Pourquoi bloquer des adresses IP ne marche pas
La solution évidente serait de bloquer les adresses fautives. D'après le compte rendu de LWN, elle échoue ici. Les robots passent par des proxys résidentiels, qui acheminent les requêtes via des connexions internet de particuliers, louées auprès de fournisseurs comme Bright Data. Chaque requête arrive d'une adresse domestique différente, si bien qu'une liste de blocage ne rattrape jamais son retard.
Distinguer les deux groupes est le problème le plus difficile. "It's impossible to tell with certainty which of these are bots and which are real humans", écrit Ryabitsev : impossible de dire avec certitude qui est un robot et qui est un humain. Sa règle empirique est bonne. Une requête pour un vieux commit dans un vieux fork choisi au hasard n'émane probablement pas d'un développeur au travail.
Des commentateurs sur Lobsters ont noté que ClaudeBot, le robot d'Anthropic, apparaît en bonne place dans les journaux des serveurs git exposés. Un lecteur a pointé le gaspillage des deux côtés. Les robots choisissent, selon ses mots, "the stupidest possible way of doing it - by rendering everything as HTML commit by commit and then parsing it" : la méthode la plus stupide possible, faire produire tout le HTML commit par commit puis l'analyser.
Ce que cela signifie pour les développeurs
Si vous hébergez un serveur git public, partez du principe que cela vous arrive déjà. Les chiffres du noyau sont extrêmes parce que le noyau est célèbre, mais les robots ne trient pas. Regardez quelle part de votre trafic demande des URL de commits profondes plutôt que des clones. Ce rapport est le signal.
Servez le chemin économique plutôt que le chemin coûteux. Un git clone est un transfert unique et efficace. Un robot qui parcourt chaque page de commit force votre serveur à produire des milliers de documents. Limiter le débit de l'interface web, tout en laissant le clone et le fetch intacts, protège le budget sans bloquer le vrai travail.
Attendez-vous à voir ces pages de vérification se multiplier, et à ce qu'elles vous agacent. Anubis et ses équivalents se trouvent désormais devant de nombreux sites de projets open source. Quand un script de compilation ou une tâche d'intégration continue échoue soudain à récupérer un correctif, une barrière à preuve de travail en est une cause probable. Dirigez vos automatisations vers le protocole git ou un miroir, pas vers l'interface web.
Le fond du problème est une question de financement. Une infrastructure tenue par des bénévoles absorbe le coût d'une collecte de données d'entraînement qu'elle n'a jamais accepté de fournir. Personne ne facture les robots, donc la facture revient aux projets.
Sources
- Creepy crawlies - people.kernel.org
- Ryabitsev: Creepy crawlies - LWN.net
Articles liés
Jemalloc 5.4.0 apporte 160 commits après le retour de Meta
La première version de jemalloc depuis le réinvestissement de Meta apporte plus de 160 commits, une couche d'abstraction système et la sélection d'arène par CPU.
Kubernetes 1.37 fait passer le mode rootless en bêta
Kubernetes 1.37 fait passer KubeletInUserNamespace en bêta. Le kubelet, les runtimes de conteneurs, les plugins CNI et kube-proxy peuvent tous tourner en utilisateur ordinaire.
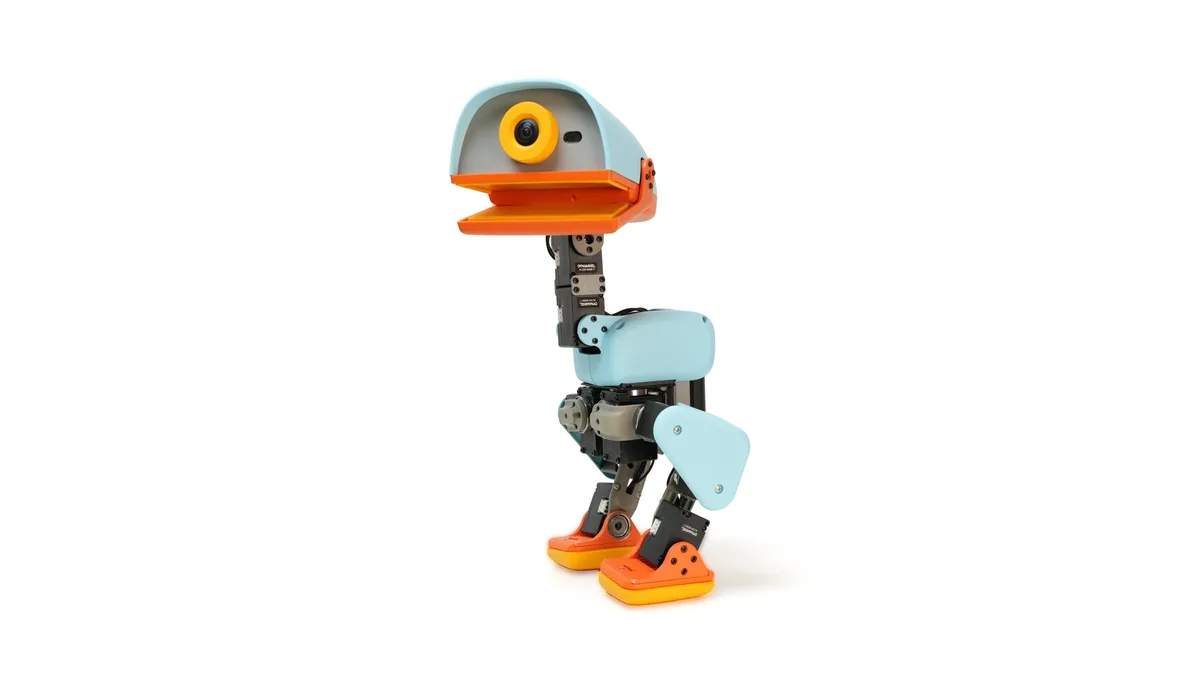
Hugging Face ouvre les précommandes du robot open source Microduck à 399 dollars
Hugging Face prend des précommandes à 399 dollars pour Microduck, un robot marcheur de 25 cm. Toute la pile d'apprentissage par renforcement est publiée sous Apache 2.0, donc vous pouvez le réentraîner.