GitHub Copilot Fusion chega a todos: uma escolha, vários modelos
O GitHub Copilot Fusion está disponível para todos. Ele escolhe e combina modelos por tarefa, e o GitHub diz que o Fusion Max se iguala aos melhores agentes por cerca de metade do custo.
Por Claire Whitmore
4 min de leitura
Traduzido automaticamente do original em inglês, que Claire Whitmore verificou e editou. Prevalece a versão em inglês. Como trabalhamos
Em números
- Fusion Max score on the Artificial Analysis Coding Agent Index
- 60
- lower average API cost per task than the top agent, per GitHub
- ~50%
- less time per task, per GitHub
- ~40%
- limited-time discount on model costs for paid plans
- 30%
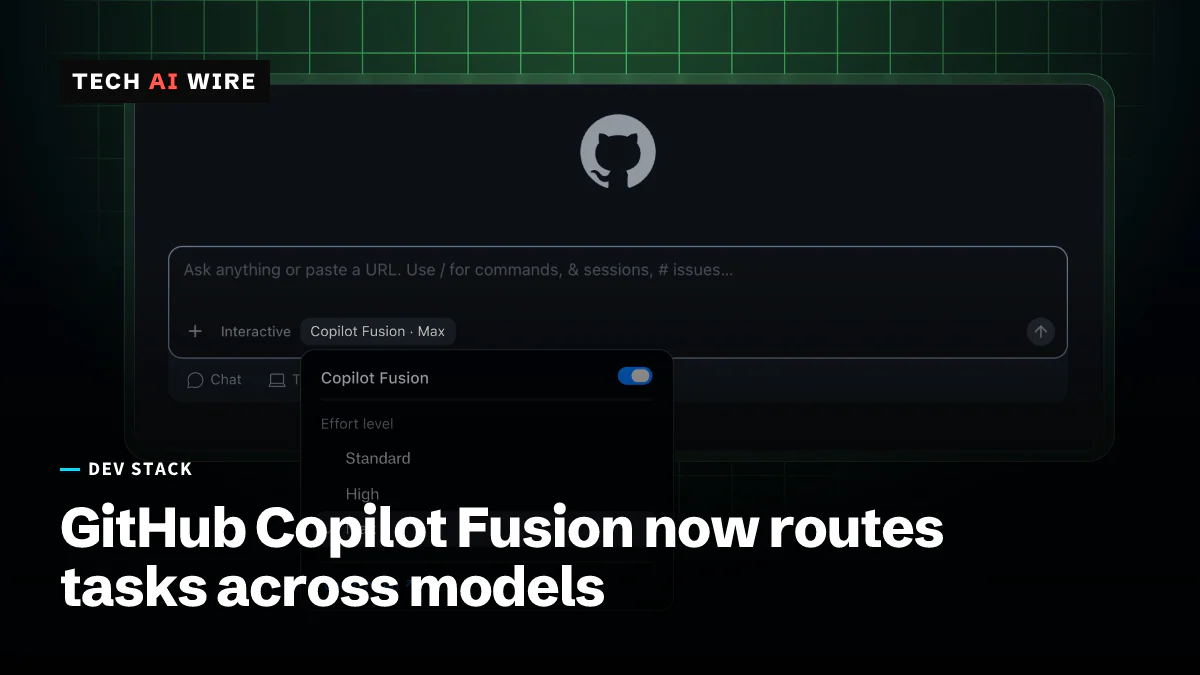
O GitHub tornou o Copilot Fusion disponível para todos em 28 de outubro de 2026. Em vez de escolher um único modelo de IA para uma tarefa de programação, os desenvolvedores podem escolher o Fusion e deixar que o próprio Copilot selecione os modelos, e às vezes os combine. Segundo o changelog do GitHub, o nível mais alto fica a no máximo dois pontos do melhor agente de programação em um benchmark, por cerca de metade do custo.
O Copilot é o assistente de programação com IA do GitHub. Até agora, a maioria dos usuários escolhia um modelo manualmente ou deixava uma configuração "auto" escolher um modelo por tarefa.
O que o Copilot Fusion faz
O Fusion é a versão final do Project HydraFusion, que o GitHub lançou como prévia de pesquisa em 4 de setembro. O GitHub diz que o produto combina a orquestração multimodelo do HydraFusion com a seleção automática de modelos que o Copilot já tinha.
Um roteador fica na frente dos modelos. Para cada prompt, ele decide qual modelo ou quais modelos devem cuidar do trabalho. O Fusion vem em três níveis de esforço, chamados Standard, High e Max.
Ele está disponível no VS Code, no app GitHub Copilot, na Copilot CLI e nas IDEs da JetBrains. Os administradores decidem quais modelos o Fusion pode usar por meio de políticas de modelos. Eles também podem tornar o Fusion a opção padrão da organização.
Como o roteamento funciona
Segundo o GitHub, o Fusion envia cada tarefa por um de três caminhos.
| Padrão | O que acontece |
|---|---|
| Single | Um modelo resolve a tarefa diretamente. |
| Cascade | Um modelo mais barato faz um rascunho da resposta. Uma verificação de qualidade aceita o resultado ou o escala para um modelo mais forte. |
| Critique | Um modelo faz o rascunho, um segundo modelo revisa e o primeiro modelo corrige. |
O TechTarget explicou como o roteador escolhe. Ele se baseia no HyDRA, um framework já existente do GitHub que avalia as tarefas em raciocínio, geração de código, depuração e uso de ferramentas. Essas avaliações decidem qual padrão cada tarefa recebe.
O padrão Critique tem um detalhe que vale conhecer. Durante a prévia, o InfoQ informou que o revisor não tem acesso a ferramentas e vem de outra família de modelos. Esse desenho torna menos provável que dois modelos parecidos concordem com o mesmo erro.
Os números de benchmark e custo
O número principal do GitHub vem do Artificial Analysis Coding Agent Index, um ranking externo de agentes de programação com IA. O Fusion Max marcou 60. Isso fica a no máximo dois pontos do Claude Code rodando o Opus 5.5 Max, segundo o GitHub.
O GitHub diz que o Fusion fez isso "por cerca de metade do custo médio de API por tarefa, usando cerca de metade dos tokens e levando cerca de 40% menos tempo por tarefa". São números do próprio GitHub para um único índice. Não são um teste independente do Fusion no seu código.
A prévia tinha feito afirmações parecidas em outros testes. O InfoQ informou que, no TerminalBench 2.1, o HydraFusion melhorou a qualidade das tarefas verificadas em 4,9 pontos percentuais. Ele também reduziu o custo estimado em 67% em comparação com o Claude Opus 5. No CheckpointBench, um teste interno do GitHub criado a partir de sessões reais do Copilot, a pontuação ficou a no máximo 0,1 ponto do Opus 5, com custo estimado 65% menor.
Os primeiros clientes apontam o mesmo benefício. Hari Pokhrel, engenheiro de software principal da AT&T, disse que o Fusion Standard "melhorou a eficiência de tokens em toda a AT&T" ao escolher o modelo certo para cada tarefa.
Como funciona a cobrança
O Fusion não tem uma tarifa fixa. "Quando você usa o Copilot Fusion, é cobrado por cada modelo que ele usa, pela tarifa padrão de cada modelo", diz o changelog.
Isso importa nos padrões Cascade e Critique, em que uma única tarefa pode passar por dois ou três modelos. Por tempo limitado, usuários de planos pagos do Copilot recebem 30% de desconto nos custos de modelos. O GitHub não disse quando o desconto termina.
A escolha de modelos dentro do Copilot vem mudando rápido. O GitHub aposentou seis modelos do Copilot no início deste mês, o que obrigou equipes com nomes de modelos fixados a trocar.
O que isso significa para os desenvolvedores
A proposta é simples: pare de escolher modelos e deixe o GitHub fazer isso. Se isso economiza dinheiro depende do seu trabalho, então meça em vez de confiar no benchmark.
- Faça um teste lado a lado. Escolha uma semana de tarefas típicas e compare o Fusion Standard com o modelo que você usa hoje. Acompanhe tokens, tempo e com que frequência você aceita o resultado.
- Olhe a fatura, não a tabela de preços. O Fusion cobra cada modelo que chama. Uma execução Critique pode custar mais do que um único modelo forte em uma tarefa curta, mesmo que custe menos na média.
- Defina as políticas de modelos primeiro. Os administradores devem decidir para quais modelos o Fusion pode rotear antes de torná-lo o padrão. Isso mantém intactas as regras de dados e as aprovações de fornecedores.
- Use o período de desconto para aprender. O desconto de 30% é temporário. Colete seus próprios dados de custo enquanto ele durar, para conhecer seus números reais quando ele acabar.
- Espere fixar menos modelos. Com listas de modelos mudando a cada poucas semanas, o roteamento reduz o trabalho de atualizar scripts e configurações. Esse benefício é fácil de ignorar e difícil de medir.
Analistas defendem essa direção há algum tempo. "Estamos aprendendo rapidamente que a economia de usar LLMs para toda tarefa de programação muitas vezes não funciona", disse Torsten Volk, da Omdia, ao TechTarget. O Fusion é a resposta do GitHub a esse problema, e seus dados de uso vão mostrar se ele serve para a sua equipe.
Fontes
Artigos relacionados
ChatGPT e Codex vão dividir um único limite de uso a partir de dezembro
A partir de dezembro, os planos Plus, Pro e Business do ChatGPT vão descontar o uso do ChatGPT e do Codex de uma única cota. Só os chats com Instant ficam de fora.
Vendas do Gemini Code Assist acabam; o Antigravity assume
O Google parou de vender o Gemini Code Assist Standard e Enterprise em 9 de outubro. Licenças podem ser adicionadas até 31 de janeiro de 2027, e o Antigravity o substitui.
Nanbeige4.3-33B: modelo aberto supera o Qwen em programação com agentes
O laboratório Nanbeige, da BOSS Zhipin, lançou o Nanbeige4.3-33B sob Apache 2.0 e afirma ter 80,9 no Terminal-Bench 2.1, contra 73,0 do Qwen3.8-27B.