GitHub Copilot Fusionが一般提供開始、1回の選択で複数モデルを振り分け
GitHubのCopilot Fusion(コパイロット フュージョン)が一般提供になりました。タスクごとにモデルを選び、組み合わせます。GitHubによると、Fusion Maxはトップクラスのエージェントに並ぶ性能を約半分のコストで実現しています。
4 分で読めます
英語の原文から機械翻訳したものです。原文はClaire Whitmoreが事実確認と編集を行いました。内容に相違がある場合は英語版が優先されます。 編集方針
数字で見る
- Fusion Max score on the Artificial Analysis Coding Agent Index
- 60
- lower average API cost per task than the top agent, per GitHub
- ~50%
- less time per task, per GitHub
- ~40%
- limited-time discount on model costs for paid plans
- 30%
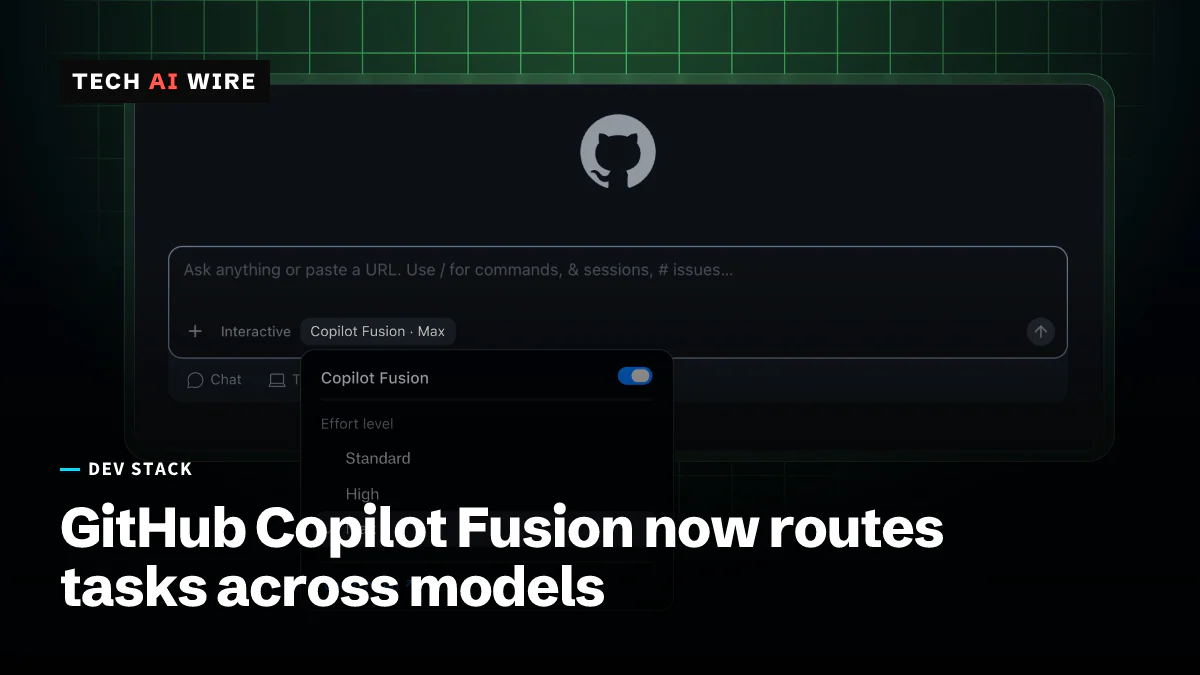
GitHubは2026年10月28日、Copilot Fusionを一般提供しました。開発者はコーディング作業ごとにAIモデルを1つ選ぶ代わりに、Fusionを選んで、Copilot自身にモデルを選ばせることができます。場合によっては、Copilotが複数のモデルを組み合わせます。GitHubの変更履歴(Changelog)によると、最上位のティアは、あるベンチマークで最高のコーディングエージェントとの差が2ポイント以内に収まり、コストは約半分です。
CopilotはGitHubのAIコーディングアシスタントです。これまでほとんどのユーザーは、モデルを手動で選ぶか、「auto」設定に作業ごとに1つのモデルを選ばせていました。
Copilot Fusionでできること
Fusionは、GitHubが9月4日にリサーチプレビューとして公開したProject HydraFusionの完成版です。GitHubによると、この製品はHydraFusionのマルチモデル・オーケストレーションと、Copilotの既存の自動モデル選択を組み合わせたものです。
モデルの手前にはルーターがあります。ルーターはプロンプトごとに、どのモデル(1つまたは複数)が作業を担当するかを決めます。Fusionには、Standard、High、Maxという3つのエフォート(処理の手厚さ)のティアがあります。
FusionはVS Code、GitHub Copilotアプリ、Copilot CLI、JetBrains IDEで利用できます。管理者はモデルポリシーを通じて、Fusionが使えるモデルを決めます。Fusionを組織のデフォルトの選択肢に設定することもできます。
ルーティングの仕組み
GitHubによると、Fusionは各タスクを3つの経路のいずれかに振り分けます。
| パターン | 何が起きるか |
|---|---|
| Single | 1つのモデルがタスクを直接解きます。 |
| Cascade | 安価なモデルが回答の下書きを作ります。品質チェックがそれを採用するか、より強力なモデルに引き継ぎます。 |
| Critique | 1つのモデルが下書きを作り、2つ目のモデルがレビューし、最初のモデルが修正します。 |
TechTargetは、ルーターがどのように選ぶかを説明しています。ルーターは、GitHubの既存のフレームワークであるHyDRAを土台にしています。HyDRAは、推論、コード生成、デバッグ、ツール利用の観点でタスクを評価します。その評価によって、タスクにどのパターンを割り当てるかが決まります。
Critiqueパターンには、知っておきたい点が1つあります。プレビュー期間中、InfoQは、レビュー役のモデルはツールにアクセスできず、別のモデルファミリーから選ばれると報じました。この設計により、似た2つのモデルが同じ間違いに同意してしまう可能性が低くなります。
ベンチマークとコストに関する主張
GitHubが掲げる主要な数字は、AIコーディングエージェントの外部ランキングであるArtificial Analysis Coding Agent Indexによるものです。Fusion Maxのスコアは60でした。GitHubによると、これはOpus 5.5 Maxを使うClaude Codeとの差が2ポイント以内です。
GitHubは、Fusionがこれを「タスクあたりの平均APIコストの約半分で、約半分のトークン数を使い、タスクあたりの時間を約40%短縮して」達成したとしています。これは単一の指標に関するGitHub自身の数字です。皆さんのコードでFusionを独立して検証したものではありません。
プレビューでも、ほかのテストで同様の主張がありました。InfoQによると、HydraFusionはTerminalBench 2.1で、検証済みタスクの品質を4.9パーセントポイント改善しました。また、Claude Opus 5と比べて推定コストを67%削減しました。実際のCopilotのセッションをもとに作られたGitHubの社内テストであるCheckpointBenchでは、スコアがOpus 5との差0.1ポイント以内で、推定コストは65%低くなりました。
初期の顧客も同じ利点を挙げています。AT&Tのプリンシパル・ソフトウェアエンジニアであるHari Pokhrel氏は、Fusion Standardがタスクごとに適切なモデルを選ぶことで「AT&T全体でトークン効率を改善した」と述べました。
課金の仕組み
Fusionは定額料金ではありません。変更履歴には「Copilot Fusionを使うと、使用した各モデルについて、それぞれのモデルの標準料金で課金されます」とあります。
これはCascadeとCritiqueのパターンで重要になります。1つのタスクで2つか3つのモデルが使われることがあるからです。期間限定で、有料のCopilotプランのユーザーは、モデルのコストが30%割引になります。GitHubは、割引がいつ終わるかを明らかにしていません。
Copilotで使えるモデルは、急速に変わってきています。GitHubは今月初め、Copilotから6つのモデルを廃止しました。これにより、モデル名を固定していたチームは切り替えを迫られました。
開発者にとっての意味
売り文句はシンプルです。モデルを選ぶのをやめて、GitHubに任せるというものです。費用を節約できるかどうかは作業内容によるため、ベンチマークを信じるのではなく、自分で測定してください。
- 並べて比較するテストを行う。 典型的な作業を1週間分選び、Fusion Standardと今使っているモデルを比べます。トークン数、時間、そして結果をどのくらいの頻度で採用したかを記録します。
- 価格表ではなく請求額を見る。 Fusionは呼び出したすべてのモデルについて課金します。Critiqueの実行は、平均では安くても、短いタスクでは強力なモデル1つより高くつくことがあります。
- 先にモデルポリシーを設定する。 管理者は、Fusionをデフォルトにする前に、Fusionがどのモデルに振り分けてよいかを決めておくべきです。そうすれば、データに関するルールやベンダーの承認がそのまま守られます。
- 割引期間を学習に使う。 30%の割引は一時的なものです。割引がある間に自分たちのコストデータを集めておけば、割引が終わったときに実際の数字が分かります。
- モデルの固定が減ると見込む。 モデルの一覧が数週間ごとに変わる中、ルーティングによってスクリプトや設定を更新する手間が減ります。この利点は見落としやすく、測定もしにくいものです。
アナリストは以前からこの方向性を主張してきました。OmdiaのTorsten Volk氏はTechTargetに対し、「あらゆるコーディング作業にLLMを使う経済性は、多くの場合成り立たないことが急速に分かってきています」と語りました。Fusionはこの問題に対するGitHubの答えです。自分のチームに合うかどうかは、利用データが示してくれるでしょう。
出典
関連記事
ChatGPTとCodex、12月から1つの利用上限を共有
12月から、ChatGPTのPlus、Pro、Businessプランでは、ChatGPTとCodex(コーデックス)の利用が1つの枠から差し引かれます。対象外はInstantのチャットだけです。
Gemini Code Assistの販売終了、Antigravityが後継に
Googleは10月9日、Gemini Code Assist(ジェミニ・コード・アシスト)のStandardとEnterpriseの販売を終了しました。ライセンスは2027年1月31日まで追加でき、後継はAntigravityです。
Nanbeige4.3-33B、エージェント型コーディングでQwenを上回るオープンモデル
BOSS ZhipinのNanbeigeラボが、エージェント型コーディング向けのNanbeige4.3-33BをApache 2.0で公開しました。Terminal-Bench 2.1で80.9を記録し、Qwen3.8-27Bの73.0を上回ったとしています。