GitHub Copilot Fusion est disponible : un seul choix, plusieurs modèles
GitHub Copilot Fusion est disponible pour tous. Il choisit et combine des modèles selon la tâche, et GitHub affirme que Fusion Max égale les meilleurs agents pour environ la moitié du coût.
Par Claire Whitmore
4 min de lecture
Traduit automatiquement de l'original anglais, vérifié et édité par Claire Whitmore. La version anglaise fait foi. Notre méthode
En chiffres
- Fusion Max score on the Artificial Analysis Coding Agent Index
- 60
- lower average API cost per task than the top agent, per GitHub
- ~50%
- less time per task, per GitHub
- ~40%
- limited-time discount on model costs for paid plans
- 30%
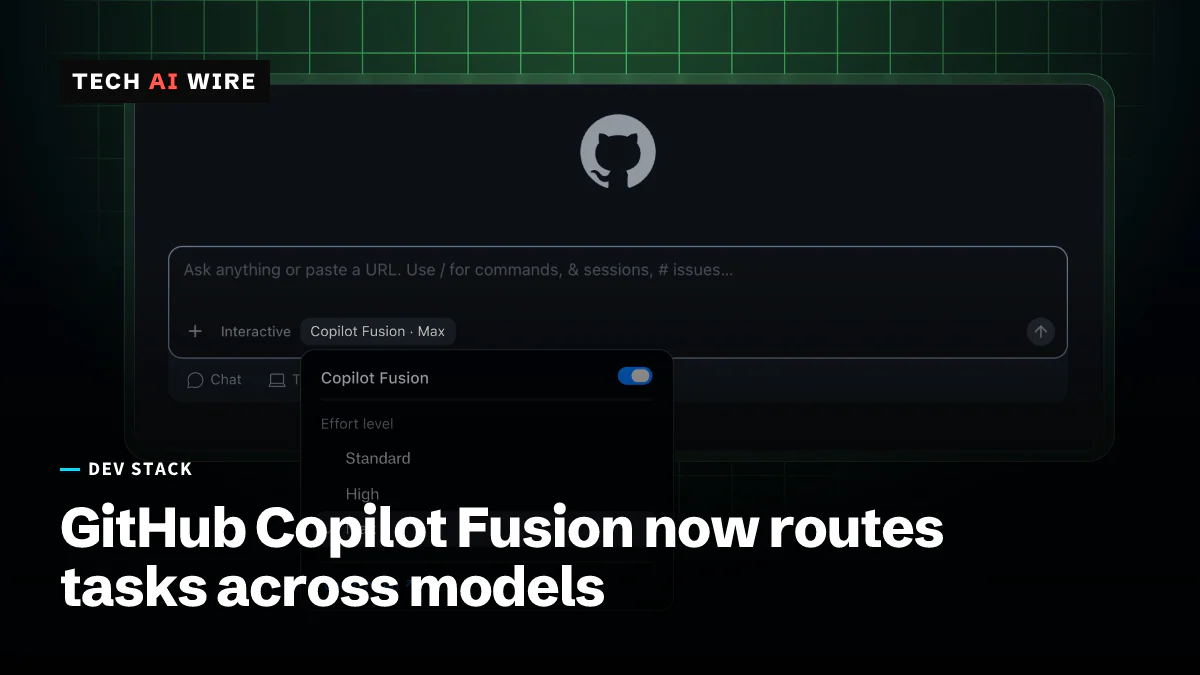
GitHub a rendu Copilot Fusion disponible pour tous le 28 octobre 2026. Au lieu de choisir un seul modèle d'IA pour une tâche de programmation, les développeurs peuvent choisir Fusion et laisser Copilot sélectionner lui-même les modèles, et parfois les combiner. Selon le changelog de GitHub, son niveau le plus élevé se place à deux points au plus du meilleur agent de code sur un benchmark, pour environ la moitié du coût.
Copilot est l'assistant de programmation par IA de GitHub. Jusqu'ici, la plupart des utilisateurs choisissaient un modèle à la main ou laissaient un réglage « auto » choisir un modèle par tâche.
Ce que fait Copilot Fusion
Fusion est la version finale de Project HydraFusion, que GitHub avait lancé en préversion de recherche le 4 septembre. Selon GitHub, le produit combine l'orchestration multimodèle de HydraFusion avec la sélection automatique de modèle déjà présente dans Copilot.
Un routeur se place devant les modèles. Pour chaque prompt, il décide quel modèle ou quels modèles doivent traiter le travail. Fusion existe en trois niveaux d'effort, appelés Standard, High et Max.
Il est disponible dans VS Code, l'application GitHub Copilot, la Copilot CLI et les IDE JetBrains. Les administrateurs décident, via des politiques de modèles, quels modèles Fusion peut utiliser. Ils peuvent aussi faire de Fusion le choix par défaut de leur organisation.
Comment fonctionne le routage
Selon GitHub, Fusion envoie chaque tâche sur l'un de trois chemins.
| Schéma | Ce qui se passe |
|---|---|
| Single | Un seul modèle résout directement la tâche. |
| Cascade | Un modèle moins cher rédige une réponse. Un contrôle qualité l'accepte ou la transmet à un modèle plus puissant. |
| Critique | Un modèle rédige, un deuxième modèle relit, et le premier modèle corrige. |
TechTarget a expliqué comment le routeur choisit. Il s'appuie sur HyDRA, un framework existant de GitHub qui évalue les tâches selon le raisonnement, la génération de code, le débogage et l'usage d'outils. Ces évaluations déterminent le schéma attribué à chaque tâche.
Le schéma Critique comporte un détail à connaître. Pendant la préversion, InfoQ a rapporté que le relecteur n'a pas accès aux outils et provient d'une autre famille de modèles. Cette conception réduit le risque que deux modèles similaires s'accordent sur la même erreur.
Les chiffres de benchmark et de coût
Le chiffre phare de GitHub vient de l'Artificial Analysis Coding Agent Index, un classement externe des agents de code par IA. Fusion Max a obtenu 60. Selon GitHub, cela le place à deux points au plus de Claude Code utilisant Opus 5.5 Max.
GitHub affirme que Fusion y est parvenu « pour environ la moitié du coût API moyen par tâche, en utilisant environ moitié moins de tokens et en prenant environ 40 % de temps en moins par tâche ». Ce sont les propres chiffres de GitHub pour un seul indice. Ce n'est pas un test indépendant de Fusion sur votre code.
La préversion avait avancé des chiffres similaires sur d'autres tests. InfoQ a rapporté que sur TerminalBench 2.1, HydraFusion avait amélioré la qualité des tâches vérifiées de 4,9 points de pourcentage. Il avait aussi réduit le coût estimé de 67 % par rapport à Claude Opus 5. Sur CheckpointBench, un test interne de GitHub construit à partir de vraies sessions Copilot, son score se situait à 0,1 point au plus d'Opus 5, pour un coût estimé inférieur de 65 %.
Les premiers clients mettent en avant le même avantage. Hari Pokhrel, principal software engineer chez AT&T, a déclaré que Fusion Standard avait « amélioré l'efficacité en tokens dans tout AT&T » en choisissant le bon modèle pour chaque tâche.
Comment fonctionne la facturation
Fusion n'est pas un forfait. « Lorsque vous utilisez Copilot Fusion, vous êtes facturé pour chaque modèle qu'il utilise, au tarif standard de chaque modèle », indique le changelog.
Cela compte pour les schémas Cascade et Critique, où une seule tâche peut faire appel à deux ou trois modèles. Pendant une durée limitée, les utilisateurs des offres Copilot payantes bénéficient d'une remise de 30 % sur le coût des modèles. GitHub n'a pas précisé quand la remise prendra fin.
Le choix des modèles dans Copilot évolue vite. GitHub a retiré six modèles de Copilot plus tôt ce mois-ci, ce qui a obligé les équipes ayant épinglé des noms de modèles à en changer.
Ce que cela change pour les développeurs
L'argument est simple : arrêtez de choisir les modèles et laissez GitHub le faire. Les économies éventuelles dépendent de votre travail, alors mesurez-les plutôt que de vous fier au benchmark.
- Faites un test comparatif. Prenez une semaine de tâches typiques et comparez Fusion Standard avec le modèle que vous utilisez aujourd'hui. Suivez les tokens, le temps et la fréquence à laquelle vous acceptez le résultat.
- Surveillez la facture, pas la grille tarifaire. Fusion facture chaque modèle qu'il appelle. Une exécution Critique peut coûter plus cher qu'un seul modèle puissant sur une tâche courte, même si elle coûte moins en moyenne.
- Définissez d'abord les politiques de modèles. Les administrateurs devraient décider vers quels modèles Fusion peut router avant d'en faire le choix par défaut. Cela préserve les règles sur les données et les validations de fournisseurs.
- Profitez de la remise pour apprendre. La remise de 30 % est temporaire. Collectez vos propres données de coût tant qu'elle dure, pour connaître vos vrais chiffres quand elle prendra fin.
- Attendez-vous à épingler moins de modèles. Comme les listes de modèles changent toutes les quelques semaines, le routage réduit le travail de mise à jour des scripts et des paramètres. Cet avantage passe facilement inaperçu et se mesure difficilement.
Les analystes défendent cette orientation depuis un moment. « Nous apprenons rapidement que l'économie de l'utilisation des LLM pour chaque tâche de programmation ne fonctionne souvent pas », a déclaré Torsten Volk, d'Omdia, à TechTarget. Fusion est la réponse de GitHub à ce problème, et vos données d'utilisation montreront s'il convient à votre équipe.
Sources
Articles liés
ChatGPT et Codex partageront une seule limite d'usage dès décembre
Dès décembre, les offres ChatGPT Plus, Pro et Business puiseront l'usage de ChatGPT et de Codex dans une seule enveloppe. Seuls les chats Instant restent hors compteur.
Fin des ventes de Gemini Code Assist ; Antigravity prend le relais
Google a cessé de vendre Gemini Code Assist Standard et Enterprise le 9 octobre. Des licences peuvent être ajoutées jusqu'au 31 janvier 2027, et Antigravity le remplace.
Nanbeige4.3-33B : un modèle ouvert qui devance Qwen en code agentique
Le laboratoire Nanbeige de BOSS Zhipin a publié Nanbeige4.3-33B sous Apache 2.0 et revendique 80,9 sur Terminal-Bench 2.1, contre 73,0 pour Qwen3.8-27B.