GitHub Copilot Fusion ist da: eine Auswahl, viele Modelle
GitHub Copilot Fusion ist allgemein verfügbar. Es wählt und kombiniert Modelle je nach Aufgabe, und laut GitHub erreicht Fusion Max das Niveau der besten Agenten zu etwa den halben Kosten.
Von Claire Whitmore
4 Min. Lesezeit
Maschinell übersetzt aus dem englischen Original, das Claire Whitmore auf Fakten geprüft und redigiert hat. Es gilt die englische Fassung. So arbeiten wir
Die Zahlen
- Fusion Max score on the Artificial Analysis Coding Agent Index
- 60
- lower average API cost per task than the top agent, per GitHub
- ~50%
- less time per task, per GitHub
- ~40%
- limited-time discount on model costs for paid plans
- 30%
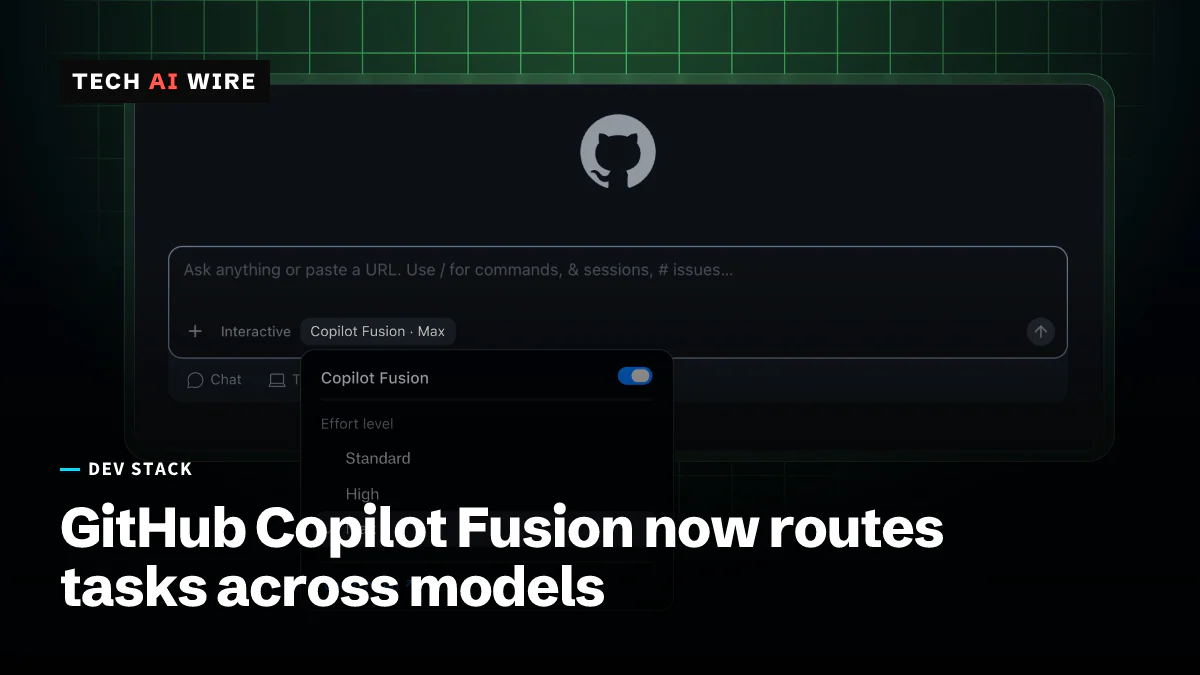
GitHub hat Copilot Fusion am 28. Oktober 2026 allgemein verfügbar gemacht. Statt für eine Programmieraufgabe ein einzelnes KI-Modell auszuwählen, können Entwickler Fusion wählen und Copilot die Modelle selbst auswählen und manchmal kombinieren lassen. Laut GitHubs Changelog kommt die höchste Stufe in einem Benchmark bis auf zwei Punkte an den besten Coding-Agenten heran, zu etwa den halben Kosten.
Copilot ist GitHubs KI-Assistent fürs Programmieren. Bisher wählten die meisten Nutzer ein Modell entweder von Hand oder ließen eine „Auto“-Einstellung ein Modell pro Aufgabe auswählen.
Was Copilot Fusion macht
Fusion ist die fertige Version von Project HydraFusion, das GitHub am 4. September als Research Preview gestartet hatte. Laut GitHub verbindet das Produkt die Multi-Modell-Orchestrierung von HydraFusion mit der bestehenden automatischen Modellauswahl von Copilot.
Vor den Modellen sitzt ein Router. Für jeden Prompt entscheidet er, welches Modell oder welche Modelle die Arbeit übernehmen. Fusion gibt es in drei Aufwandsstufen namens Standard, High und Max.
Es ist in VS Code, der GitHub Copilot App, der Copilot CLI und JetBrains-IDEs verfügbar. Admins legen über Modellrichtlinien fest, welche Modelle Fusion nutzen darf. Sie können Fusion auch zur Standardauswahl für ihre Organisation machen.
Wie das Routing funktioniert
Laut GitHub schickt Fusion jede Aufgabe über einen von drei Wegen.
| Muster | Was passiert |
|---|---|
| Single | Ein Modell löst die Aufgabe direkt. |
| Cascade | Ein günstigeres Modell entwirft eine Antwort. Eine Qualitätsprüfung akzeptiert sie oder eskaliert an ein stärkeres Modell. |
| Critique | Ein Modell entwirft, ein zweites Modell prüft, und das erste Modell überarbeitet. |
TechTarget erklärte, wie der Router auswählt. Er baut auf HyDRA auf, einem bestehenden GitHub-Framework, das Aufgaben nach Reasoning, Codegenerierung, Debugging und Werkzeugnutzung bewertet. Diese Bewertungen entscheiden, welches Muster eine Aufgabe bekommt.
Beim Critique-Muster gibt es ein Detail, das man kennen sollte. Während der Preview berichtete InfoQ, dass der Prüfer keinen Werkzeugzugriff hat und aus einer anderen Modellfamilie stammt. Durch diesen Aufbau ist es weniger wahrscheinlich, dass sich zwei ähnliche Modelle auf denselben Fehler einigen.
Die Angaben zu Benchmark und Kosten
GitHubs zentrale Zahl stammt aus dem Artificial Analysis Coding Agent Index, einer externen Rangliste von KI-Coding-Agenten. Fusion Max erzielte 60 Punkte. Das liegt laut GitHub nur bis zu zwei Punkte von Claude Code mit Opus 5.5 Max entfernt.
Laut GitHub schaffte Fusion das „zu etwa den halben durchschnittlichen API-Kosten pro Aufgabe, mit etwa halb so vielen Tokens und mit etwa 40 % weniger Zeit pro Aufgabe“. Das sind GitHubs eigene Zahlen für einen einzelnen Index. Sie sind kein unabhängiger Test von Fusion mit Ihrem Code.
Die Preview hatte bei anderen Tests ähnliche Angaben gemacht. InfoQ berichtete, dass HydraFusion auf TerminalBench 2.1 die verifizierte Aufgabenqualität um 4,9 Prozentpunkte verbesserte. Außerdem senkte es die geschätzten Kosten im Vergleich zu Claude Opus 5 um 67 %. Auf CheckpointBench, einem internen GitHub-Test aus echten Copilot-Sitzungen, lag sein Ergebnis nur bis zu 0,1 Punkte von Opus 5 entfernt, bei 65 % niedrigeren geschätzten Kosten.
Frühe Kunden nennen denselben Vorteil. Hari Pokhrel, Principal Software Engineer bei AT&T, sagte, Fusion Standard habe „die Token-Effizienz bei AT&T insgesamt verbessert“, indem es für jede Aufgabe das richtige Modell auswählte.
Wie die Abrechnung funktioniert
Fusion ist keine Pauschale. „Wenn Sie Copilot Fusion nutzen, wird Ihnen jedes Modell berechnet, das es verwendet, zum jeweiligen Standardtarif des Modells“, heißt es im Changelog.
Das ist wichtig für die Muster Cascade und Critique, bei denen eine einzige Aufgabe zwei oder drei Modelle berühren kann. Für begrenzte Zeit erhalten Nutzer kostenpflichtiger Copilot-Pläne 30 % Rabatt auf Modellkosten. GitHub sagte nicht, wann der Rabatt endet.
Die Modellauswahl in Copilot hat sich zuletzt schnell verändert. GitHub hat Anfang dieses Monats sechs Modelle aus Copilot entfernt, was Teams mit fest eingetragenen Modellnamen zum Wechsel zwang.
Was das für Entwickler bedeutet
Das Versprechen ist einfach: keine Modelle mehr auswählen und das GitHub überlassen. Ob das Geld spart, hängt von Ihrer Arbeit ab, also messen Sie es, statt dem Benchmark zu vertrauen.
- Machen Sie einen direkten Vergleichstest. Nehmen Sie eine Woche typischer Aufgaben und vergleichen Sie Fusion Standard mit dem Modell, das Sie jetzt nutzen. Erfassen Sie Tokens, Zeit und wie oft Sie das Ergebnis übernehmen.
- Achten Sie auf die Rechnung, nicht auf die Preisliste. Fusion berechnet jedes Modell, das es aufruft. Ein Critique-Durchlauf kann bei einer kurzen Aufgabe mehr kosten als ein einzelnes starkes Modell, auch wenn er im Durchschnitt weniger kostet.
- Legen Sie zuerst Modellrichtlinien fest. Admins sollten entscheiden, an welche Modelle Fusion weiterleiten darf, bevor sie es zum Standard machen. So bleiben Datenregeln und Anbieterfreigaben intakt.
- Nutzen Sie die Rabattphase zum Lernen. Der Rabatt von 30 % ist befristet. Sammeln Sie Ihre eigenen Kostendaten, solange er gilt, damit Sie Ihre echten Zahlen kennen, wenn er endet.
- Rechnen Sie mit weniger fest eingetragenen Modellen. Da sich Modelllisten alle paar Wochen ändern, verringert das Routing den Aufwand für das Aktualisieren von Skripten und Einstellungen. Dieser Vorteil wird leicht übersehen und ist schwer zu messen.
Analysten vertreten diese Richtung schon seit einer Weile. „Wir lernen gerade schnell, dass sich der Einsatz von LLMs für jede Programmieraufgabe wirtschaftlich oft nicht rechnet“, sagte Torsten Volk von Omdia gegenüber TechTarget. Fusion ist GitHubs Antwort auf dieses Problem, und Ihre Nutzungsdaten werden zeigen, ob es zu Ihrem Team passt.
Quellen
Ähnliche Artikel
ChatGPT und Codex teilen sich ab Dezember ein Nutzungslimit
Ab Dezember ziehen die ChatGPT-Pläne Plus, Pro und Business die Nutzung von ChatGPT und Codex von einem gemeinsamen Kontingent ab. Nur Instant-Chats zählen nicht.
Verkauf von Gemini Code Assist endet, Antigravity übernimmt
Google verkauft Gemini Code Assist Standard und Enterprise seit dem 9. Oktober nicht mehr. Lizenzen lassen sich bis zum 31. Januar 2027 hinzufügen, und Antigravity ersetzt das Produkt.
Nanbeige4.3-33B: Offenes Modell schlägt Qwen beim Agenten-Coding
Das Nanbeige-Labor von BOSS Zhipin hat Nanbeige4.3-33B unter Apache 2.0 veröffentlicht und meldet einen Wert von 80,9 auf Terminal-Bench 2.1, gegenüber 73,0 für Qwen3.8-27B.