TorchTPU : Google publie en open source un PyTorch natif pour les TPU
TorchTPU exécute PyTorch nativement sur les TPU de Google et a validé 98 % des 4 917 modèles Hugging Face testés. PyTorch/XLA est déprécié et sera archivé le 15 novembre.
3 min de lecture
En chiffres
- of 4,917 Hugging Face models passed Google's first test tier
- 98%
- PyTorch core operations implemented
- ~450
- the date the PyTorch/XLA repository is archived
- Nov 15
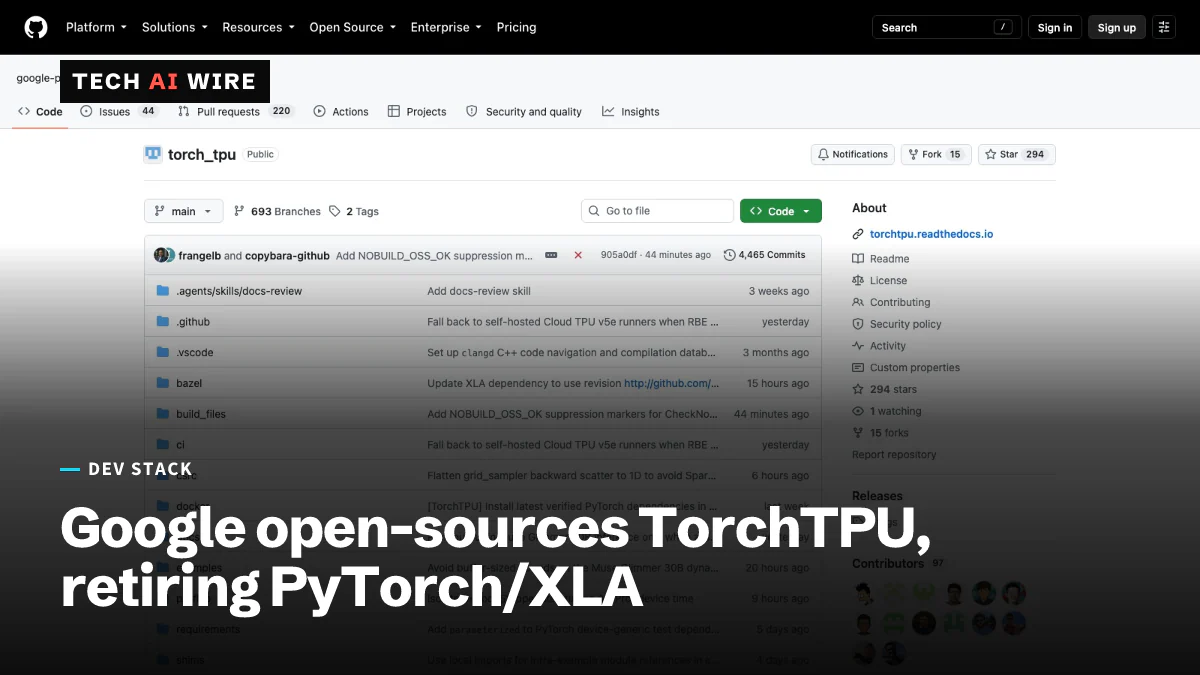
Google a publié TorchTPU en open source le 20 octobre 2026, un backend qui exécute du code PyTorch nativement sur ses puces TPU. C'est important, car il remplace PyTorch/XLA, l'ancienne voie d'accès aux TPU, plus difficile, qui sera archivée le 15 novembre. Selon Google, le code existant devrait migrer avec à peine plus qu'un changement de nom de périphérique.
Ce qu'est TorchTPU
Les TPU sont les puces d'IA que Google conçoit et loue via Google Cloud. PyTorch est la bibliothèque la plus utilisée pour créer et entraîner des modèles d'IA. Jusqu'ici, PyTorch accédait aux TPU via PyTorch/XLA, qui transforme un modèle en graphe compilé avant son exécution.
TorchTPU fait plutôt du TPU un périphérique PyTorch ordinaire. « Porter une charge de travail sur TPU devrait être aussi simple que de remplacer model.to("cuda") par model.to("tpu") », écrit l'équipe dans l'annonce sur le blog de PyTorch. Google l'a développé avec l'équipe PyTorch de Meta, à partir de la mi-2025.
Le dépôt GitHub du projet indique la version 0.2.0 sur PyPI, la licence Apache 2.0 et Python 3.11 ou plus récent. Selon Crypto Briefing, la publication couvre quatre dépôts et a été dévoilée lors de la PyTorch Conference. Le blog les nomme TorchTPU, vLLM-TorchTPU, SGLang-TorchTPU et TorchTitan, qui couvrent le backend principal, deux moteurs de service de modèles et une bibliothèque d'entraînement.
Comment il exécute le code
TorchTPU implémente environ 450 opérations ATen, les fonctions mathématiques de base qui composent tout modèle PyTorch. Par défaut, le code s'exécute ligne par ligne en mode « eager », comme dans PyTorch classique. Le blog décrit trois modes eager :
| Mode | Comment l'activer | Ce qu'il fait |
|---|---|---|
| Strict | Par défaut | Exécute chaque opération telle qu'elle est écrite |
| Debug | TORCH_TPU_LAUNCH_BLOCKING=1 | Attend chaque opération, pour faciliter le débogage |
| DeferAndFuse | TORCH_TPU_DEFER_AND_FUSE=1 | Regroupe les opérations ; « 50 % ou plus plus rapide que Strict Eager » |
Pour plus de vitesse, torch.compile(backend="tpu") transforme un modèle en un seul programme TPU. Du code personnalisé pour la puce peut être écrit avec Pallas, de JAX, ou avec Helion. Le blog cite des intégrations avec vLLM, SGLang, TorchTitan, Ray et TorchRec. Le blog indique aussi que certains des plus grands clients de Google Cloud utilisent déjà TorchTPU en production.
Les performances des modèles
Les seuls chiffres disponibles pour l'instant viennent des propres tests de Google. Le blog rapporte ces résultats :
| Test | Résultat |
|---|---|
| Modèles Hugging Face exécutés | 4 917, issus de plus de 500 familles de modèles |
| Réussite au premier niveau de tests | 98 % (4 821 sur 4 917) |
| Sortie identique à celle d'un GPU | 97 % (638 sur 657 vérifiés) |
| Entraînement de Qwen3 235B sur 64 puces TPU v7 | 1 828 tokens/s dans PyTorch, contre 1 937 dans la pile JAX de Google |
Crypto Briefing cite le chiffre de Google de 52 % d'utilisation des FLOPs du modèle lors de l'entraînement de Qwen 3 8B sur jusqu'à 8 192 puces TPU v7x. Cette mesure correspond à la part de la capacité de calcul maximale d'une puce que le modèle utilise réellement.
PyTorch/XLA part à la retraite
Le dépôt PyTorch/XLA s'ouvre désormais sur un avis : « Ce projet est déprécié et remplacé par TorchTPU. » Il ajoute que le dépôt « sera archivé le 15 novembre 2026 », ce qui le passe en lecture seule. Il conseille de « démarrer les nouvelles charges de travail PyTorch sur TPU avec TorchTPU et de migrer les charges de travail PyTorch/XLA existantes ». La dernière installation stable qu'il mentionne fixe torch et torch_xla à la version 2.8.0.
Le même jour, le backend TorchNeuron d'Amazon pour ses puces Trainium est entré en bêta publique et a abandonné la même approche XLA. Les deux fournisseurs de cloud traitent désormais leurs puces d'IA comme des périphériques PyTorch ordinaires.
Ce que cela signifie pour les développeurs
TorchTPU fait d'un TPU une simple chaîne de périphérique de plus, ce qui place les puces de Google dans la même comparaison de prix que les GPU.
- Planifiez dès maintenant votre sortie de PyTorch/XLA. Après le 15 novembre, le dépôt n'accepte plus de correctifs. Fixez
torch_xla2.8.0 pour les tâches en cours et testez TorchTPU sur une machine v6e, que le README suggère comme point de départ le plus simple. - Vérifiez d'abord les 2 %. Le propre test de Google échoue encore pour environ un modèle sur cinquante. Lancez une courte tâche d'entraînement ou d'inférence sur votre modèle exact avant de planifier une migration.
- Prévoyez du temps pour les noyaux CUDA personnalisés. Le code GPU écrit à la main ne se transpose pas. Il faut le réécrire en Pallas ou en Helion, alors chiffrez ce travail.
- Figez la version. Il s'agit de la version 0.2.0. Verrouillez-la dans les fichiers requirements et revérifiez les résultats après chaque mise à jour.
- Faites vos propres mesures. Chaque chiffre de vitesse cité ici vient de Google. Comparez le coût par token sur votre propre charge de travail, face aux GPU et aux puces des autres clouds.
Sources
- Introducing TorchTPU - PyTorch Blog
- google-pytorch/torch_tpu - GitHub
- pytorch/xla - GitHub
- Google open-sources TorchTPU to bring native PyTorch support to its TPUs - Crypto Briefing
Articles liés
DuckDB 2.0 LTS ajoute un mode serveur, les déclencheurs et VARIANT
DuckDB 2.0.0, une version à support long terme sortie le 21 octobre, ajoute un mode serveur, les déclencheurs et VARIANT. Les versions antérieures à la 2.0 ne peuvent pas lire ses fichiers.
PyTorch 2.15 accélère jusqu'à 6,5 fois le décodage MoE sur Mac
PyTorch 2.15 ajoute les tenseurs FP8 sur les GPU d'Apple et de nouveaux kernels Metal. Le décodage de Qwen3.6-35B-A3B sur un M3 Ultra bondit de 9,4 à 61,3 tokens par seconde.
La bêta de TorchNeuron apporte PyTorch en natif sur AWS Trainium
89 % des 100 principaux modèles de génération de texte tournent désormais sur AWS Trainium sans modification, contre 46 %, avec l'entrée en bêta publique du backend PyTorch TorchNeuron.