FEX-Emu détaille le coût du TSO x86 sur Arm
Émuler les règles mémoire de x86 sur Arm fait tomber le débit des accès non alignés à 8,5% de la référence. Les écritures combinées seraient 816 fois pires.
3 min de lecture
En chiffres
- of baseline throughput on unaligned operations
- 8.5%
- worse write-combine store bandwidth, as reported
- 816x
- maximum overhead with Apple's hardware TSO switch
- 15%
Le projet FEX-Emu a publié un exposé technique expliquant pourquoi exécuter des logiciels x86 sur des processeurs Arm coûte si cher, et la réponse tient à l'ordonnancement mémoire plutôt qu'à la traduction des instructions. Ses chiffres montrent que les opérations non alignées tombent à 8,5% du débit de référence avec l'approche sûre. FEX est un émulateur en mode utilisateur qui exécute des programmes Linux x86 et x86-64 sur Arm64.
Le problème porte un nom : Total Store Ordering, souvent abrégé en TSO. Tout processeur x86 le fournit. L'article de FEX le décrit comme la promesse que "when a memory store occurs, that this will be coherently visible to all other processors in the system". Arm ne fait pas cette promesse par défaut.
Pourquoi une promesse plus faible coûte plus cher
Arm utilise ce qu'on appelle un modèle mémoire faible. Les écritures d'un cœur peuvent atteindre les autres cœurs dans un ordre différent de celui du programme, et le processeur a le droit de le faire parce que c'est plus rapide.
Le logiciel écrit pour x86 suppose la garantie plus forte, souvent sans le dire. Du code multithread peut être correct sur x86 et cassé sur Arm sans autre raison. Un émulateur ne peut donc pas se contenter de traduire les instructions en espérant.
La réponse sûre de FEX passe par les instructions acquire et release présentes depuis ARMv8.0-a. Elles rétablissent correctement l'ordre. L'article décrit un coût sévère sur les opérations mémoire non alignées, où le débit tombe à 8,5% de la référence.
Là où le matériel aide
Des fonctions Arm plus récentes et le raccourci d'un fabricant changent nettement le tableau.
| Mécanisme | Effet rapporté |
|---|---|
| acquire et release d'ARMv8.0-a | Correct, mais le débit non aligné tombe à 8,5% |
| Extensions LRCPC, versions 1 à 3 | Réduisent fortement le coût de l'émulation du TSO |
| Interrupteur TSO matériel d'Apple Silicon | Quasi natif, surcoût rapporté jusqu'à environ 15% |
Les puces d'Apple peuvent recevoir l'ordre de se comporter comme du x86 pour l'ordonnancement mémoire. C'est un interrupteur matériel et non une astuce logicielle, et l'article situe le surcoût qui en résulte à environ 15% au maximum.
Deux cas restent pénibles partout ailleurs. Les opérations à verrou fractionné, c'est-à-dire des opérations atomiques à cheval sur une ligne de cache, sont décrites comme dramatiquement plus lentes sur Arm que sur x86, où l'article donne une référence d'environ 660 nanosecondes. Les écritures mémoire combinées sont rapportées à une bande passante 816 fois pire, ce qui rend selon l'article certains jeux injouables.
Le projet continue de livrer autour du problème
FEX améliore ce qu'il contrôle. Phoronix rapporte que la version FEX 2609, sortie le 8 septembre 2026, a optimisé l'instruction PMULHRSW et amélioré la détection du code auto-modifiant dans les jeux Unity.
Cette version a aussi réduit la contention de verrous dans le compilateur à la volée. Les notes indiquent qu'elle permet à "multiple threads jitting code at the same time block each other less frequently". Le gain annoncé va jusqu'à deux fois. Un nouveau cache sur disque pour le code compilé s'active avec la variable d'environnement FEX_DISKCACHE, ce qui accélère les lancements suivants.
Le projet sur GitHub énonce les faits qui entourent tout cela. Il est sous licence MIT, exige ARMv8.0 ou plus récent, et exécute les binaires 32 bits comme 64 bits. Il s'intègre aussi à Wine et Proton, en transmettant les appels graphiques aux bibliothèques OpenGL et Vulkan de l'hôte.
Ce que cela signifie pour les développeurs
Lisez ceci avant d'accuser votre émulateur. Si une charge x86 rampe sur une machine Arm, le modèle mémoire est le premier suspect. Cherchez les accès non alignés, les atomiques à cheval sur une ligne de cache et les tampons en écriture combinée. Ces trois-là expliquent plus que le décodage des instructions.
Vérifiez quelles extensions Arm possède votre matériel cible. La prise en charge de LRCPC sépare un chemin d'émulation coûteux d'un chemin moins cher, et elle varie selon la puce plutôt que selon le fabricant. Cette vérification a sa place dans vos notes de compatibilité si vous distribuez un logiciel exécuté sous émulation.
Ne lisez pas les chiffres d'Apple comme le cas général. Son interrupteur matériel explique pourquoi un Mac paraît proche du natif et pourquoi un portable Arm sous Linux souvent non. Les mesures prises sur Apple Silicon surestiment ce que vivent vos utilisateurs sur d'autres puces Arm.
Si vous écrivez le logiciel émulé, l'alignement est le gain le moins cher. Des atomiques et des tampons alignés évitent complètement le pire chemin, et c'est un changement de votre côté qu'aucun émulateur ne peut faire à votre place.
Sources
- The scourge of x86 emulation - FEX-Emu
- FEX 2609 Released With Speedier JIT Performance, JIT Disk Cache Option - Phoronix
- FEX-Emu/FEX - GitHub
Articles liés
Ubuntu 26.10 livrera un noyau Linux 7.3 préliminaire
Ubuntu 26.10 sort le 15 octobre, trois jours avant que Linux 7.3 ne soit déclaré stable. L'image d'installation embarque une version candidate.
Raspberry Pi OS ajoute un dock d'icônes et un lanceur
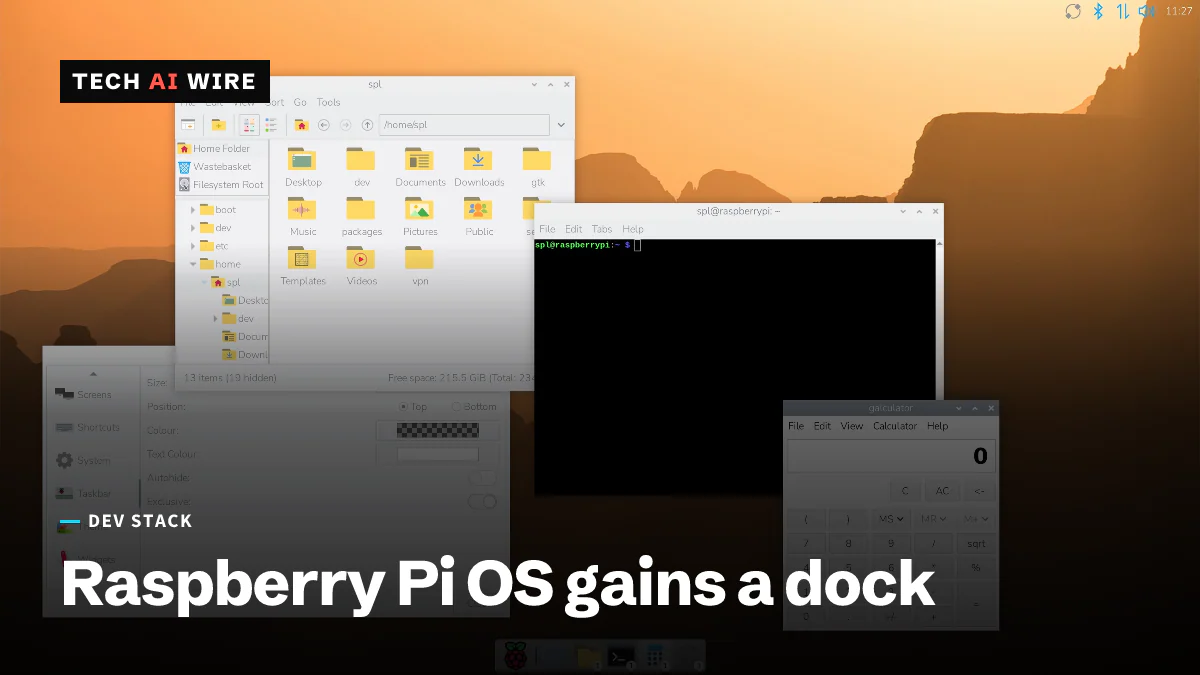
Une option swaybg réduit la mémoire sur les cartes sous 2 Go, et le bureau labwc gagne un dock d'icônes optionnel, un lanceur avec recherche et un Control Centre.
Un firmware open source démarre sur une carte de bureau AMD grand public
Coreboot et l'openSIL d'AMD tournent désormais sur la MSI B850P, une vraie carte de bureau AM5. Cela réduit de 79,1 % le code de firmware fermé, mais c'est un produit payant, pas un téléchargement gratuit.