FEX-EmuがArm上のx86 TSOの代償を解説
x86のメモリ規則をArmで再現すると、非整列アクセスの処理量は基準の8.5%まで落ちる。ライトコンバイン書き込みは816倍悪いと報告されている。
3 分で読めます
数字で見る
- of baseline throughput on unaligned operations
- 8.5%
- worse write-combine store bandwidth, as reported
- 816x
- maximum overhead with Apple's hardware TSO switch
- 15%
FEX-Emuプロジェクトが、x86のソフトウェアをArmプロセッサで動かす代償がなぜ大きいのかを技術的に説明した。答えは命令の変換ではなくメモリの順序にある。示された数値では、安全な方式をとると非整列の処理量は基準の8.5%まで落ちる。FEXは、x86およびx86-64のLinuxプログラムをArm64で動かすユーザーモードのエミュレータである。
この問題には名前がある。Total Store Ordering、通常はTSOと略される。x86のプロセッサはすべてこれを備える。FEXの記事は、これを「when a memory store occurs, that this will be coherently visible to all other processors in the system」という約束だと説明する。Armは既定ではこの約束をしない。
弱い約束のほうが高くつく理由
Armは弱いメモリモデルと呼ばれる方式を使う。あるコアからの書き込みが、プログラムが書いた順序とは違う順で他のコアに届くことがある。そのほうが速いので、プロセッサはそれを許されている。
x86向けに書かれたソフトウェアは、強い保証を前提にしていることが多く、そう明記していないことも多い。マルチスレッドのコードが、他に理由もなくx86では正しくArmでは壊れる、ということが起こる。したがってエミュレータは、命令を訳して祈るだけでは済まない。
FEXの安全な答えは、ARMv8.0-a以降にあるacquireとrelease命令を使うことである。これで順序は正しく取り戻せる。記事は、非整列のメモリ操作での代償は大きく、処理量は基準の8.5%まで落ちると報告する。
ハードウェアが助けになる場面
新しいArmの機能と、ある1社の近道が、この状況をかなり変える。
| 仕組み | 報告された効果 |
|---|---|
| ARMv8.0-aのacquireとrelease | 正しいが、非整列の処理量は基準の8.5%まで低下 |
| LRCPC拡張、バージョン1から3 | TSO再現の代償を大幅に下げる |
| Apple Siliconのハードウェア TSO切り替え | ほぼネイティブ、上乗せは最大でおよそ15% |
Appleのチップは、メモリ順序についてx86のように振る舞うよう指示できる。これはソフトウェアの工夫ではなくハードウェアの切り替えである。記事はその結果の上乗せを最大でおよそ15%としている。
他の環境では、2つの場合がつらいままである。キャッシュラインをまたぐ不可分操作であるスプリットロックは、Armではx86より劇的に遅いとされる。記事はx86側の基準を約660ナノ秒としている。ライトコンバインのメモリ書き込みは帯域が816倍悪いと報告され、記事によれば一部のゲームは遊べなくなる。
プロジェクトはその周りで改善を続ける
FEX自身は、自分で制御できる部分の改善を続けている。Phoronixによれば、2026年9月8日のFEX 2609では、PMULHRSW命令が最適化され、Unity製ゲームにおける自己書き換えコードの検出が改善された。
同じリリースは、実行時コンパイラのロック競合も減らした。リリースノートは、これにより「multiple threads jitting code at the same time block each other less frequently」と述べる。示された向上は最大で2倍である。コンパイル済みコードをディスクに置く新しいキャッシュは、環境変数FEX_DISKCACHEで有効になり、次回以降の起動が速くなる。
GitHubのプロジェクトは周辺の事実を示している。ライセンスはMIT、必要なのはARMv8.0以降で、32ビットと64ビットの双方のバイナリを動かす。WineやProtonとも組み合わさり、グラフィックスの呼び出しはホスト側のOpenGLおよびVulkanのライブラリへ渡される。
開発者にとっての意味
エミュレータのせいにする前に、これを読みたい。Armの機械でx86の処理が遅いなら、まず疑うべきはメモリモデルである。探すべきは非整列アクセス、キャッシュラインをまたぐ不可分操作、そしてライトコンバインの緩衝領域である。この3つは命令の解読よりも多くを説明する。
対象のハードウェアがどのArm拡張を備えるかを確認したい。LRCPCの有無は、高価な経路と安価な経路の分かれ目であり、メーカー単位ではなくチップ単位で異なる。エミュレーション下で使われるソフトウェアを配布するなら、この確認は互換性の注意書きに入れるべきである。
Appleの数値を一般的な例と読んではいけない。ハードウェアの切り替えがあるからMacはネイティブに近く感じられ、Linuxを載せたArmのノートはそう感じられないことが多い。Apple Siliconで取った測定は、他のArmチップの利用者が経験する内容を実際より良く見せる。
エミュレートされる側のソフトウェアを書いているなら、整列が最も安い改善である。整列された不可分操作と緩衝領域は最悪の経路をまるごと避けられる。これはエミュレータが代わりにできない、あなた側の変更である。
出典
- The scourge of x86 emulation - FEX-Emu
- FEX 2609 Released With Speedier JIT Performance, JIT Disk Cache Option - Phoronix
- FEX-Emu/FEX - GitHub
関連記事
Ubuntu 26.10はLinux 7.3の開発版を載せて出る
Ubuntu 26.10は10月15日に公開される。Linux 7.3が安定版になる予定の3日前であり、ISOにはリリース候補(RC)が載る。
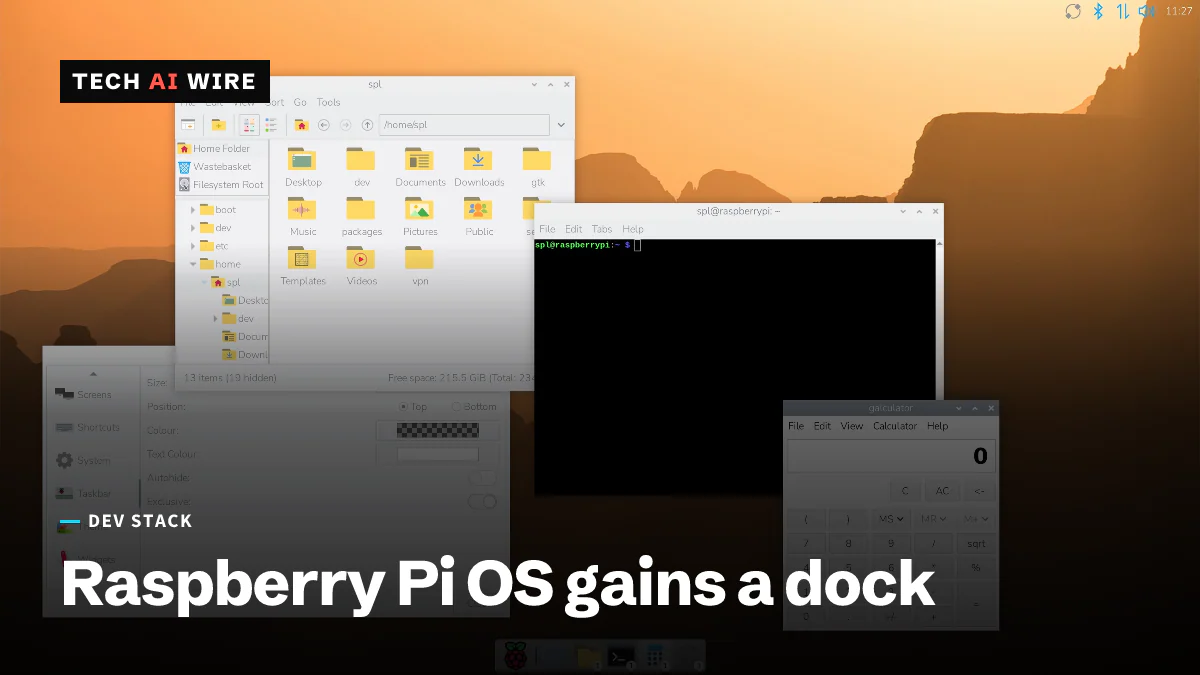
Raspberry Pi OS、アイコンドックとランチャーを追加
メモリ2GB未満の基板向けにswaybgの選択肢が加わり、labwcのデスクトップに任意のアイコンドック、検索付きランチャー、コントロールセンターが入りました。
オープンソースファームウェアが一般向けAMDデスクトップ基板で起動
CorebootとAMDのopenSILが、実際のデスクトップ用AM5基板MSI B850Pで動くようになりました。クローズドソースのファームウェアコードを79.1%削減しますが、無料配布ではなく有償製品として提供されます。