FEX-Emu detalha o custo do TSO do x86 no Arm
Emular as regras de memória do x86 no Arm derruba a vazão dos acessos não alinhados para 8,5% da referência. Escritas combinadas seriam 816 vezes piores.
3 min de leitura
Em números
- of baseline throughput on unaligned operations
- 8.5%
- worse write-combine store bandwidth, as reported
- 816x
- maximum overhead with Apple's hardware TSO switch
- 15%
O projeto FEX-Emu publicou uma explicação técnica de por que rodar software x86 em processadores Arm custa tanto, e a resposta está na ordenação de memória, não na tradução de instruções. Os números mostram que operações não alinhadas caem para 8,5% da vazão de referência com a abordagem segura. O FEX é um emulador em modo usuário que roda programas Linux x86 e x86-64 no Arm64.
O problema tem nome: Total Store Ordering, normalmente abreviado como TSO. Todo processador x86 o oferece. O artigo do FEX o descreve como a promessa de que "when a memory store occurs, that this will be coherently visible to all other processors in the system". O Arm não faz essa promessa por padrão.
Por que uma promessa mais fraca custa mais
O Arm usa o que se chama de modelo de memória fraco. As escritas de um núcleo podem chegar aos outros núcleos numa ordem diferente daquela em que o programa as escreveu, e o processador pode fazer isso porque é mais rápido.
Software escrito para x86 pressupõe a garantia mais forte, muitas vezes sem dizer. Um código com várias threads pode estar correto no x86 e quebrado no Arm sem nenhum outro motivo. Um emulador, portanto, não pode apenas traduzir as instruções e torcer.
A resposta segura do FEX usa as instruções acquire e release, presentes desde o ARMv8.0-a. Elas restabelecem a ordem corretamente. O artigo descreve um custo severo nas operações de memória não alinhadas, em que a vazão cai para 8,5% da referência.
Onde o hardware ajuda
Recursos mais novos do Arm e o atalho de um fabricante mudam bastante o quadro.
| Mecanismo | Efeito relatado |
|---|---|
| acquire e release do ARMv8.0-a | Correto, mas a vazão não alinhada cai para 8,5% |
| Extensões LRCPC, versões 1 a 3 | Reduzem bastante o custo de emular o TSO |
| Chave de TSO em hardware do Apple Silicon | Quase nativo, com acréscimo relatado de até cerca de 15% |
Os chips da Apple podem ser instruídos a se comportar como x86 na ordenação de memória. Isso é uma chave de hardware, e não um truque de software, e o artigo situa o acréscimo resultante em cerca de 15% no máximo.
Dois casos continuam penosos em todo o resto. Operações de trava dividida, ou seja, operações atômicas que cruzam o limite de uma linha de cache, são descritas como dramaticamente mais lentas no Arm do que no x86, onde o artigo dá uma referência de cerca de 660 nanossegundos. Para escritas combinadas de memória, relata-se uma largura de banda 816 vezes pior, o que segundo o artigo torna certos jogos injogáveis.
O projeto segue avançando ao redor
O FEX continua melhorando o que controla. A Phoronix informa que a versão FEX 2609, de 8 de setembro de 2026, otimizou a instrução PMULHRSW e melhorou a detecção de código automodificável em jogos feitos com Unity.
Essa versão também reduziu a disputa por travas no compilador em tempo de execução. As notas dizem que ela deixa "multiple threads jitting code at the same time block each other less frequently". O ganho declarado chega a duas vezes. Um novo cache em disco para o código compilado é ligado pela variável de ambiente FEX_DISKCACHE, deixando as execuções seguintes mais rápidas.
O projeto no GitHub reúne os fatos ao redor disso. Ele tem licença MIT, exige ARMv8.0 ou mais novo e roda binários de 32 e de 64 bits. Também se integra ao Wine e ao Proton, encaminhando as chamadas gráficas às bibliotecas OpenGL e Vulkan do hospedeiro.
O que isso significa para os desenvolvedores
Leia isto antes de culpar o seu emulador. Se uma carga x86 se arrasta numa máquina Arm, o modelo de memória é o primeiro suspeito. Procure acessos não alinhados, operações atômicas cruzando linhas de cache e buffers de escrita combinada. Esses três explicam mais do que a decodificação de instruções.
Verifique quais extensões do Arm o seu hardware alvo tem. O suporte a LRCPC separa um caminho de emulação caro de um mais barato, e varia por chip, não por fabricante. Essa verificação cabe nas suas notas de compatibilidade se você distribui software que as pessoas rodam sob emulação.
Não leia os números da Apple como o caso geral. A chave em hardware é a razão de um Mac parecer próximo do nativo e de um notebook Arm com Linux muitas vezes não parecer. Medições feitas no Apple Silicon superestimam o que os seus usuários vivem em outros chips Arm.
Se você escreve o software emulado, o alinhamento é o ganho barato. Operações atômicas e buffers alinhados evitam por completo o pior caminho, e essa é uma mudança do seu lado que nenhum emulador pode fazer por você.
Fontes
- The scourge of x86 emulation - FEX-Emu
- FEX 2609 Released With Speedier JIT Performance, JIT Disk Cache Option - Phoronix
- FEX-Emu/FEX - GitHub
Artigos relacionados
Ubuntu 26.10 vai levar um Linux 7.3 preliminar
O Ubuntu 26.10 sai em 15 de outubro, três dias antes de o Linux 7.3 ser declarado estável. A imagem de instalação leva uma candidata.
Raspberry Pi OS ganha um dock de ícones e um lançador
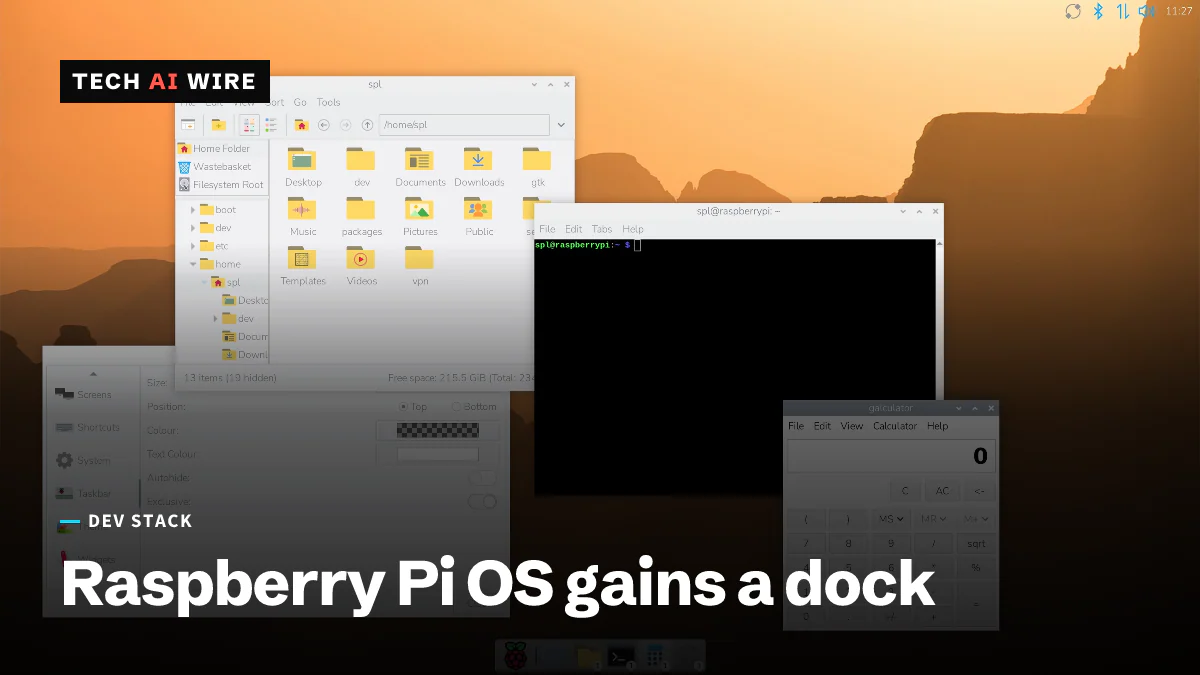
Uma opção com swaybg reduz a memória em placas abaixo de 2 GB, e o desktop labwc ganha um dock opcional, um lançador com busca e um Control Centre.
Firmware de código aberto inicializa em placa de desktop AMD de consumo
O Coreboot e o openSIL da AMD já funcionam na MSI B850P, uma placa de desktop AM5 de verdade. Isso corta em 79,1% o código de firmware fechado, mas o produto é pago, não um download gratuito.