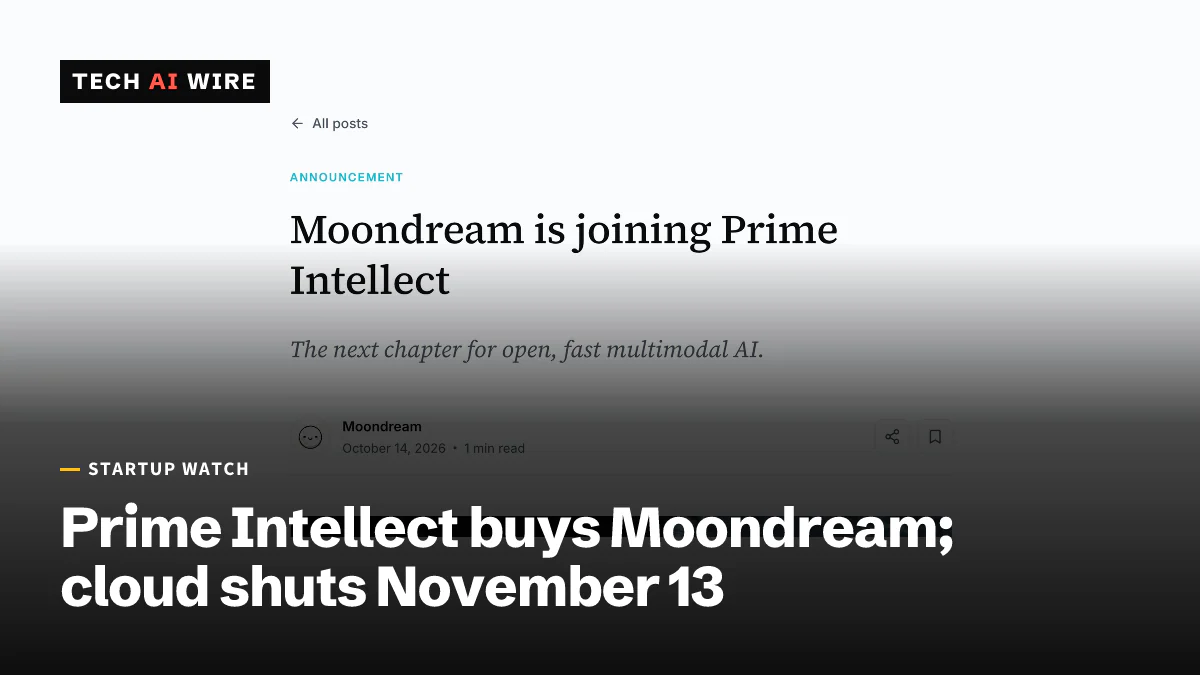
Prime Intellect compra a Moondream; a nuvem dela fecha em 13 de novembro
A Prime Intellect comprou a Moondream, criadora de pequenos modelos abertos de visão. O Moondream Cloud será desativado em 13 de novembro de 2026, e os modelos continuam abertos.
Por Claire Whitmore
3 min de leitura
Traduzido automaticamente do original em inglês, que Claire Whitmore verificou e editou. Prevalece a versão em inglês. Como trabalhamos
Em números
- date Moondream Cloud shuts down, 30 days after the announcement
- Nov 13
- employees at Moondream before the deal
- <10
- raised by Moondream before the acquisition
- $4.5M
- Moondream inferences per second on one Nvidia H100, per Prime Intellect
- 60+
A Prime Intellect, uma empresa de San Francisco que vende treinamento e inferência de IA, comprou a Moondream, uma pequena criadora de modelos abertos de visão. O negócio foi anunciado em 13 de outubro de 2026. Para desenvolvedores, a data que importa é 13 de novembro: é quando o Moondream Cloud, seu serviço hospedado, será desativado. Os termos financeiros não foram divulgados.
O que a Moondream construiu
A Moondream faz modelos de visão e linguagem, modelos de IA que olham uma imagem e respondem a perguntas sobre ela. Sua proposta sempre foi que modelos pequenos podem superar os grandes em tarefas específicas. "A Moondream é a prova de que modelos pequenos e eficientes podem superar modelos gigantes em tarefas específicas", disse o cofundador Jay Allen no anúncio da Prime Intellect.
A Prime Intellect diz que seu modelo mais recente, o Moondream 3.1, lidera em detecção de objetos, imagens aéreas, gráficos e cenas lotadas. Diz que o modelo atende 34 requisições por segundo, cerca de 24 vezes mais rápido que o modelo aberto mais preciso depois dele. Em seu próprio teste não publicado contra o Muse Wonder, o novo modelo de fronteira da Meta, a Prime Intellect diz que o Moondream 3.1 alcança 80% da precisão ao apontar objetos em fotos. Ele faz isso a cerca de um milésimo do custo. São números da empresa, não testes independentes.
A empresa é minúscula. A Moondream tinha menos de 10 funcionários e havia captado US$ 4,5 milhões antes do negócio, segundo o Crypto Briefing e o AlphaSignal. Os cofundadores Vik Korrapati e Jay Allen entram na Prime Intellect para liderar seu trabalho de inferência.
Por que a Prime Intellect a quis
O principal prêmio é o software que faz os modelos rodarem rápido, não o modelo de visão em si, informa o Crypto Briefing. Esse software é o Photon, o motor de inferência da Moondream. Inferência é o trabalho de rodar um modelo treinado para responder a requisições, e é onde fica a maior parte do custo contínuo.
O Photon compila cada modelo em um único programa para a GPU, o chip que roda modelos de IA. A Prime Intellect diz que isso permite que uma Nvidia H100 rode mais de 60 inferências da Moondream por segundo. O AlphaSignal relata cerca do dobro da vazão do vLLM, um motor de serving open source popular, em trabalho comparável. A primeira versão do Photon sob a Prime Intellect suporta modelos Moondream, Qwen e Gemma na H100.
A Prime Intellect captou uma Série A de US$ 130 milhões com avaliação de US$ 1 bilhão em julho de 2026, diz o Crypto Briefing. Na época, ela relatava um ritmo de receita anual de mais de US$ 100 milhões.
O que acontece com os clientes da Moondream
A Moondream detalhou o encerramento em seu próprio post. "Em 13 de novembro de 2026, daqui a 30 dias, o Moondream Cloud (inferência e Lens) será desativado", escreveu. Veja o que muda e o que fica:
| Item | O que acontece |
|---|---|
| Moondream Cloud, incluindo o Lens | Desativado em 13 de novembro de 2026 |
| Créditos comprados não usados | Reembolsados, segundo a Moondream |
| Créditos na plataforma da Prime | Chegam "nos próximos dias", segundo a Prime Intellect |
| Moondream 3.1 | Disponível pelo Prime Inference |
| Modelos Moondream | Continuam abertos, e a marca continua |
Os dois posts descrevem os créditos de forma diferente. A Moondream promete reembolsar os créditos comprados não usados. A Prime Intellect diz que os clientes do Moondream Cloud vão receber créditos em sua própria plataforma. A Moondream diz que vai contatar os clientes diretamente. Dúvidas urgentes vão para contact@moondream.ai.
O que isso significa para desenvolvedores
Se você chama o Moondream Cloud a partir de código em produção, tem menos de um mês. Encontre cada ponto em que seu código chama a API da Moondream nesta semana, não em novembro.
Você tem dois caminhos. O primeiro é migrar para o Prime Inference, onde o Moondream 3.1 já está disponível e os créditos devem cair. O segundo é hospedar você mesmo o modelo aberto, já que os pesos continuam abertos. Hospedar por conta própria elimina o risco de fornecedor, mas você vai precisar de capacidade de GPU e de uma estrutura de serving próprias.
Antes de trocar, faça benchmark do novo endpoint com suas próprias imagens. Números de velocidade e precisão do post de lançamento de um fornecedor são um ponto de partida, não uma garantia. Verifique também como o reembolso e os créditos da Prime se aplicam à sua conta antes do prazo final.
A lição maior é sobre APIs pequenas de modelos hospedados. Uma startup com menos de 10 pessoas pode ser comprada e desativada com 30 dias de aviso. Para qualquer modelo do qual você dependa, prefira um cujos pesos você poderia rodar por conta própria se a API desaparecesse.
Fontes
- Moondream is joining Prime Intellect | Moondream - Moondream
- Moondream is joining Prime Intellect - Prime Intellect
- Prime Intellect acquires Moondream to speed up AI inference - Crypto Briefing
- Prime Intellect Buys Moondream to Double Vision AI Throughput - AlphaSignal
Artigos relacionados
Nebius compra Inferize por até US$ 150 milhões para reduzir as partidas a frio
A Nebius teria pago entre US$ 100 milhões e US$ 150 milhões pela Inferize, uma startup de 17 pessoas fundada em janeiro que reduz o tempo ocioso das GPUs quando os modelos de IA iniciam.
As decisões tipadas do Laya, explicadas
Um modelo de decisões tipadas preenche perguntas fixas com respostas tipadas e um número de confiança. Os pesos abertos do Laya, 421M, permitem que você mesmo confira isso.
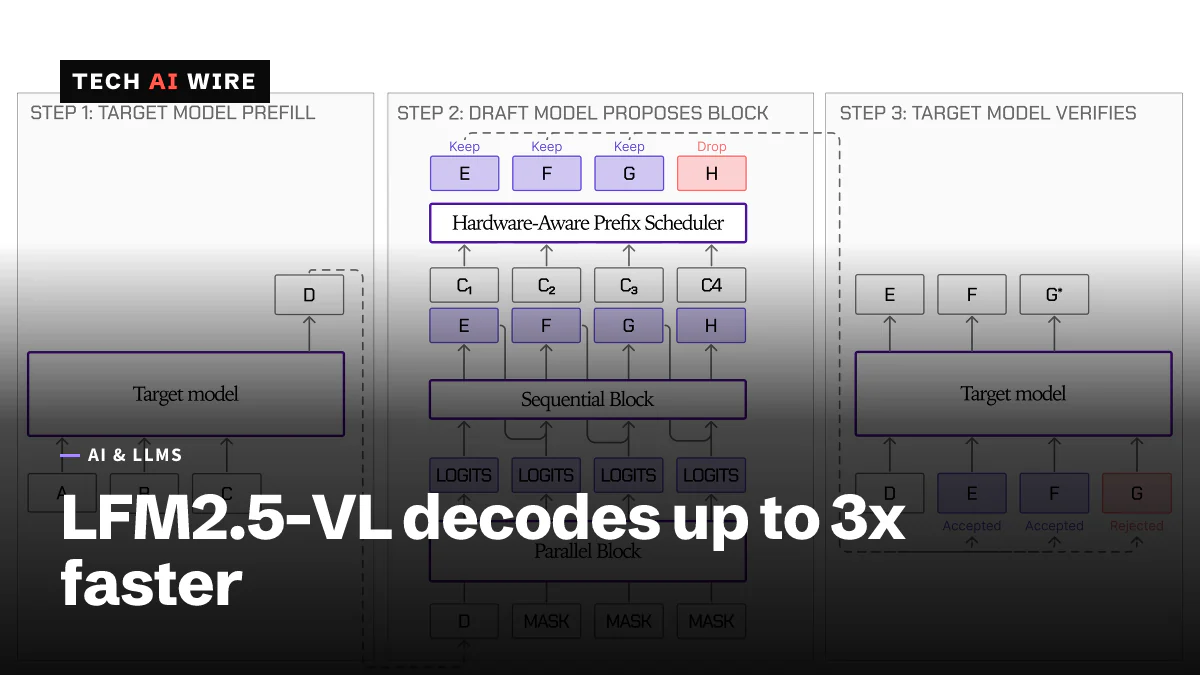
Liquid AI LFM2.5-VL-DSpark acelera seu modelo de visão 3B
O modelo de rascunho LFM2.5-VL-DSpark da Liquid AI, com 280M de parâmetros, decodifica seu modelo de visão 3B até 3.13x mais rápido em um M5 Max, com saída idêntica.