Prime Intellect rachète Moondream ; son cloud ferme le 13 novembre
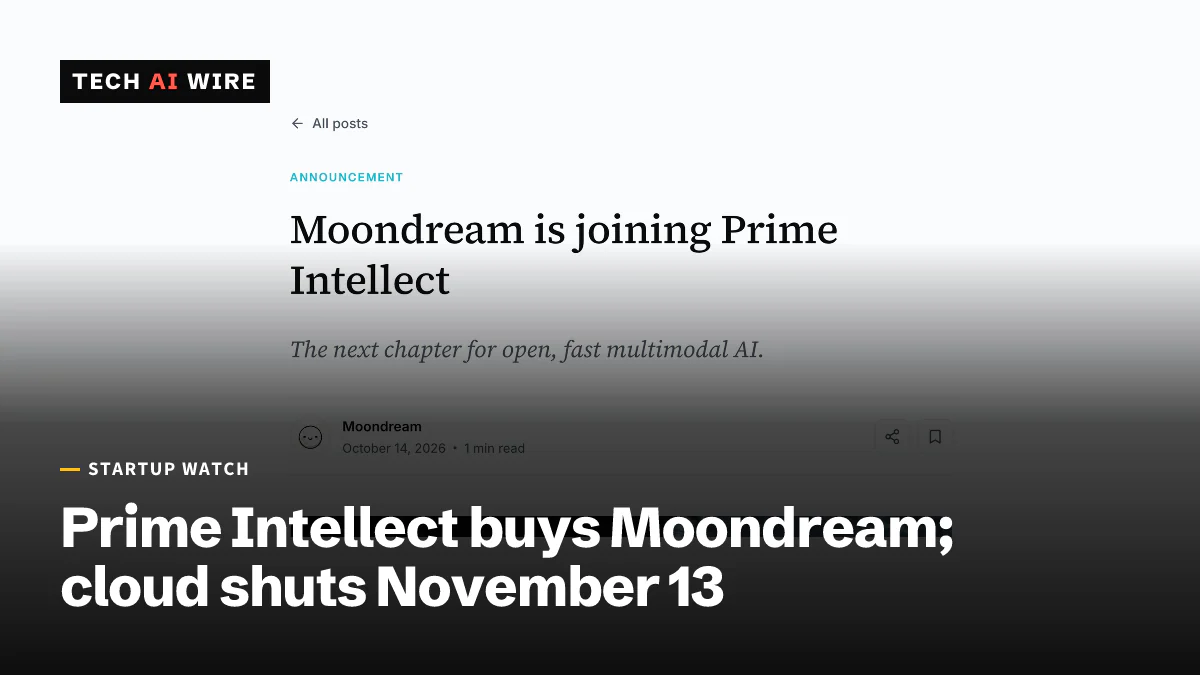
Prime Intellect a racheté Moondream, créateur de petits modèles de vision ouverts. Moondream Cloud ferme le 13 novembre 2026, et ses modèles restent ouverts.
Par Claire Whitmore
3 min de lecture
Traduit automatiquement de l'original anglais, vérifié et édité par Claire Whitmore. La version anglaise fait foi. Notre méthode
En chiffres
- date Moondream Cloud shuts down, 30 days after the announcement
- Nov 13
- employees at Moondream before the deal
- <10
- raised by Moondream before the acquisition
- $4.5M
- Moondream inferences per second on one Nvidia H100, per Prime Intellect
- 60+
Prime Intellect, une entreprise de San Francisco qui vend de l'entraînement et de l'inférence d'IA, a racheté Moondream, un petit créateur de modèles de vision ouverts. L'accord a été annoncé le 13 octobre 2026. Pour les développeurs, la date qui compte est le 13 novembre : c'est le jour où Moondream Cloud, son service hébergé, fermera. Les conditions financières n'ont pas été dévoilées.
Ce que Moondream a construit
Moondream conçoit des modèles vision-langage, des modèles d'IA qui regardent une image et répondent à des questions à son sujet. Son argument a toujours été que de petits modèles peuvent battre les grands sur des tâches précises. « Moondream est la preuve que de petits modèles efficaces peuvent battre des modèles géants sur des tâches spécifiques », a déclaré le cofondateur Jay Allen dans l'annonce de Prime Intellect.
Prime Intellect affirme que son dernier modèle, Moondream 3.1, est en tête pour la détection d'objets, les images aériennes, les graphiques et les scènes encombrées. Elle indique que le modèle traite 34 requêtes par seconde, environ 24 fois plus vite que le modèle ouvert le plus précis après lui. Dans son propre test non publié face à Muse Wonder, le nouveau modèle de pointe de Meta, Prime Intellect affirme que Moondream 3.1 atteint 80 % de sa précision pour pointer des objets sur des photos. Il y parvient pour environ un millième du coût. Ce sont des chiffres de l'entreprise, pas des tests indépendants.
L'entreprise est minuscule. Moondream comptait moins de 10 employés et avait levé 4,5 millions de dollars avant l'accord, selon Crypto Briefing et AlphaSignal. Les cofondateurs Vik Korrapati et Jay Allen rejoignent Prime Intellect pour diriger ses travaux sur l'inférence.
Pourquoi Prime Intellect le voulait
Le principal atout est un logiciel qui fait tourner les modèles rapidement, pas le modèle de vision lui-même, rapporte Crypto Briefing. Ce logiciel, c'est Photon, le moteur d'inférence de Moondream. L'inférence consiste à exécuter un modèle entraîné pour répondre aux requêtes, et c'est là que se concentre l'essentiel des coûts récurrents.
Photon compile chaque modèle en un programme unique pour le GPU, la puce qui fait tourner les modèles d'IA. Prime Intellect affirme que cela permet à un seul Nvidia H100 d'exécuter plus de 60 inférences Moondream par seconde. AlphaSignal rapporte environ deux fois le débit de vLLM, un moteur de service open source populaire, sur des charges comparables. La première version de Photon sous Prime Intellect prend en charge les modèles Moondream, Qwen et Gemma sur le H100.
Prime Intellect a levé 130 millions de dollars en série A sur une valorisation de 1 milliard de dollars en juillet 2026, selon Crypto Briefing. Elle déclarait alors un rythme annuel de chiffre d'affaires de plus de 100 millions de dollars.
Ce qui attend les clients de Moondream
Moondream a détaillé la fermeture dans son propre billet. « Le 13 novembre 2026, dans 30 jours, Moondream Cloud (inférence et Lens) fermera », a écrit l'entreprise. Voici ce qui change et ce qui reste :
| Élément | Ce qui se passe |
|---|---|
| Moondream Cloud, y compris Lens | Ferme le 13 novembre 2026 |
| Crédits achetés non utilisés | Remboursés, selon Moondream |
| Crédits sur la plateforme de Prime | Prévus « dans les prochains jours », selon Prime Intellect |
| Moondream 3.1 | Disponible via Prime Inference |
| Modèles Moondream | Restent ouverts, et la marque continue |
Les deux billets décrivent les crédits différemment. Moondream promet le remboursement des crédits achetés non utilisés. Prime Intellect indique que les clients de Moondream Cloud recevront des crédits sur sa propre plateforme. Moondream dit qu'elle contactera directement ses clients. Les questions urgentes sont à adresser à contact@moondream.ai.
Ce que cela signifie pour les développeurs
Si vous appelez Moondream Cloud depuis du code en production, il vous reste moins d'un mois. Repérez dès cette semaine, et non en novembre, chaque endroit où votre code appelle l'API Moondream.
Vous avez deux options. La première est de passer à Prime Inference, où Moondream 3.1 est déjà disponible et où les crédits devraient arriver. La seconde est d'héberger vous-même le modèle ouvert, puisque les poids restent ouverts. L'auto-hébergement supprime le risque fournisseur, mais il vous faudra votre propre capacité GPU et votre propre infrastructure de service.
Avant de basculer, testez le nouvel endpoint sur vos propres images. Les chiffres de vitesse et de précision d'un billet de lancement sont un point de départ, pas une garantie. Vérifiez aussi comment le remboursement et les crédits Prime s'appliquent à votre compte avant la date limite.
La leçon plus large concerne les petites API de modèles hébergés. Une startup de moins de 10 personnes peut être rachetée et fermée avec un préavis de 30 jours. Pour tout modèle dont vous dépendez, préférez-en un dont vous pourriez faire tourner les poids vous-même si l'API disparaissait.
Sources
- Moondream is joining Prime Intellect | Moondream - Moondream
- Moondream is joining Prime Intellect - Prime Intellect
- Prime Intellect acquires Moondream to speed up AI inference - Crypto Briefing
- Prime Intellect Buys Moondream to Double Vision AI Throughput - AlphaSignal
Articles liés
Nebius rachète Inferize jusqu'à 150 M$ pour réduire les démarrages à froid
Nebius aurait payé entre 100 et 150 millions de dollars pour Inferize, une start-up de 17 personnes fondée en janvier, qui réduit le temps d'inactivité des GPU au démarrage des modèles d'IA.
Les décisions typées de Laya, expliquées
Un modèle à décisions typées remplit des questions fixes avec des réponses typées et un indice de confiance. Les poids ouverts de Laya, 421M, permettent de vérifier cela soi-même.
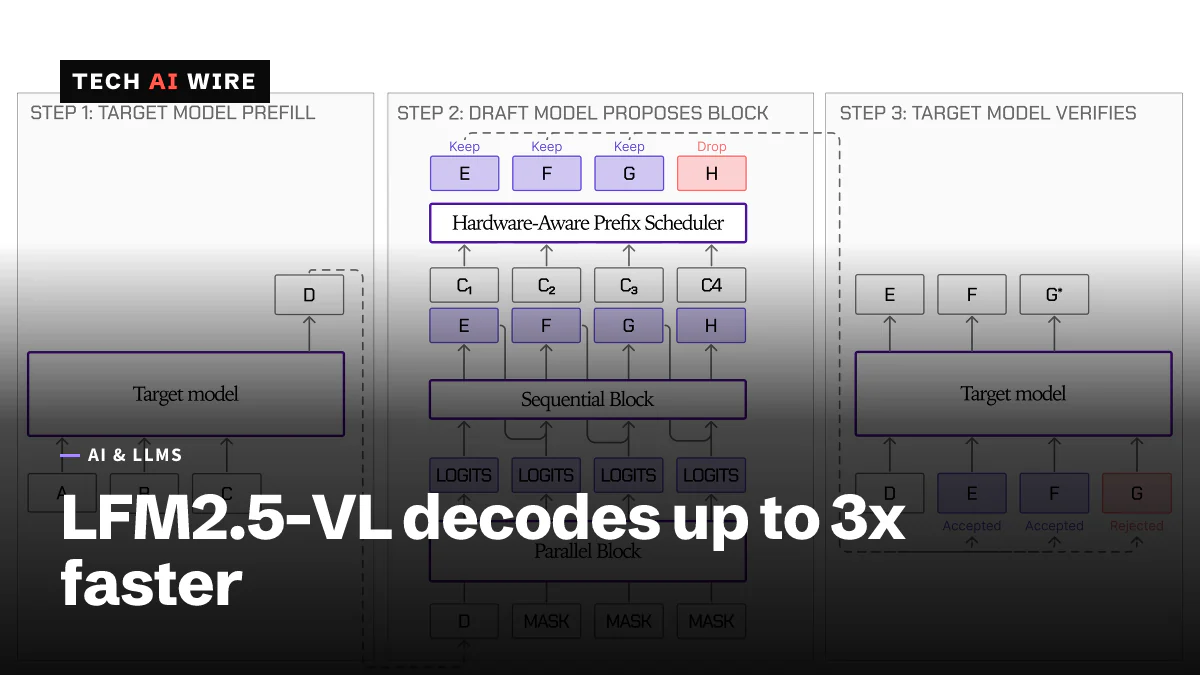
Liquid AI LFM2.5-VL-DSpark accélère son modèle de vision 3B
Le modèle brouillon LFM2.5-VL-DSpark de Liquid AI, avec 280M de paramètres, décode son modèle de vision 3B jusqu'à 3.13x plus vite sur un M5 Max, avec une sortie identique.