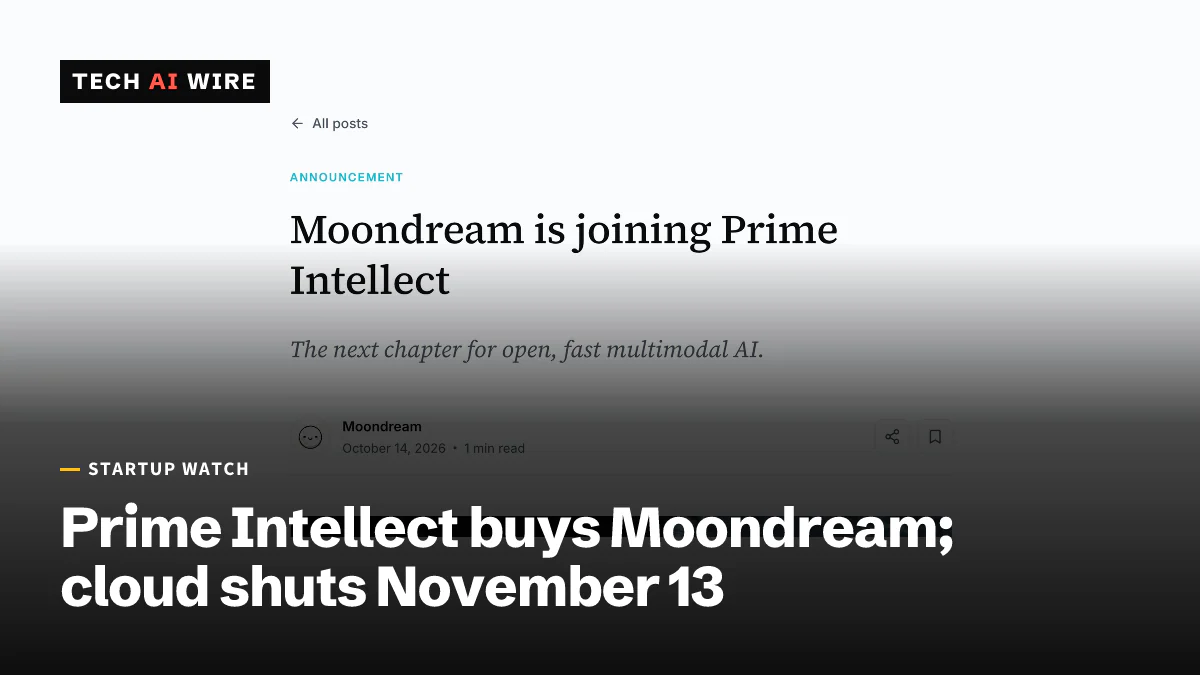
Prime Intellect kauft Moondream, dessen Cloud am 13. November schließt
Prime Intellect hat Moondream gekauft, den Hersteller kleiner offener Vision-Modelle. Moondream Cloud wird am 13. November 2026 abgeschaltet, und die Modelle bleiben offen.
Von Claire Whitmore
3 Min. Lesezeit
Maschinell übersetzt aus dem englischen Original, das Claire Whitmore auf Fakten geprüft und redigiert hat. Es gilt die englische Fassung. So arbeiten wir
Die Zahlen
- date Moondream Cloud shuts down, 30 days after the announcement
- Nov 13
- employees at Moondream before the deal
- <10
- raised by Moondream before the acquisition
- $4.5M
- Moondream inferences per second on one Nvidia H100, per Prime Intellect
- 60+
Prime Intellect, ein Unternehmen aus San Francisco, das KI-Training und Inferenz verkauft, hat Moondream übernommen, einen kleinen Hersteller offener Vision-Modelle. Der Deal wurde am 13. Oktober 2026 angekündigt. Für Entwickler zählt der 13. November: An diesem Tag wird Moondream Cloud, der gehostete Dienst, abgeschaltet. Finanzielle Details wurden nicht offengelegt.
Was Moondream gebaut hat
Moondream entwickelt Vision-Language-Modelle, also KI-Modelle, die ein Bild betrachten und Fragen dazu beantworten. Sein Versprechen war immer, dass kleine Modelle große bei eng umrissenen Aufgaben schlagen können. „Moondream ist der Beweis, dass kleine, effiziente Modelle riesige Modelle bei bestimmten Aufgaben schlagen können“, sagte Mitgründer Jay Allen in der Ankündigung von Prime Intellect.
Laut Prime Intellect liegt Moondreams neuestes Modell, Moondream 3.1, bei Objekterkennung, Luftbildern, Diagrammen und dichten Szenen vorn. Es verarbeite 34 Anfragen pro Sekunde, rund 24-mal schneller als das nächstgenaueste offene Modell. In einem eigenen, unveröffentlichten Test gegen Muse Wonder, Metas neues Frontier-Modell, erreicht Moondream 3.1 laut Prime Intellect 80 % der Genauigkeit beim Zeigen auf Objekte in Fotos. Das gelingt zu rund einem Tausendstel der Kosten. Dies sind Unternehmensangaben, keine unabhängigen Tests.
Das Unternehmen ist winzig. Moondream hatte vor dem Deal weniger als 10 Mitarbeiter und 4,5 Millionen US-Dollar eingesammelt, laut Crypto Briefing und AlphaSignal. Die Mitgründer Vik Korrapati und Jay Allen wechseln zu Prime Intellect und leiten dort die Arbeit an der Inferenz.
Warum Prime Intellect es wollte
Der Hauptgewinn ist Software, die Modelle schnell laufen lässt, nicht das Vision-Modell selbst, berichtet Crypto Briefing. Diese Software ist Photon, Moondreams Inferenz-Engine. Inferenz ist die Arbeit, ein trainiertes Modell auszuführen, um Anfragen zu beantworten, und dort fällt der Großteil der laufenden Kosten an.
Photon kompiliert jedes Modell in ein einziges Programm für die GPU, den Chip, auf dem KI-Modelle laufen. Laut Prime Intellect kann damit eine einzige Nvidia H100 mehr als 60 Moondream-Inferenzen pro Sekunde ausführen. AlphaSignal berichtet bei vergleichbarer Arbeit von rund doppelt so viel Durchsatz wie bei vLLM, einer beliebten Open-Source-Serving-Engine. Die erste Photon-Version unter Prime Intellect unterstützt Moondream-, Qwen- und Gemma-Modelle auf der H100.
Prime Intellect sammelte im Juli 2026 eine Series A über 130 Millionen US-Dollar bei einer Bewertung von 1 Milliarde US-Dollar ein, so Crypto Briefing. Damals meldete es ein jährliches Umsatztempo von mehr als 100 Millionen US-Dollar.
Was mit Moondream-Kunden passiert
Moondream hat die Abschaltung in einem eigenen Beitrag dargelegt. „Am 13. November 2026, 30 Tage ab heute, wird die Moondream Cloud (Inferenz und Lens) abgeschaltet“, schrieb das Unternehmen. Das ändert sich und das bleibt:
| Element | Was passiert |
|---|---|
| Moondream Cloud, einschließlich Lens | Wird am 13. November 2026 abgeschaltet |
| Nicht verbrauchtes gekauftes Guthaben | Wird laut Moondream erstattet |
| Guthaben auf Primes Plattform | Kommt laut Prime Intellect „in den nächsten Tagen“ |
| Moondream 3.1 | Über Prime Inference verfügbar |
| Moondream-Modelle | Bleiben offen, und die Marke besteht weiter |
Die beiden Beiträge beschreiben das Guthaben unterschiedlich. Moondream verspricht Erstattungen für nicht verbrauchtes gekauftes Guthaben. Prime Intellect sagt, Kunden von Moondream Cloud erhielten Guthaben auf seiner eigenen Plattform. Moondream will Kunden direkt kontaktieren. Dringende Fragen gehen an contact@moondream.ai.
Was das für Entwickler bedeutet
Wenn Sie Moondream Cloud aus Produktionscode aufrufen, bleibt Ihnen weniger als ein Monat. Suchen Sie diese Woche jede Stelle, an der Ihr Code die Moondream-API aufruft, nicht erst im November.
Sie haben zwei Wege. Der erste ist der Wechsel zu Prime Inference, wo Moondream 3.1 bereits verfügbar ist und das Guthaben ankommen sollte. Der zweite ist, das offene Modell selbst zu hosten, da die Gewichte offen bleiben. Selbst-Hosting beseitigt das Anbieterrisiko, aber Sie brauchen eigene GPU-Kapazität und ein eigenes Serving-Setup.
Bevor Sie wechseln, testen Sie den neuen Endpunkt mit Ihren eigenen Bildern. Geschwindigkeits- und Genauigkeitsangaben aus dem Launch-Beitrag eines Anbieters sind ein Ausgangspunkt, keine Garantie. Prüfen Sie vor dem Stichtag auch, wie die Erstattung und das Prime-Guthaben für Ihr Konto gelten.
Die größere Lehre betrifft kleine gehostete Modell-APIs. Ein Startup mit weniger als 10 Personen kann gekauft und mit 30 Tagen Vorlauf abgeschaltet werden. Bevorzugen Sie bei jedem Modell, von dem Sie abhängen, eines, dessen Gewichte Sie selbst ausführen könnten, falls die API verschwindet.
Quellen
- Moondream is joining Prime Intellect | Moondream - Moondream
- Moondream is joining Prime Intellect - Prime Intellect
- Prime Intellect acquires Moondream to speed up AI inference - Crypto Briefing
- Prime Intellect Buys Moondream to Double Vision AI Throughput - AlphaSignal
Ähnliche Artikel
Nebius kauft Inferize für bis zu 150 Mio. US-Dollar, um Kaltstarts zu verkürzen
Nebius zahlte Berichten zufolge 100 bis 150 Millionen US-Dollar für Inferize, ein im Januar gegründetes Start-up mit 17 Personen, das die Leerlaufzeit von GPUs beim Start von KI-Modellen verkürzt.
Layas typisierte Entscheidungen, erklärt
Ein Modell für typisierte Entscheidungen füllt feste Fragen mit typisierten Antworten und einer Vertrauenszahl. Layas offene 421M-Gewichte lassen Sie das selbst prüfen.
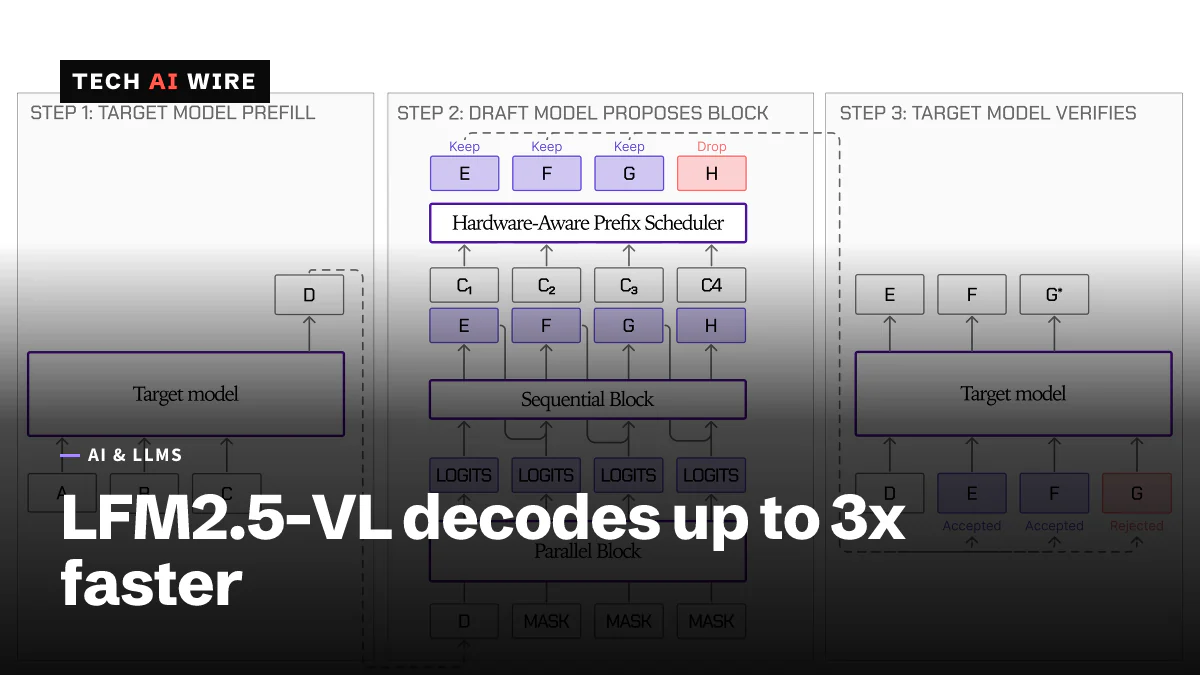
Liquid AI LFM2.5-VL-DSpark beschleunigt sein 3B-Vision-Modell
Das Draft-Modell LFM2.5-VL-DSpark von Liquid AI mit 280M Parametern dekodiert sein 3B-Vision-Modell auf einem M5 Max bis zu 3.13x schneller, bei identischer Ausgabe.