AstaBrief 8B: modelo aberto do Ai2 escreve relatórios com citações
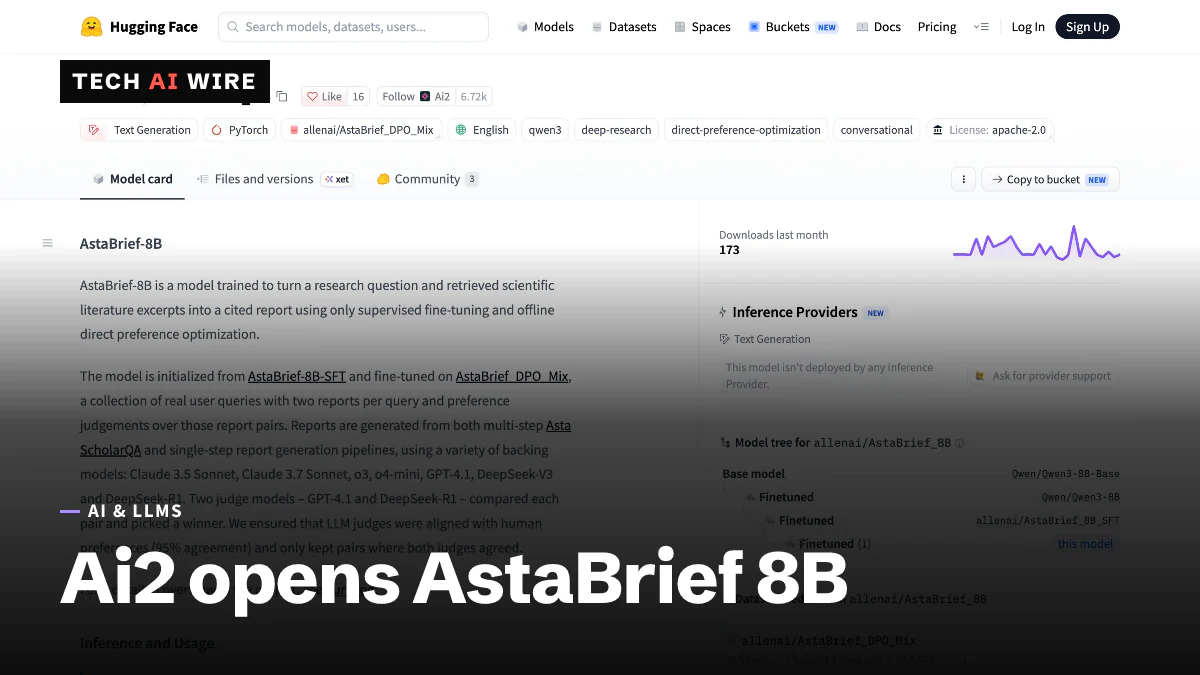
O Ai2 lançou o AstaBrief 8B, um modelo sob Apache 2.0 baseado no Qwen3-8B que escreve relatórios de pesquisa com citações em 51,1 segundos, 3,5 vezes mais rápido que o modo Thinking do Asta.
3 min de leitura
- Fast mode (AstaBrief 8B)
- 51.1s
- Thinking mode (Claude-powered)
- 178.5s
O Allen Institute for AI (Ai2) lançou o AstaBrief 8B em 2 de outubro de 2026, um modelo aberto pequeno que transforma artigos científicos em um relatório com citações. Ele escreve um relatório em 51,1 segundos, em média, cerca de 3,5 vezes mais rápido que o modo baseado no Claude ao lado do qual funciona. Os pesos estão sob a licença Apache 2.0, então uma equipe pode rodá-lo no próprio hardware e colocá-lo em um produto.
O AstaBrief agora é o "Fast mode" do Asta, a plataforma do Ai2 que responde a perguntas de pesquisa com base na literatura científica. O "Thinking mode", mais lento, que roda no Claude da Anthropic, continua disponível.
O que o AstaBrief faz
O AstaBrief recebe duas entradas: uma pergunta de pesquisa e trechos de artigos que uma etapa de busca já encontrou. Ele devolve um relatório escrito com citações para esses trechos, segundo o anúncio do Ai2.
A velocidade vem de fazer o trabalho em uma única passada. Pipelines de relatório mais antigos resumem as fontes, agrupam-nas e depois redigem seção por seção. O AlphaSignal relata que o AstaBrief pula essas etapas intermediárias e escreve o relatório inteiro de uma vez.
O modelo tem 8 bilhões de parâmetros, os valores ajustáveis que um modelo aprende no treinamento. Ele é baseado no Qwen3-8B, um modelo aberto da equipe Qwen, da Alibaba. Seu cartão de modelo no Hugging Face informa um comprimento de contexto de 16.000 tokens. Um token é uma palavra ou parte de uma palavra. Então esse é, mais ou menos, o orçamento de leitura para a pergunta e os trechos dos artigos juntos.
Como o Ai2 o treinou
O Ai2 partiu de cerca de 90.000 consultas de pesquisa reais de usuários do Asta, filtradas por qualidade. A partir delas, montou 47.000 exemplos para ajuste fino supervisionado, em que o modelo aprende copiando boas respostas. Depois, passou cerca de 6.000 pares de preferência por otimização direta de preferências (DPO). Na DPO, o modelo vê dois relatórios para a mesma pergunta e aprende a favorecer o melhor.
Os relatórios de exemplo vieram de outros modelos: Claude 3.5 e 3.7 Sonnet, o3, o4-mini, GPT-4.1, DeepSeek-V3 e DeepSeek-R1. O GPT-4.1 e o DeepSeek-R1 atuaram como juízes para escolher o melhor relatório de cada par. O cartão de modelo diz que esses juízes concordaram com as preferências humanas em 95% das vezes.
Uma lição se destacou. Filtrar os dados de treinamento em busca de relatórios densos em citações foi "o maior fator isolado da qualidade do grounding", diz o Ai2, conforme citado pelo AlphaSignal. Grounding, aqui, significa que as afirmações do relatório podem ser rastreadas até os artigos que ele cita.
O treinamento rodou em oito GPUs Nvidia H100. O cartão de modelo diz que a inferência cabe em uma única GPU de consumo com bastante memória e funciona com as bibliotecas Transformers e vLLM.
Como ele pontua
O Ai2 testou o AstaBrief no SQABench-CS2, um conjunto de 200 perguntas de pesquisa em ciência da computação. O AlphaSignal chama o mesmo conjunto de ScholarQA-CS2.
| Métrica no SQABench-CS2 | AstaBrief 8B |
|---|---|
| Pontuação média | 87,0 |
| Precisão das citações | 90,5 |
| Cobertura de ingredientes (pontos-chave esperados cobertos) | 90,2 |
| Precisão das respostas | 89,0 |
| Cobertura das citações (recall) | 78,2 |
A cobertura das citações é o ponto fraco. Ela mede quantas das afirmações que precisam de citação realmente recebem uma. Em um segundo teste, o DeepScholarBench, montado a partir de 63 consultas baseadas no arXiv, o AstaBrief marcou 53,5, segundo o AlphaSignal.
O que ele não consegue fazer
O AstaBrief só escreve. Ele não busca na web aberta, não divide uma pergunta em subperguntas nem faz buscas de acompanhamento, relata o AlphaSignal. Outra coisa precisa encontrar os artigos primeiro. O AlphaSignal também alerta que suas citações podem exagerar o que um artigo de fato encontrou.
As comparações também estão datadas. O Unite.AI observa que o treinamento e a avaliação foram feitos em 2025 e não foram refeitos contra os modelos de fronteira atuais.
O que isso significa para desenvolvedores
A parte útil é o lançamento completo. O Ai2 publicou os pesos, o conjunto de dados de treinamento (AstaBrief_DPO_Mix), exemplos de código e hiperparâmetros. Isso faz do AstaBrief tanto uma receita quanto um modelo. Uma equipe que esteja criando um gerador de relatórios para documentos jurídicos, tickets de suporte ou wikis internas pode copiar a configuração com os próprios dados.
Se você já roda um pipeline de recuperação (retrieval), o AstaBrief se encaixa no final dele. Sua etapa de busca encontra trechos, e o AstaBrief escreve o resumo com citações. Como os pesos são abertos, os documentos nunca precisam sair dos seus servidores. Para muitas empresas, esse é o principal motivo para escolher um modelo 8B em vez de um hospedado.
Teste o ponto fraco antes de colocá-lo em produção. Uma cobertura das citações de 78,2 significa que algumas afirmações de um relatório vão chegar sem fonte. Revise amostras de relatórios à mão, confira cada citação com o trecho para o qual ela aponta e mantenha uma pessoa no processo para tudo aquilo com base em que um leitor vai agir.
Fontes
Artigos relacionados
A Qwen Research License explicada
A Qwen Research License permite que qualquer pessoa baixe o Qwen-Image-2.1, mas limita o uso a pesquisa ou avaliação. Uso comercial exige uma licença à parte da Qwen.

Xiaomi lança MiMo-V2.6-Pro com 1 trilhão de parâmetros em pesos abertos sob MIT
O MiMo-V2.6-Pro da Xiaomi tem 1,02 trilhão de parâmetros, 42 bilhões ativos, contexto de 1 milhão de tokens e pesos sob licença MIT, mas precisa de cerca de 680 GB de memória de GPU.

NVIDIA Kumo Tabular lidera o TabArena com pesos abertos
O Kumo Tabular da NVIDIA faz previsões a partir de uma tabela rotulada em uma única passada, sem nenhum treinamento. Ele fica em primeiro no TabArena com 1.950 de Elo, em tamanhos de 28M a 215M.