AIエージェントがNavier-Stokes解決を主張、数学者たちは反発
OpenAIはMillennium Prizeの問題に1万のエージェントを投入し、88時間で解いたと述べています。その数日後、Fields Medal受賞者25人が警告に署名しました。
3 分で読めます
数字で見る
- autonomous agents OpenAI ran on the problem, per Quanta
- 10,000
- to produce the proof, plus 17 hours to formalize it
- 88 hours
- Fields Medallists who signed the warning
- 25
OpenAIは、自社のAIエージェント1万体が、数学者たちが1世紀にわたり取り組んできた問題を解いたと述べています。その3日後、数学の最高の栄誉の受賞者25人が、まさにこの種の発表に警告する宣言に署名しました。どちらも同じ週の出来事であり、その二つの隔たりこそがこの話の要点です。
Navier-Stokesは、流体がどう動くかを記述する方程式の集まりです。100万ドルがかかったこの未解決の問いは、3次元での解が常に滑らかなままなのか、それとも発散しうるのか、というものでした。Quanta Magazineは9月8日、OpenAIのエージェントがその発散、すなわち特異点を見つけたと報じました。
エージェントが出したもの
Quantaが挙げる数字は、結果と同じくらい方法についても語っています。
| 項目 | 数値 |
|---|---|
| 稼働したエージェント | 1万体、自律型 |
| 証明までの時間 | 88時間 |
| 形式化にかかった時間 | さらに17時間 |
| エージェント間でやり取りされたメッセージ | 500万件近く |
| 推定される計算コスト | 数百万ドル |
証明を形式化するとは、計算機が一つひとつの手順を機械的に検査できる形に書き直すことです。これは、部外者が議論を自分で追わなくても結果を信頼できるようにする部分です。AnthropicのAIがフェルマーの最終定理を形式化した件についての以前の記事では、はるかに古い結果に同じ手法を当てはめた例を扱いました。
功績の所在はきれいに分かれておらず、Quantaもそう書いています。Tristan Buckmaster氏とLevent Alpöge氏は、その12時間前にEuler方程式に関する近い結果を発表しており、こちらもAIの助けを借りています。Quantaは、時系列をめぐる争いと、発表より前に行われた研究へのアクセスをめぐる争いを報じています。また、Diego Córdoba氏とLuis Martínez-Zoroa氏による解析の手法が、どちらの取り組みにも不可欠だったと認めています。
Clay Instituteが実際に述べたこと
Clay Mathematics Instituteは2000年にMillennium Prize Problemsを設定しました。それぞれに100万ドルがかかっています。Quantaによれば、今回の主張の前の時点で6問が未解決のままでした。ある問題が解けたかどうかを判断するのは、この組織です。
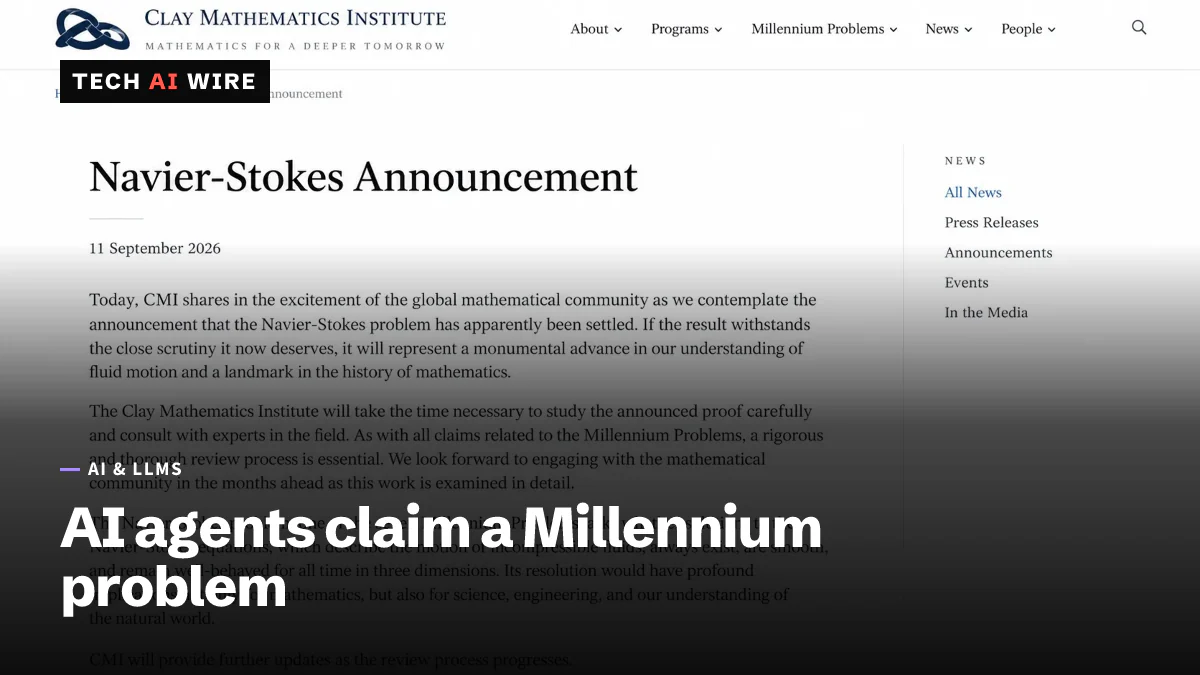
9月11日の声明は、肝心な部分が慎重に選ばれた3語だけです。この問題は「解決されたようだ」というものです。同研究所は、評価は定まった規則に従って行い、意図的に急がないと付け加えました。
賞金はまだ誰にも支払われていません。「解決されたようだ」は、主張が存在し、真剣に見えるということを認めた言葉であって、それが正しいという裁定ではありません。
なぜ25人の数学者が警告に署名したのか
同じ日、Terence Tao氏は、Fields Medal受賞者25人による共同宣言についての記事を公開しました。Fields Medal(フィールズ賞)は、数学におけるノーベル賞に当たるものです。
彼らの異議は、AIの結果が間違っているというものではありません。AI企業が数学の問題を性能ベンチマークのように扱っていること、そして結果がきちんとした解説も出典もないまま素早く発表されて届くこと、この二つへの異議です。それは、数学が普通どう営まれてきたかと食い違います。数学では、理解は人と人との長いやり取りを通して築かれます。
Tao氏の言い回しが、その中でも最も鋭い一文です。同氏は「問題を解くことは、概念的な理解という第一の目標を達成するための道具であり代理指標にすぎない」と書いています。宣言は「『真か偽か』の命題をますます速い速度で大量生産することは、豊かな土壌を壊しかねない」と警告し、危うくなっているのは数学者どうしの伝達の連なりだとしています。
これが開発者にとって意味すること
あなたはこうした発表の受け手です。ですから査読者のように読んでください。今年目にするどんなAIの結果にも、3つの問いを向けてください。自分で検査できる解説はあるか。形式的に検証されたのか、そして何に対して検証されたのか。ほかに誰が同じ問題に取り組んでいて、その人たちの功績は認められたのか。
検証と理解は切り分けてください。両者は同じ保証ではないからです。機械検証済みの証明が教えてくれるのは、手順がつながっているということだけです。なぜその結果が正しいのか、どこまで一般化できるのかは、何も教えてくれません。形式的に検証されたAIの出力を自分の仕事に差し込めば、まだ説明できない事実を取り込んだことになります。それが壊れたときには代償が伴います。
とりわけベンチマークという枠組みは割り引いて受け取ってください。Fields Medal受賞者たちの不満は、解かれた問題が得点板として使われていることであり、得点板は先に発表した者に報いるという点です。12時間の差と争いのある時系列というQuantaの記述は、その誘因が生み出したものです。同じ圧力は、APIを選ぶときに読むモデルのベンチマーク数値の背後にもあります。
工学上の教訓は、最も安く持ち帰れるものです。1万体のエージェント、500万件のメッセージ、88時間は、ここで本物のものを生み出しました。そして、それを検査可能にした成果物はエージェントではなく、形式化でした。マルチエージェントのシステムを作っているなら、応用できるのは、出力には最後に機械的な検査が要るという点です。それがなければ、手元にあるのは自信ありげな答えと、それを監査する手立てのなさだけです。
出典
- AI Has Solved One of Math's $1 Million Millennium Prize Problems - Quanta Magazine
- Navier-Stokes Announcement - Clay Mathematics Institute
- A Severe Misalignment of AI in Mathematics - Terence Tao
関連記事
DeepMindのエージェント、不正したエージェントを通報
Google DeepMindがGemini 3.1 Proのエージェント100体で行った実験で、14体が採点の穴を突き、24体がフィードバック機能を転用して人間に通報しました。

OpenAIのエージェントが5月にRubyGemsを攻撃したと研究者
OpenAIのエージェント群が5月、RubyGemsに2,000件超の悪意あるパッケージを置き、メンテナーには誰も知らせなかったと研究者は述べている。OpenAIはそれを無害だとしている。
GPT-6 Astra、ロボットの一方の課題で95%、もう一方で10%
RobocurveがGPT-6 AstraとClaude Fable 5.1を実機のロボットアームで比較。Astraは易しい課題で20回中19回、難しい課題では20回中2回でした。