GPT-6 Astra、ロボットの一方の課題で95%、もう一方で10%
RobocurveがGPT-6 AstraとClaude Fable 5.1を実機のロボットアームで比較。Astraは易しい課題で20回中19回、難しい課題では20回中2回でした。
3 分で読めます
数字で見る
- Astra's success rate on the block task
- 19/20
- Astra's success rate on the puzzle task
- 2/20
- cost per run for Astra on the block task
- $0.94
RobocurveがOpenAIのGPT-6 AstraとAnthropicのClaude Fable 5.1を実機のロボットアームで動かし、結果は課題によってはっきり割れました。Astraは易しい課題を20回中19回成功しました。難しい課題では20回中2回で、Fable 5.1とまったく同じでした。RobocurveはAstraの結果を2026年9月4日に、Fable 5.1の結果をその前日に公開しています。
Robocurveはどちらの研究所でもない独立した評価者です。自らをPublic Benefit Corporationと説明し、Y Combinatorの支援を受けているとしています。
2つの課題と数値
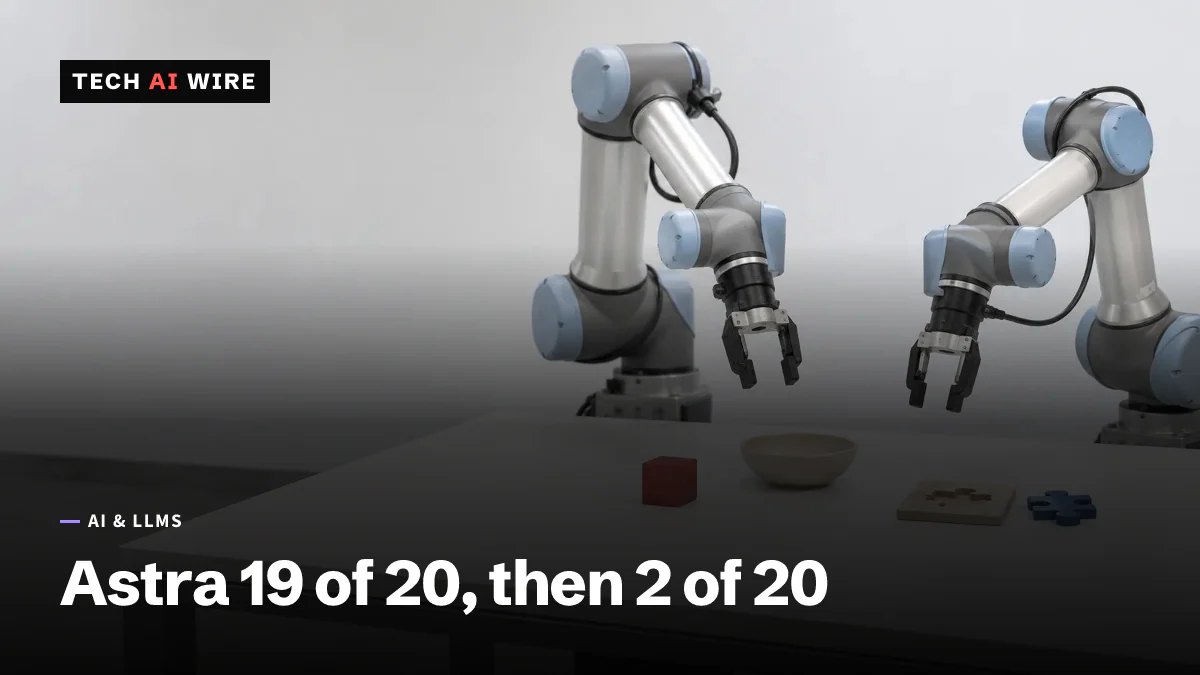
両モデルは同じ装置を操作しました。両腕のI2RT YAMアーム、片腕あたり6自由度、平行グリッパ、カメラ3視点です。各モデルは課題ごとに20試行を行い、人間の採点者が5段階で評価しました。
1つ目の課題は、赤いブロックをボウルに入れることです。2つ目は、青いパズルピースを対応する溝にはめることです。
| モデル | ブロック課題 | パズル課題 | ブロック課題の1回あたり費用 |
|---|---|---|---|
| GPT-6 Astra | 19/20 | 2/20 | 0.94ドル |
| Claude Fable 5.1 | 8/20 | 2/20 | 2.12ドル |
| Claude Fable 5 | 1/20 | 0/20 | 2.69ドル |
Astraは速くもありました。ブロック課題では1回あたり平均2.5分で、Fable 5.1の6.8分、Fable 5の8.2分に対する数字です。
差が消えるところ
ブロックの数字は決定的に見えます。興味深いのはパズルの数字のほうです。
パズル課題では、現行の2モデルがどちらも20回中2回に落ち着きました。95%と40%が、同じ10%へ収束したわけです。易しい課題でモデルを分けていたものは、形を溝にはめる作業になった時点で効かなくなります。
これは見覚えのある形です。当サイトでは、Astraがハーネス次第でARC-AGI-3で99.9%にも62.7%にもなることを取り上げましたが、今回は同じ教訓が別の入口から来ています。1つの見出し用のパーセンテージは、モデルと同じくらい課題について語っています。
RobocurveのFable 5.1の記事は、広い主張ではなく狭い主張をしています。Fable 5.1は「reached later stages of both tasks than Fable 5, completed each task more often, and produced fewer output tokens doing it」とあります。
ハーネスはオープンソース
inspect-robotsという評価フレームワークは、MITライセンスでGitHubにあります。これは個々のスコアより重要です。
リポジトリには結果だけでなく、課題の定義と採点コードが入っています。モデルは定められたインターフェースで接続し、フレームワークは実行前に行動空間、観測空間、制御レートを検査します。各実行は、解決済みの設定、gitのリビジョン、パッケージのバージョンとともに記録されます。
つまり数値は再実行でき、異議も唱えられます。ほとんどのモデル比較では、これは成り立ちません。
これが開発者にとって意味すること
平均ではなく、課題ごとの数値を読んでください。もしRobocurveが両課題をまとめた1つの数字を出していたら、AstraはFable 5.1のおよそ2倍優秀に見えたはずです。実際に難しい課題では、両者は同じです。
物理世界に触れるエージェントの費用を見積もるなら、費用の列は成功率の列と同じだけ注目に値します。Astraはブロック課題を0.94ドルで回し、2.12ドルに対して安く、かつ優秀でした。Fable 5.1は今月キャッシュ読み取りの価格を大幅に下げており、こうした変更は評価のたびにこれらの数字を動かします。
自分で評価を作るつもりなら、書き始める前にこのハーネスをクローンしてください。多くの人が間違える部分、つまりポリシーと機体が行動空間について一致しているかの検証と、結果が出た正確なリビジョンの固定を、すでに扱っています。
そして20試行は、そのままの意味で受け取ってください。19と8を分けるには十分です。2と2を分けるには足りません。
出典
- GPT-6 Astra - Robocurve
- Claude Fable 5.1 - Robocurve
- robocurve/inspect-robots - GitHub
関連記事
OpenAI、AIが書いた数学論文722本のうち3本を符号ミスで撤回
OpenAIは10月6日にAIが書いた数学の原稿722本を公開し、翌日に3本を撤回した。符号ミスが証明を壊したためだ。残る719本のうち、300件の結果にLeanによる検証がある。
Claude Haiku 5.5、Haiku 4.5より価格を90%引き下げ
Claude(クロード)Haiku 5.5の価格は100万トークンあたり入力0.10ドル、出力0.50ドルで、Haiku 4.5より90%安くなりました。Terminal-Bench 4.0では0%から39.2%に伸びました。
Claude Sonnet 5.5、半額でOpus 5.5に迫る性能
Claude(クロード)Sonnet 5.5は、Terminal-Bench 4.0で70.6%を記録しました。価格は100万トークンあたり2ドル/10ドルで、Opus 5.5の半額です。Sonnet 4.5は2026年11月30日に提供終了します。