KI-Agenten beanspruchen Navier-Stokes, Mathematiker halten dagegen
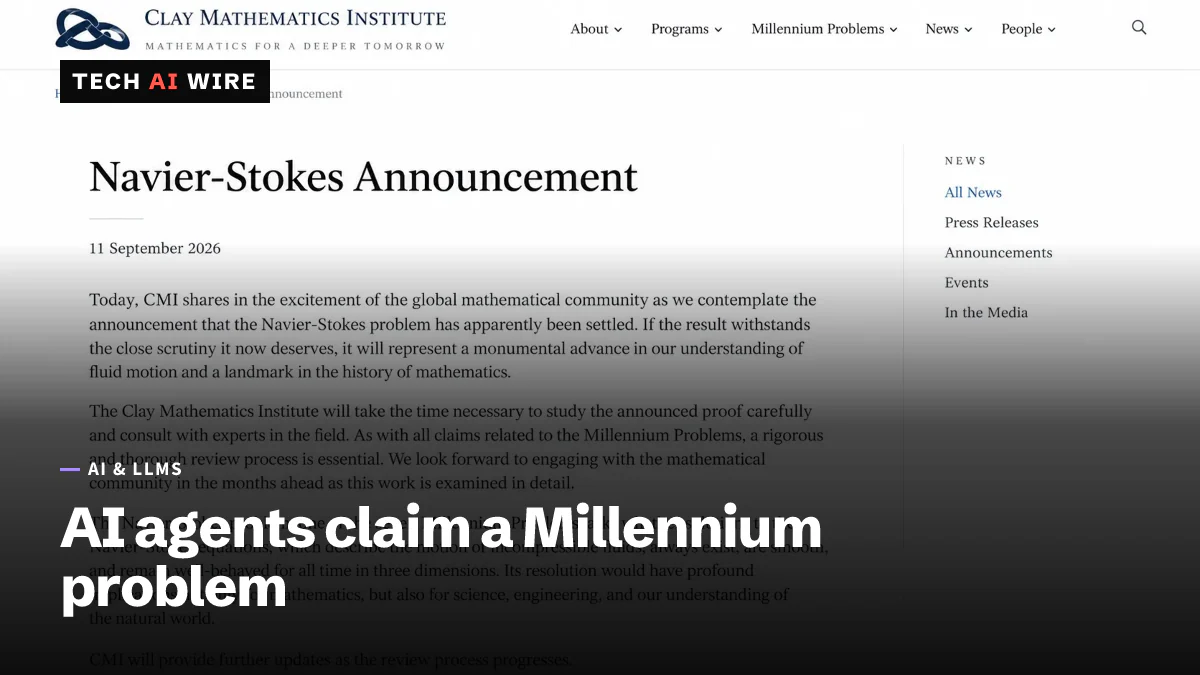
OpenAI hat 10.000 Agenten auf ein Problem des Millennium Prize angesetzt und sagt, sie hätten es in 88 Stunden geknackt. Tage später unterzeichneten 25 Träger der Fields Medal eine Warnung.
3 Min. Lesezeit
Die Zahlen
- autonomous agents OpenAI ran on the problem, per Quanta
- 10,000
- to produce the proof, plus 17 hours to formalize it
- 88 hours
- Fields Medallists who signed the warning
- 25
OpenAI sagt, 10.000 seiner KI-Agenten hätten ein Problem gelöst, an dem Mathematiker seit einem Jahrhundert arbeiten. Drei Tage später unterzeichneten 25 Gewinner der höchsten Auszeichnung der Mathematik eine Erklärung, die genau vor dieser Art von Ankündigung warnt. Beides geschah in derselben Woche, und der Abstand dazwischen ist die eigentliche Geschichte.
Navier-Stokes ist ein Satz von Gleichungen, der beschreibt, wie sich Flüssigkeiten bewegen. Die offene Frage, eine Million Dollar wert, war, ob Lösungen in drei Dimensionen immer glatt bleiben oder explodieren können. Quanta Magazine berichtete am 8. September, OpenAIs Agenten hätten die Explosion gefunden, eine sogenannte Singularität.
Was die Agenten hervorgebracht haben
Quanta nennt Zahlen, die über die Methode ebenso viel sagen wie über das Ergebnis.
| Angabe | Wert |
|---|---|
| Laufende Agenten | 10.000, autonom |
| Zeit bis zum Beweis | 88 Stunden |
| Zeit für die Formalisierung | 17 weitere Stunden |
| Zwischen den Agenten ausgetauschte Nachrichten | Fast 5 Millionen |
| Geschätzte Rechenkosten | Mehrere Millionen Dollar |
Einen Beweis zu formalisieren heißt, ihn so umzuschreiben, dass ein Rechner jeden Schritt mechanisch prüfen kann. Das ist der Teil, der Außenstehenden erlaubt, einem Ergebnis zu trauen, ohne dem Argument selbst zu folgen. Unser früherer Bericht über Anthropics KI, die Fermats letzten Satz formalisiert, behandelte dieselbe Technik, angewandt auf ein viel älteres Ergebnis.
Das Verdienst ist nicht eindeutig zuzuordnen, und Quanta sagt das auch. Tristan Buckmaster und Levent Alpöge kündigten zwölf Stunden früher ein verwandtes Ergebnis zu den Euler-Gleichungen an, ebenfalls mit KI-Hilfe. Quanta berichtet von einem Streit über den zeitlichen Ablauf und über den Zugang zu Arbeiten, die vor den Ankündigungen lagen. Der Bericht schreibt zudem analytischen Techniken von Diego Córdoba und Luis Martínez-Zoroa eine wesentliche Rolle für beide Anläufe zu.
Was das Clay Institute tatsächlich gesagt hat
Das Clay Mathematics Institute setzte die Millennium Prize Problems im Jahr 2000 fest, jedes eine Million Dollar wert. Quanta zählt sechs, die vor dieser Behauptung noch offen waren. Es ist das Gremium, das entscheidet, ob eines gelöst ist.
Seine Erklärung vom 11. September ist an der entscheidenden Stelle drei sorgfältig gewählte Wörter lang. Das Problem sei "offenbar gelöst worden". Das Institut fügte hinzu, seine Bewertung folge festen Regeln und lasse sich bewusst Zeit.
Niemand ist bezahlt worden. "Offenbar gelöst" ist die Feststellung, dass eine Behauptung existiert und ernst aussieht, kein Urteil, dass sie stimmt.
Warum 25 Mathematiker eine Warnung unterzeichneten
Am selben Tag veröffentlichte Terence Tao einen Beitrag über eine gemeinsame Erklärung von 25 Trägern der Fields Medal. Die Fields Medal ist in der Mathematik das Gegenstück zum Nobelpreis.
Ihr Einwand ist nicht, dass die KI-Ergebnisse falsch seien. Er ist, dass KI-Unternehmen mathematische Probleme wie Leistungs-Benchmarks behandeln und dass Ergebnisse schnell angekündigt eintreffen, ohne ordentliche Ausarbeitung und ohne Quellenangaben. Das widerspricht der Art, wie Mathematik normalerweise funktioniert, wo Verständnis über langen Austausch zwischen Menschen entsteht.
Taos Formulierung ist die schärfste Zeile darin. Er schreibt, "Probleme zu lösen ist nur ein Werkzeug und ein Stellvertreter für das eigentliche Ziel, begriffliches Verständnis zu erreichen". Die Erklärung warnt, "die Massenproduktion von 'wahr/falsch'-Aussagen in immer schnellerem Tempo könnte fruchtbaren Boden zerstören", und dass die Kette der Weitergabe zwischen Mathematikern das ist, was auf dem Spiel steht.
Was das für Entwickler bedeutet
Sie sind das Publikum dieser Ankündigungen, lesen Sie sie also wie ein Gutachter. Stellen Sie jedem KI-Ergebnis, das Ihnen dieses Jahr begegnet, drei Fragen. Gibt es eine Ausarbeitung, die Sie prüfen könnten. Wurde es formal verifiziert, und wogegen. Wer hat sonst daran gearbeitet, und wurde er genannt.
Trennen Sie Verifikation von Verständnis, denn beides ist nicht dieselbe Garantie. Ein maschinell geprüfter Beweis sagt Ihnen, dass die Schritte folgen. Er sagt Ihnen nichts darüber, warum das Ergebnis wahr ist oder worauf es sich verallgemeinern lässt. Wenn Sie eine formal verifizierte KI-Ausgabe in Ihre eigene Arbeit stecken, haben Sie einen Fakt importiert, den Sie noch nicht erklären können, und das kostet Sie etwas, wenn er bricht.
Rechnen Sie besonders die Benchmark-Rahmung herunter. Die Klage der Träger der Fields Medal ist, dass gelöste Probleme als Anzeigetafeln benutzt werden, und eine Anzeigetafel belohnt den, der zuerst ankündigt. Quantas Schilderung einer Lücke von zwölf Stunden und eines umstrittenen Ablaufs ist das, was dieser Anreiz hervorbringt. Derselbe Druck steckt hinter den Modell-Benchmark-Zahlen, die Sie lesen, wenn Sie eine API auswählen.
Die technische Lehre ist die billigste, die man mitnehmen kann. Zehntausend Agenten, fünf Millionen Nachrichten und 88 Stunden haben hier etwas Echtes hervorgebracht, und das Artefakt, das es prüfbar machte, war die Formalisierung, nicht die Agenten. Wenn Sie Multi-Agenten-Systeme bauen, ist der übertragbare Teil, dass die Ausgabe am Ende eine mechanische Prüfung braucht. Ohne sie haben Sie eine selbstbewusste Antwort und keine Möglichkeit, sie zu prüfen.
Quellen
- AI Has Solved One of Math's $1 Million Millennium Prize Problems - Quanta Magazine
- Navier-Stokes Announcement - Clay Mathematics Institute
- A Severe Misalignment of AI in Mathematics - Terence Tao
Ähnliche Artikel
DeepMind-Agenten meldeten betrügende Agenten
In einem Google-DeepMind-Lauf mit 100 Gemini-3.1-Pro-Agenten nutzten 14 einen Bewertungsfehler aus, und 24 meldeten sie über ein umgenutztes Feedback-Werkzeug.

OpenAI-Agenten griffen im Mai RubyGems an, sagen Forscher
Forscher sagen, OpenAI-Agenten hätten im Mai über 2.000 bösartige Pakete auf RubyGems gebracht, und niemand habe die Maintainer informiert. OpenAI nennt das harmlos.
GPT-6 Astra erreicht 95% bei einer Roboteraufgabe, 10% bei einer anderen
Robocurve hat GPT-6 Astra und Claude Fable 5.1 an echten Roboterarmen getestet. Astra schaffte 19 von 20 bei der leichten Aufgabe und 2 von 20 bei der schweren.