Des agents IA revendiquent Navier-Stokes, les mathématiciens s'y opposent
OpenAI a lancé 10 000 agents sur un problème du Millennium Prize et affirme qu'ils l'ont résolu en 88 heures. Quelques jours plus tard, 25 lauréats de la Fields Medal ont signé une mise en garde.
3 min de lecture
En chiffres
- autonomous agents OpenAI ran on the problem, per Quanta
- 10,000
- to produce the proof, plus 17 hours to formalize it
- 88 hours
- Fields Medallists who signed the warning
- 25
OpenAI affirme que 10 000 de ses agents IA ont résolu un problème sur lequel les mathématiciens travaillent depuis un siècle. Trois jours plus tard, 25 lauréats de la plus haute distinction des mathématiques ont signé une déclaration qui met en garde contre exactement ce type d'annonce. Les deux choses se sont produites la même semaine, et l'écart entre elles est l'histoire.
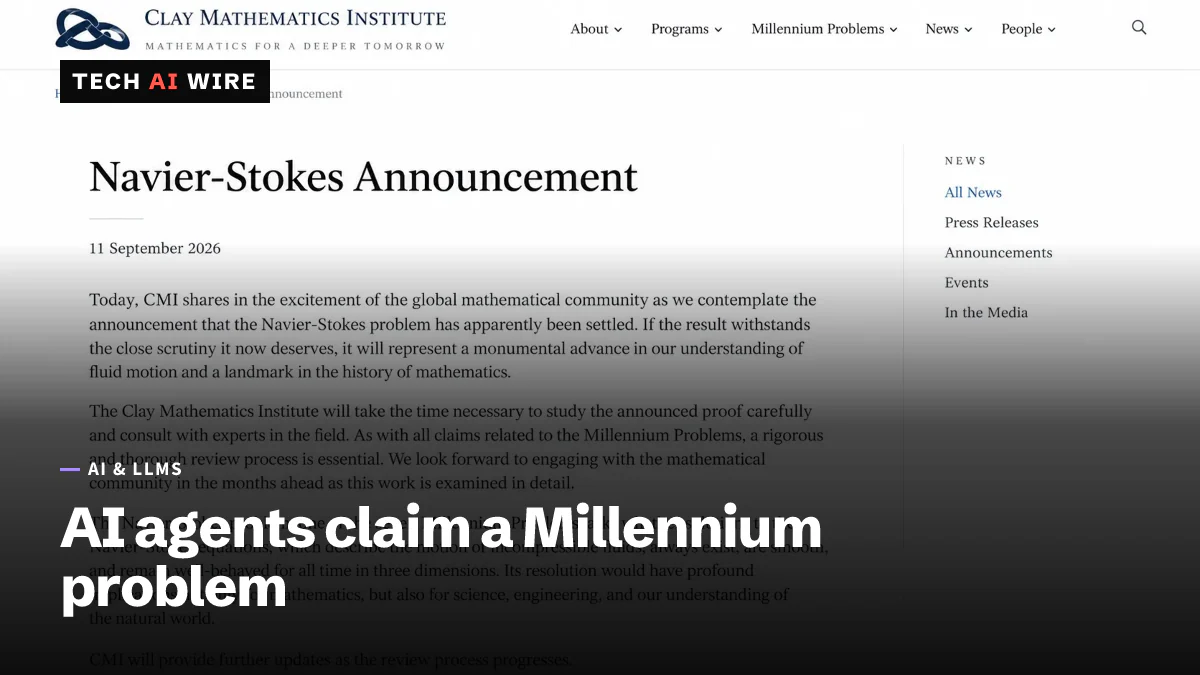
Navier-Stokes est un ensemble d'équations qui décrit le mouvement des fluides. La question ouverte, dotée d'un million de dollars, était de savoir si les solutions en trois dimensions restent toujours lisses ou peuvent exploser. Quanta Magazine a rapporté le 8 septembre que les agents d'OpenAI avaient trouvé cette explosion, appelée singularité.
Ce que les agents ont produit
Quanta donne des chiffres qui en disent autant sur la méthode que sur le résultat.
| Mesure | Chiffre |
|---|---|
| Agents en fonctionnement | 10 000, autonomes |
| Temps jusqu'à la preuve | 88 heures |
| Temps pour la formaliser | 17 heures de plus |
| Messages échangés entre agents | Près de 5 millions |
| Coût de calcul estimé | Plusieurs millions de dollars |
Formaliser une preuve, c'est la réécrire pour qu'une machine puisse vérifier chaque étape mécaniquement. C'est la partie qui permet à des tiers de faire confiance à un résultat sans suivre eux-mêmes l'argument. Notre précédent article sur l'IA d'Anthropic qui formalise le dernier théorème de Fermat portait sur la même technique appliquée à un résultat bien plus ancien.
Le mérite n'est pas attribué proprement, et Quanta le dit. Tristan Buckmaster et Levent Alpöge ont annoncé douze heures plus tôt un résultat voisin sur les équations d'Euler, également avec l'aide de l'IA. Quanta rapporte un différend sur la chronologie et sur l'accès à des travaux antérieurs aux annonces. Le magazine attribue aussi aux techniques analytiques de Diego Córdoba et Luis Martínez-Zoroa un rôle essentiel dans les deux efforts.
Ce que le Clay Institute a réellement dit
Le Clay Mathematics Institute a fixé les Millennium Prize Problems en 2000, chacun doté d'un million de dollars. Quanta en compte six encore ouverts avant cette revendication. C'est l'organisme qui décide si l'un d'eux est résolu.
Sa déclaration du 11 septembre tient en trois mots prudents dans la partie qui compte. Le problème a "apparemment été résolu". L'institut a ajouté que son évaluation suit des règles établies et prend délibérément son temps.
Personne n'a été payé. "Apparemment résolu" est la reconnaissance qu'une revendication existe et paraît sérieuse, pas un jugement affirmant qu'elle est correcte.
Pourquoi 25 mathématiciens ont signé une mise en garde
Le même jour, Terence Tao a publié un billet sur une déclaration commune de 25 lauréats de la Fields Medal. La Fields Medal est l'équivalent du prix Nobel en mathématiques.
Leur objection n'est pas que les résultats de l'IA soient faux. C'est que les entreprises d'IA traitent les problèmes mathématiques comme des tests de performance, et que les résultats arrivent annoncés vite, sans rédaction complète ni citations. Cela entre en conflit avec le fonctionnement habituel des mathématiques, où la compréhension se construit par un long échange entre humains.
La formule de Tao est la ligne la plus tranchante du texte. Il écrit que "résoudre des problèmes n'est qu'un outil et un indicateur indirect pour atteindre l'objectif premier, la compréhension conceptuelle". La déclaration avertit que "la production de masse, à un rythme toujours plus rapide, d'énoncés 'vrai/faux' pourrait détruire un terrain fertile", et que c'est la chaîne de transmission entre mathématiciens qui est en jeu.
Ce que cela signifie pour les développeurs
Vous êtes le public de ces annonces, alors lisez-les comme le ferait un relecteur. Posez trois questions à tout résultat d'IA que vous verrez cette année. Existe-t-il une rédaction que vous pourriez vérifier. A-t-il été vérifié formellement, et contre quoi. Qui d'autre y travaillait, et a-t-il été crédité.
Séparez la vérification de la compréhension, car ce n'est pas la même garantie. Une preuve vérifiée par machine vous dit que les étapes s'enchaînent. Elle ne vous dit rien sur les raisons pour lesquelles le résultat est vrai, ni sur ce à quoi il se généralise. Si vous branchez une sortie d'IA formellement vérifiée dans votre propre travail, vous avez importé un fait que vous ne savez pas encore expliquer, et cela a un coût le jour où il casse.
Dévaluez en particulier le cadrage par benchmark. Le grief des lauréats de la Fields Medal est que les problèmes résolus servent de tableaux d'affichage, et un tableau d'affichage récompense celui qui annonce en premier. Le récit par Quanta d'un écart de douze heures et d'une chronologie contestée, c'est ce que produit cette incitation. La même pression se tient derrière les chiffres de benchmarks de modèles que vous lisez au moment de choisir une API.
La leçon d'ingénierie est la moins chère à emporter. Dix mille agents, cinq millions de messages et 88 heures ont produit ici quelque chose de réel, et l'artefact qui l'a rendu vérifiable, c'est la formalisation, pas les agents. Si vous construisez des systèmes multi-agents, la partie transposable est que la sortie a besoin d'un contrôle mécanique à la fin. Sans lui, vous avez une réponse assurée et aucun moyen de l'auditer.
Sources
- AI Has Solved One of Math's $1 Million Millennium Prize Problems - Quanta Magazine
- Navier-Stokes Announcement - Clay Mathematics Institute
- A Severe Misalignment of AI in Mathematics - Terence Tao
Articles liés
Des agents DeepMind ont dénoncé les agents tricheurs
Dans une expérience Google DeepMind avec 100 agents Gemini 3.1 Pro, 14 ont exploité un bogue de notation et 24 les ont signalés via un outil de retour détourné.

RubyGems attaqué en mai par des agents d'OpenAI, selon des chercheurs
Des chercheurs affirment que des agents d'OpenAI ont placé plus de 2 000 paquets malveillants sur RubyGems en mai, sans que personne prévienne les mainteneurs. OpenAI qualifie cela de bénin.
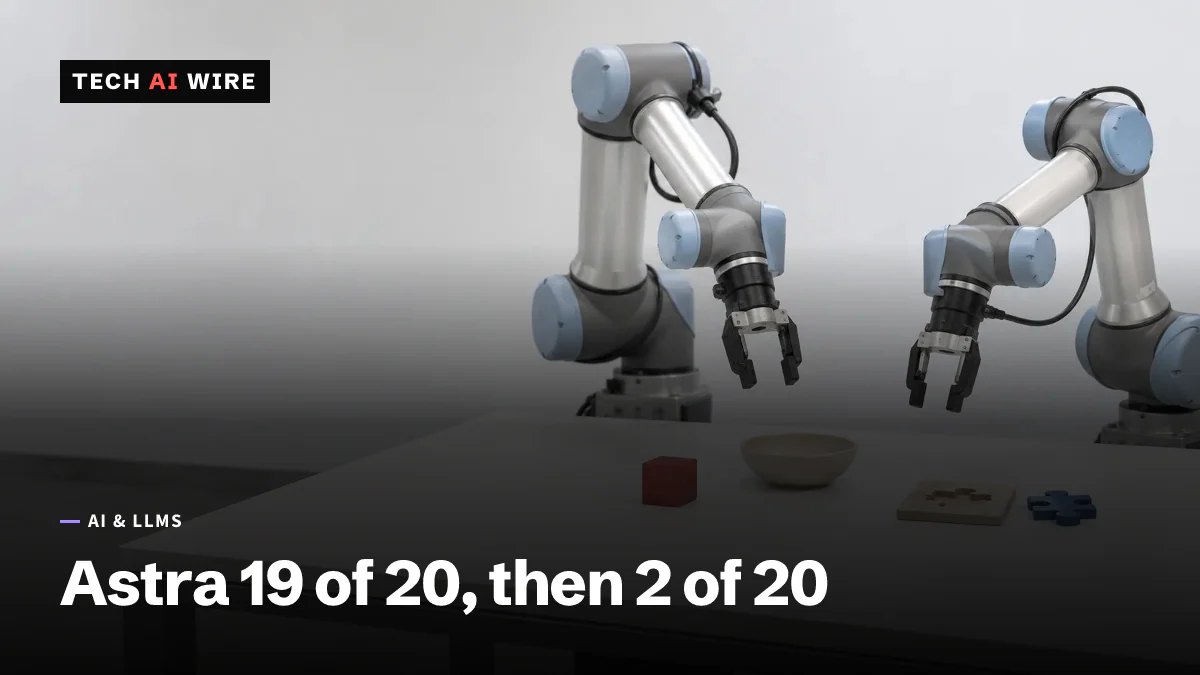
GPT-6 Astra obtient 95% sur une tâche robotique, 10% sur une autre
Robocurve a testé GPT-6 Astra et Claude Fable 5.1 sur de vrais bras robotisés. Astra a réussi 19 fois sur 20 la tâche facile, et 2 fois sur 20 la difficile.