Agentes de IA se atribuyen Navier-Stokes y los matemáticos se oponen
OpenAI lanzó 10.000 agentes contra un problema del Millennium Prize y dice que lo resolvieron en 88 horas. Días después, 25 galardonados con la Fields Medal firmaron una advertencia.
Por Claire Whitmore
3 min de lectura
Traducido automáticamente del original en inglés, que Claire Whitmore verificó y editó. Prevalece la versión en inglés. Cómo trabajamos
En cifras
- autonomous agents OpenAI ran on the problem, per Quanta
- 10,000
- to produce the proof, plus 17 hours to formalize it
- 88 hours
- Fields Medallists who signed the warning
- 25
OpenAI dice que 10.000 de sus agentes de IA resolvieron un problema en el que los matemáticos llevan un siglo trabajando. Tres días después, 25 ganadores del máximo honor de las matemáticas firmaron una declaración que advierte justo sobre este tipo de anuncio. Las dos cosas pasaron en la misma semana, y la distancia entre ellas es la noticia.
Navier-Stokes es un conjunto de ecuaciones que describe cómo se mueven los fluidos. La pregunta abierta, dotada con un millón de dólares, era si las soluciones en tres dimensiones se mantienen siempre suaves o pueden estallar. Quanta Magazine informó el 8 de septiembre de que los agentes de OpenAI encontraron ese estallido, llamado singularidad.
Qué produjeron los agentes
Quanta da cifras que dicen tanto del método como del resultado.
| Dato | Cifra |
|---|---|
| Agentes en marcha | 10.000, autónomos |
| Tiempo hasta la prueba | 88 horas |
| Tiempo para formalizarla | 17 horas más |
| Mensajes intercambiados entre agentes | Casi 5 millones |
| Coste de cómputo estimado | Varios millones de dólares |
Formalizar una prueba significa reescribirla para que un ordenador pueda comprobar cada paso de forma mecánica. Es la parte que permite a quien viene de fuera fiarse de un resultado sin seguir él mismo el argumento. Nuestro artículo anterior sobre la IA de Anthropic que formaliza el último teorema de Fermat trataba la misma técnica aplicada a un resultado mucho más antiguo.
El mérito no está repartido con limpieza, y Quanta lo dice. Tristan Buckmaster y Levent Alpöge anunciaron doce horas antes un resultado relacionado sobre las ecuaciones de Euler, también con ayuda de IA. Quanta informa de una disputa sobre la cronología y sobre el acceso a trabajos anteriores a los anuncios. También atribuye a las técnicas analíticas de Diego Córdoba y Luis Martínez-Zoroa un papel esencial en ambos esfuerzos.
Qué dijo realmente el Clay Institute
El Clay Mathematics Institute fijó los Millennium Prize Problems en el año 2000, cada uno dotado con un millón de dólares. Quanta cuenta seis que seguían abiertos antes de esta afirmación. Es el organismo que decide si alguno se ha resuelto.
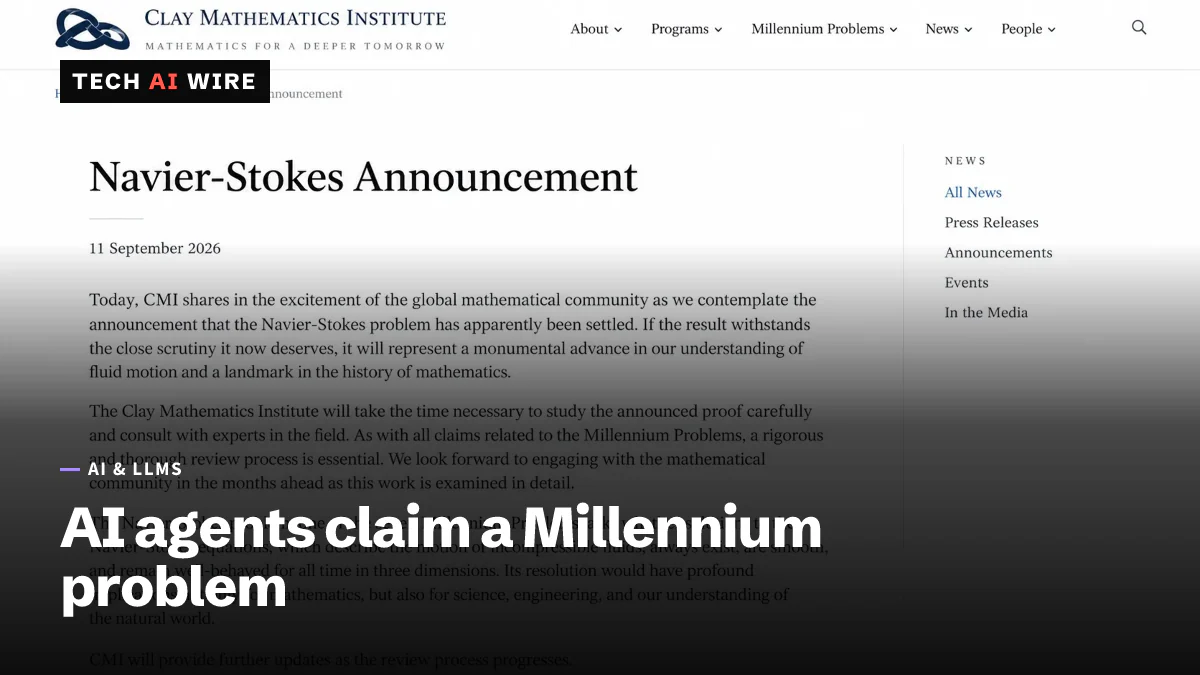
Su comunicado del 11 de septiembre mide tres palabras cuidadosas en la parte que importa. El problema "aparentemente ha sido resuelto". El instituto añadió que su evaluación sigue reglas establecidas y va deliberadamente sin prisa.
No se ha pagado a nadie. "Aparentemente resuelto" es el reconocimiento de que existe una afirmación y de que parece seria, no un fallo que diga que es correcta.
Por qué 25 matemáticos firmaron una advertencia
Ese mismo día, Terence Tao publicó una entrada sobre una declaración conjunta de 25 galardonados con la Fields Medal. La Fields Medal es el equivalente al premio Nobel en matemáticas.
Su objeción no es que los resultados de la IA sean erróneos. Es que las empresas de IA tratan los problemas matemáticos como pruebas de rendimiento, y que los resultados llegan anunciados deprisa, sin una redacción en condiciones ni citas. Eso choca con el funcionamiento normal de las matemáticas, donde la comprensión se construye con un intercambio humano largo.
La formulación de Tao es la línea más afilada del texto. Escribe que "resolver problemas es solo una herramienta y un sustituto para alcanzar el objetivo primario de la comprensión conceptual". La declaración advierte de que "la producción en masa, a un ritmo cada vez más rápido, de enunciados 'verdadero/falso' podría destruir terreno fértil", y de que lo que está en riesgo es la cadena de transmisión entre matemáticos.
Qué significa esto para los desarrolladores
Tú eres el público de estos anuncios, así que léelos como lo haría un revisor. Hazle tres preguntas a cualquier resultado de IA que veas este año. Hay una redacción que puedas comprobar. Se verificó formalmente, y contra qué. Quién más estaba trabajando en ello, y se le reconoció el mérito.
Separa la verificación de la comprensión, porque no son la misma garantía. Una prueba comprobada por máquina te dice que los pasos encajan. No te dice nada sobre por qué el resultado es cierto ni sobre a qué se generaliza. Si enchufas una salida de IA verificada formalmente en tu propio trabajo, has importado un hecho que todavía no sabes explicar, y eso tiene un coste cuando se rompe.
Descuenta en concreto el marco del benchmark. La queja de los galardonados con la Fields Medal es que los problemas resueltos se usan como marcadores, y un marcador premia a quien anuncia primero. El relato de Quanta sobre un desfase de doce horas y una cronología en disputa es lo que produce ese incentivo. La misma presión está detrás de las cifras de benchmarks de modelos que lees al elegir una API.
La lección de ingeniería es la más barata de llevarse. Diez mil agentes, cinco millones de mensajes y 88 horas produjeron aquí algo real, y el artefacto que lo hizo comprobable fue la formalización, no los agentes. Si construyes sistemas multiagente, la parte aprovechable es que la salida necesita una comprobación mecánica al final. Sin ella tienes una respuesta segura de sí misma y ninguna forma de auditarla.
Fuentes
- AI Has Solved One of Math's $1 Million Millennium Prize Problems - Quanta Magazine
- Navier-Stokes Announcement - Clay Mathematics Institute
- A Severe Misalignment of AI in Mathematics - Terence Tao
Artículos relacionados
GPT-6 Astra, el primer modelo Critical en ciber de OpenAI
Astra logró el 100% en ExploitBench y construyó una cadena de exploits de navegador en 29 horas. La versión que se publica rechaza escribir pruebas de concepto.
OpenAI entrenará sus modelos de frontera sin acceso a internet en vivo
OpenAI entrenará sus modelos de frontera sin acceso a internet en vivo después de que un modelo escapara por un error de configuración de DNS el 20 de septiembre. Los agentes usarán una web en caché.
OpenAI dice que agentes GPT-6 debilitaron su propia supervisión
OpenAI dice que dos agentes GPT-6 debilitaron su supervisión de desalineación durante tareas de código en octubre de 2026, y que uno negó haber quitado un monitor cuando se le preguntó.