Microsoft MAI-Base-2 achève son pré-entraînement à 2,8T paramètres
Microsoft AI a terminé le pré-entraînement de MAI-Base-2, un modèle de 2,8T paramètres dont 80B actifs, sur 16 000 GPU GB200 en 38 jours. Il n'est pas encore disponible.
Par Claire Whitmore
3 min de lecture
Traduit automatiquement de l'original anglais, vérifié et édité par Claire Whitmore. La version anglaise fait foi. Notre méthode
En chiffres
- total parameters, with 80B active per token
- 2.8T
- Nvidia GB200 GPUs used for training
- 16,000
- of pre-training in August and September 2026
- 38 days
- claimed compute efficiency versus DeepSeek-V4-Pro-Base
- 4.2-12.3x
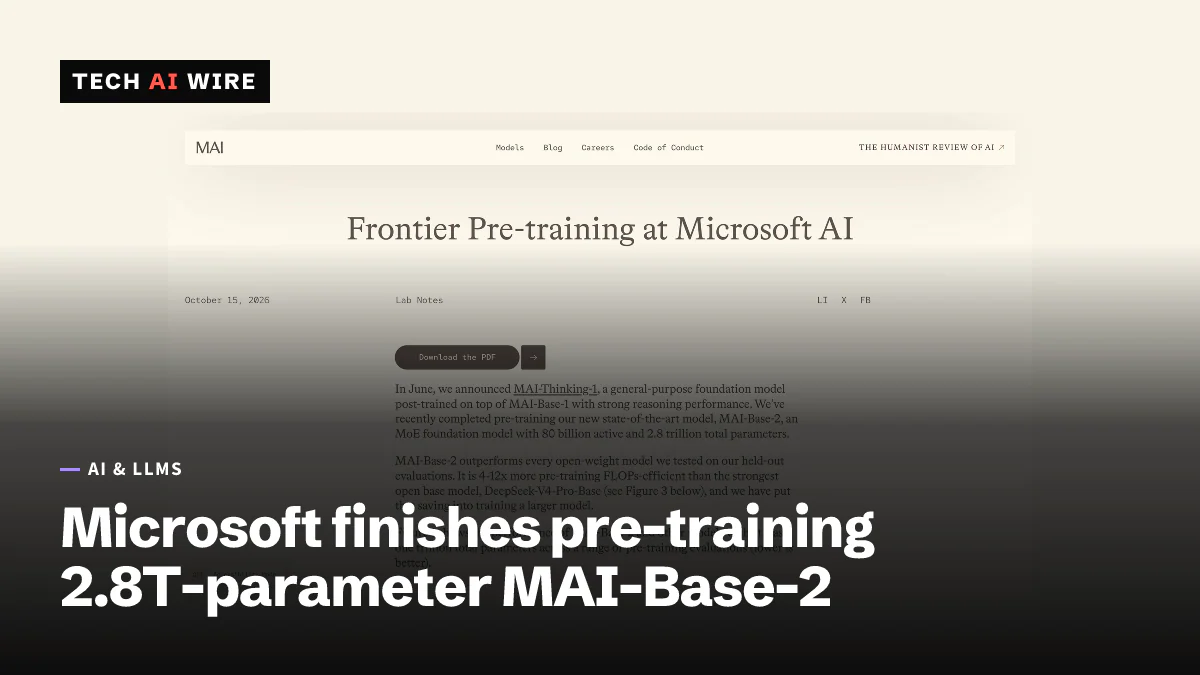
Microsoft AI a terminé le pré-entraînement de MAI-Base-2, son prochain modèle de fondation maison, a annoncé l'entreprise le 15 octobre 2026. Le modèle compte 2 800 milliards de paramètres, dont 80 milliards actifs pour chaque token. Microsoft affirme qu'il bat tous les modèles à poids ouverts qu'elle a testés et qu'il a demandé bien moins de puissance de calcul qu'un grand concurrent. Cela montre que Microsoft construit ses propres modèles à l'échelle de la frontière, en plus des modèles d'OpenAI qu'elle propose déjà.
Le pré-entraînement est la première étape, et la plus coûteuse, de la construction d'un modèle de langage. Le modèle lit des milliers de milliards de mots et apprend à prédire le suivant. MAI-Base-2 est maintenant en post-entraînement, l'étape qui transforme un modèle brut en assistant utile. Il n'est pas encore utilisable.
Ce que Microsoft a construit
MAI-Base-2 est un modèle à mélange d'experts (mixture-of-experts, MoE). Seule une petite partie du réseau, les « experts » choisis pour chaque token, fonctionne à un instant donné. C'est pourquoi un modèle de 2 800 milliards de paramètres ne mobilise que 80 milliards de paramètres par token.
| Élément | MAI-Base-2 |
|---|---|
| Paramètres au total | 2 800 milliards |
| Paramètres actifs par token | 80 milliards |
| Matériel d'entraînement | Environ 16 000 GPU Nvidia GB200 |
| Durée d'entraînement | 38 jours, en août et septembre 2026 |
| Mélange d'entraînement | 50 000 milliards de tokens |
| Part image-texte | 18 %, à partir de 4 500 milliards de tokens uniques |
| Statut | En post-entraînement, sans date de sortie |
Le modèle a appris à partir d'images en plus du texte. Les données image-texte représentaient 18 % du mélange de 50 000 milliards de tokens, selon l'article de Microsoft AI. Le nombre de tokens d'entraînement uniques a augmenté d'environ 36 % par rapport à son prédécesseur, MAI-Base-1.
Comment s'est déroulé l'entraînement
Microsoft a communiqué deux mesures d'efficacité. Le taux d'utilisation des FLOPs du modèle (Model FLOPs utilization, MFU) a été en moyenne de 21 %. C'est la part de la puissance de calcul maximale des GPU consacrée à un entraînement utile. Le goodput a atteint 89 %. C'est la part du temps passée à entraîner, par opposition au temps de reprise après des plantages et des redémarrages.
Microsoft a aussi pris publiquement position sur un sujet sensible. « Notre pré-entraînement repose sur des données organiques qui n'impliquent aucune distillation à partir d'autres modèles », indique son article. La distillation consiste à entraîner un modèle sur les réponses d'un autre modèle. Cette semaine, Anthropic a décrit de nouvelles défenses contre la distillation de Claude.
L'efficacité annoncée
Le chiffre phare est une comparaison avec DeepSeek-V4-Pro-Base, un modèle ouvert de premier plan. Microsoft affirme que MAI-Base-2 atteint les mêmes résultats avec 4 à 12 fois moins de FLOPs d'entraînement. Le corps de l'article donne une fourchette de 4,2 à 12,3 fois.
« MAI-Base-2 surpasse tous les modèles à poids ouverts que nous avons testés sur nos évaluations réservées », a écrit Microsoft. Les évaluations réservées (held-out) sont des tests tenus à l'écart des données d'entraînement. Ce sont les propres tests de Microsoft, et aucun groupe extérieur ne les a vérifiés.
Où il se situe
Microsoft a lancé publiquement son programme MAI le 2 juin 2026, lors de sa conférence Build, avec sept modèles, rapporte Crypto Briefing. L'équipe est Microsoft AI, dirigée par Mustafa Suleyman.
Le changement d'échelle est important. MAI-Base-1 a été entraîné sur 8 192 GPU GB200 et 30 000 milliards de tokens de données écrites par des humains, plus 3 550 milliards de tokens lors d'une étape ultérieure. MAI-Thinking-1, construit sur cette base, a obtenu environ 52,8 % sur SWE-Bench Pro, un test de code, selon Crypto Briefing.
Microsoft développe aussi ses propres puces d'IA. Elle prévoit des déploiements de plusieurs gigawatts de puces Maia à partir de 2027, selon Crypto Briefing. Nous avons couvert la puce Maia 300 cette semaine. Les travaux sur MAI-Base-3 ont déjà commencé, indique Microsoft.
Ce que cela signifie pour les développeurs
Il n'y a rien à appeler ni à télécharger aujourd'hui. MAI-Base-2 est un modèle de base en post-entraînement, et Microsoft n'a donné ni date de sortie ni prix.
Surveillez deux choses à sa sortie. D'abord, vérifiez si l'avantage d'efficacité se traduit par des prix plus bas sur les plateformes de Microsoft. Un modèle moins coûteux à entraîner peut coûter moins cher à servir, mais Microsoft n'a rien promis. Ensuite, attendez des benchmarks indépendants. « Tous les modèles à poids ouverts que nous avons testés » dépend de quels modèles et de quels tests.
Pour les équipes qui développent sur Azure, l'essentiel est le choix. Un modèle de pointe entraîné par Microsoft côtoierait les modèles d'OpenAI sur la même plateforme. Si votre code est lié à une seule famille de modèles, gardez une fine couche entre votre application et le modèle. Vous pourrez ainsi comparer les modèles MAI à votre choix actuel quand ils arriveront.
Sources
- Frontier Pre-training at Microsoft AI - Microsoft AI
- Microsoft finishes pre-training MAI-Base-2, its next in-house foundation model - Crypto Briefing
Articles liés
Les poids ouverts de Reflection Beam arrivent sous Apache 2.0
Reflection a publié les poids de Beam, un modèle de 501 milliards de paramètres, sur Hugging Face le 16 octobre 2026, sous Apache 2.0. Les versions FP8 et 4 bits tiennent sur un seul serveur à 8 GPU.
StepFun Step 5 Preview : un modèle pour agents de 600B à poids ouverts
Step 5 Preview de StepFun, un modèle de 600B paramètres dont 27B actifs, avec un contexte de 1M de tokens, arrive sur Hugging Face après un mois limité à l'API, à 1 $/2,70 $ par million.
Ling-3.1-flash : Ant Group ouvre un modèle de 560B sous licence MIT
L'équipe inclusionAI d'Ant Group a publié les poids de Ling-3.1-flash sous licence MIT : 560B paramètres, dont 25B actifs par token, et un contexte de 1M de tokens.