Google, OpenAI und Microsoft unterstützen ein gemeinsames Opt-out vom KI-Training
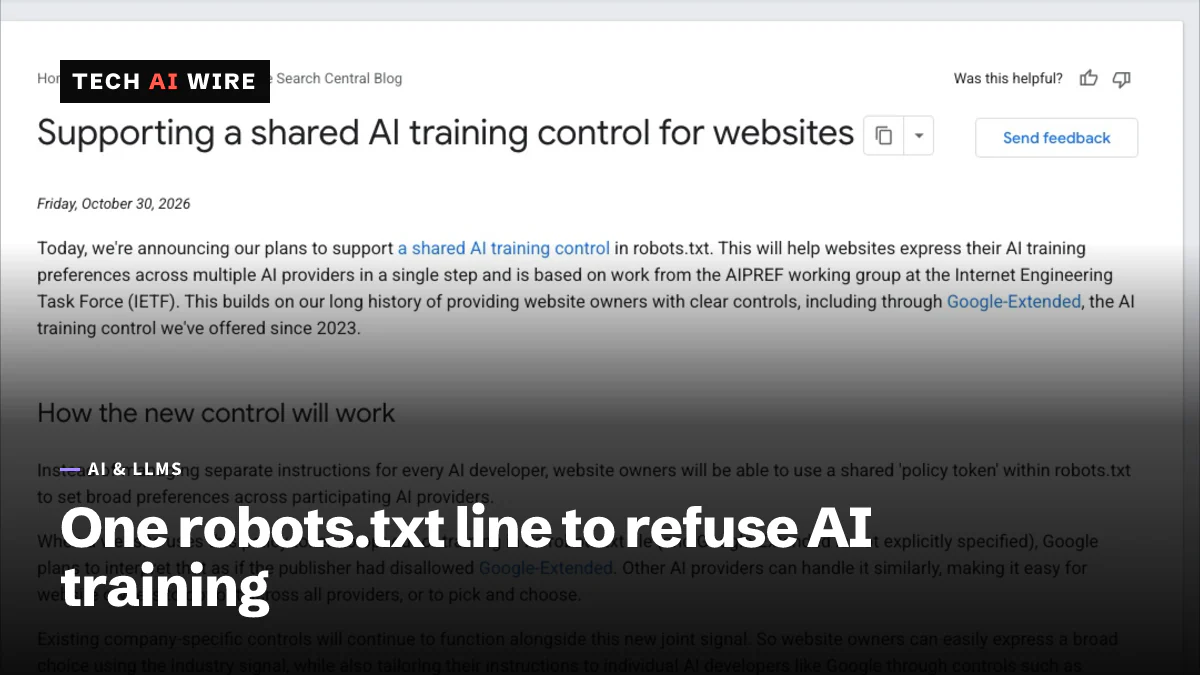
Ein neues robots.txt-Token, __usage_ai-training, erlaubt es einer Website, KI-Training einmal für mehrere Unternehmen abzulehnen. Microsoft beginnt am 1. Februar 2027, es zu beachten.
Von Claire Whitmore
3 Min. Lesezeit
Maschinell übersetzt aus dem englischen Original, das Claire Whitmore auf Fakten geprüft und redigiert hat. Es gilt die englische Fassung. So arbeiten wir
Die Zahlen
- when Microsoft starts honoring the token
- Feb 1, 2027
- when Google aims to support it
- 2027
- when the IETF draft expires unless updated
- May 3, 2027
Website-Betreiber werden KI-Training bald mit einer einzigen Zeile in der robots.txt ablehnen können, statt mit einer Regel pro KI-Unternehmen. Am 30. Oktober 2026 erklärten OpenAI, Google und Microsoft jeweils, sie würden ein gemeinsames Token namens __usage_ai-training beachten, wie PPC Land berichtete. Der Autor des Standardentwurfs, der bei Anthropic arbeitet, sagte, auch Anthropic habe begonnen, die Unterstützung aufzubauen.
Robots.txt ist die einfache Textdatei im Stammverzeichnis einer Website, die Crawlern sagt, was sie abrufen dürfen. Bisher musste eine Website, die sich aus dem KI-Training heraushalten wollte, den Crawler oder die Steuerung jedes Unternehmens einzeln benennen, etwa GPTBot oder Google-Extended.
So funktioniert das neue Token
Das Token steht dort, wo normalerweise der Name eines Crawlers steht, in einer User-Agent-Zeile. Die Regeln darunter nutzen die üblichen Disallow- und Allow-Zeilen. Das eigene Beispiel des Entwurfs lehnt das Training für die ganze Website ab, mit Ausnahme eines Ordners für das Pressekit:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Zwei Details sind wichtig für alle, die die Datei bearbeiten. Eine Wildcard-Gruppe, User-Agent: *, zählt laut dem Entwurf nicht als Trainingspräferenz. Und eine Website ohne __usage_ai-training-Gruppe hat überhaupt keine Präferenz geäußert, was auf jede heute veröffentlichte robots.txt zutrifft, wie Relevant Audience anmerkt.
Der Standard ist ein IETF-Internet-Draft, draft-kelley-aipref-training-preference-signal-00, verfasst von Kevin Kelley. Er ist eine individuelle Einreichung (Individual Submission), von der IETF noch nicht gebilligt, und er läuft am 3. Mai 2027 ab, wenn er nicht aktualisiert wird.
Wer sich festgelegt hat, und wann
| Unternehmen | Was es gesagt hat | Wann |
|---|---|---|
| Microsoft | Wird Trainings- und Grounding-Präferenzen beim Crawlen beachten | 1. Februar 2027 |
| Strebt an, die Steuerung zu unterstützen | 2027 („Anfang 2027“ in seinen Crawler-Dokumenten) | |
| OpenAI | Wird das Signal für „Training grundlegender generativer KI“ beachten | „In den kommenden Monaten“ |
| Anthropic | Der Autor des Entwurfs sagt, die Unterstützung habe begonnen | Kein Datum genannt |
Googles John Mueller schrieb: „Wir streben an, diese neue Steuerung zusammen mit anderen KI-Anbietern 2027 zu unterstützen.“ Lehnt eine Website das Training mit dem gemeinsamen Token ab und hat keine Google-Extended-Regel, plant Google, das als Disallow für Google-Extended zu lesen. Eine ausdrückliche Google-Extended-Regel hat weiterhin Vorrang.
OpenAI sagte laut PPC Land, das neue Signal „wird die Steuerungen, die wir bereits über robots.txt anbieten, nicht ersetzen“. Anthropic hat keine Stellungnahme des Unternehmens veröffentlicht. Kelley schrieb auf der IETF-Mailingliste, „Anthropic hat bereits begonnen, die Unterstützung für diesen Entwurf zu implementieren“, und fügte hinzu, es werde Zeit brauchen, bis die Unterstützung alle Dienste von Anthropic erreiche.
Microsoft geht weiter
Microsofts Plan, den Bings Krishna Madhavan beschrieben hat, ergänzt Steuerungen auf Seitenebene. Eine Seite kann robots.txt mit einem Meta-Tag überschreiben, <meta name="Bingbot" content="ai-training:disallow">, oder mit dem Header X-Robots-Tag: Bingbot: ai-training:disallow.
Bing ergänzt außerdem eine separate Grounding-Präferenz. Grounding heißt, eine Seite als Grundlage für eine KI-Antwort zu nutzen, im Unterschied zum Training eines Modells damit. Die Präferenz funktioniert nur pro Seite, mit den Werten Allow, Disallow und DisallowExtended.
Bings ältere Tags NoArchive und NoCache zählen nach dem 1. März 2027 nicht mehr als KI-Steuerungen, berichtet PPC Land.
Was das Token nicht leistet
Es ist eine Präferenz, kein Schloss. Der Entwurf sagt, das Token „ist keine Anweisung für das Crawling-Verhalten“, sodass Crawler weiterhin Seiten abrufen dürfen. Ein Crawler, der nicht kooperiert, kann es ignorieren, wie TokenPost berichtet.
Eine Änderung der Datei entfernt außerdem keine Inhalte, die bereits für bestehende Modelle gesammelt wurden. Google sagt, Google-Extended wirke sich nicht auf die Aufnahme in die Suche oder das Ranking aus, und Microsoft sagt, an der Eignung für die Bing-Suche ändere sich nichts. PPC Land zitiert Daten von TollBit aus dem August 2026, wonach etwa 15 % der KI-Programme, die Seiten abrufen, in Europa URLs erreichten, die Websites per Disallow gesperrt hatten.
Was das für Entwickler bedeutet
- Fügen Sie die Gruppe jetzt hinzu, wenn Sie aussteigen wollen. Eine
__usage_ai-training-Gruppe kostet heute nichts, und Microsoft beginnt am 1. Februar 2027, sie zu lesen. Legen Sie sie in eine eigene Gruppe, niemals unterUser-Agent: *. - Behalten Sie Ihre bestehenden Regeln. Unternehmensspezifische Gruppen wie GPTBot und Google-Extended gelten weiter, und die spezifischere Regel hat Vorrang. Löschen Sie sie nicht allein auf Basis eines Entwurfs.
- Trennen Sie Training und Suche. Das Ablehnen des Trainings entfernt Sie nicht aus der Google- oder Bing-Suche, sodass es keinen Ranking-Grund gibt, sich zurückzuhalten.
- Planen Sie die Grounding-Umstellung bei Bing ein. Falls Sie NoArchive oder NoCache genutzt haben, um Inhalte aus KI-Antworten herauszuhalten, wechseln Sie vor dem 1. März 2027 zur neuen Grounding-Präferenz auf Seitenebene.
- Sperren Sie Crawler namentlich, wenn Sie einen harten Stopp brauchen. Das Token gibt eine Präferenz zur Nutzung an. Nur ein
Disallowpro Crawler oder eine Sperre auf Ihrem Server stoppt den Abruf selbst.
Quellen
- Google, Microsoft, OpenAI and Anthropic back one AI training opt-out - PPC Land
- Supporting a shared AI training control for websites - Google Search Central
- Google plans to honour a shared AI training opt-out in robots.txt from 2027 - Relevant Audience
- OpenAI Will Honor Shared Robots.txt Signal for AI Training - TokenPost
- OpenAI, Google, Microsoft, Anthropic Back One AI Opt-Out - FourWeekMBA
Ähnliche Artikel
KI-Abkommen des Weißen Hauses verpflichtet sechs Labore zu externen Prüfungen
OpenAI, Google, Meta, Anthropic, Nvidia und xAI haben ein freiwilliges Abkommen des Weißen Hauses unterzeichnet, um Frontier-KI von externen Prüfern kontrollieren zu lassen. Strafen sieht es nicht vor.
Grok 4.7 wählt Republikaner, GPT-6.1 Sol wählt Demokraten
Gezwungen, sich über ihre APIs in fast 500 Rennen der US-Zwischenwahlen festzulegen, wählte Grok 4.7 in 92 % der Fälle den Republikaner und GPT-6.1 Sol in 97 % den Demokraten.
OpenAIs GPT-6-Modelle kommen als Vorschau in die Google Cloud
Google Cloud hat am 21. Oktober 2026 eine private Vorschau von OpenAIs GPT-6 Astra, GPT-6.1 Sol und GPT-6 Luna gestartet, abgerechnet über den eigenen Marketplace.