Google, OpenAI et Microsoft soutiennent un opt-out commun pour l'entraînement de l'IA
Un nouveau jeton robots.txt, __usage_ai-training, permet à un site de refuser l'entraînement de l'IA en une seule fois pour plusieurs entreprises. Microsoft commence à le respecter le 1er février 2027.
Par Claire Whitmore
3 min de lecture
Traduit automatiquement de l'original anglais, vérifié et édité par Claire Whitmore. La version anglaise fait foi. Notre méthode
En chiffres
- when Microsoft starts honoring the token
- Feb 1, 2027
- when Google aims to support it
- 2027
- when the IETF draft expires unless updated
- May 3, 2027
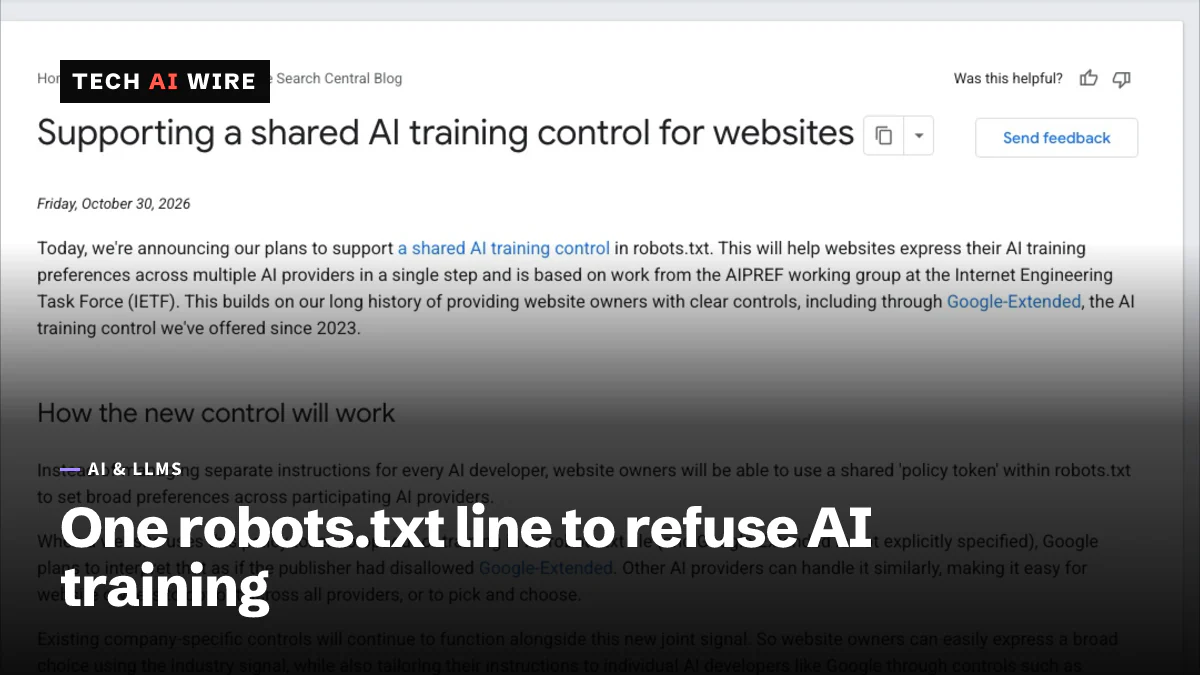
Les propriétaires de sites pourront bientôt refuser l'entraînement de l'IA avec une seule ligne dans robots.txt, au lieu d'une règle par entreprise d'IA. Le 30 octobre 2026, OpenAI, Google et Microsoft ont chacun déclaré qu'ils respecteraient un jeton commun appelé __usage_ai-training, comme l'a rapporté PPC Land. L'auteur du projet de standard, qui travaille chez Anthropic, a dit qu'Anthropic avait aussi commencé à développer la prise en charge.
Le robots.txt est le fichier texte brut placé à la racine d'un site web, qui indique aux robots d'exploration ce qu'ils peuvent récupérer. Jusqu'ici, un site qui voulait rester hors de l'entraînement de l'IA devait nommer séparément le robot ou le contrôle de chaque entreprise, comme GPTBot ou Google-Extended.
Comment fonctionne le nouveau jeton
Le jeton se place là où figure normalement le nom d'un robot d'exploration, sur une ligne User-Agent. Les règles qui suivent utilisent les lignes habituelles Disallow et Allow. L'exemple du projet lui-même refuse l'entraînement sur l'ensemble du site, sauf un dossier de kit presse :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Deux détails comptent pour quiconque modifie le fichier. Un groupe générique, User-Agent: *, ne compte pas comme une préférence d'entraînement, selon le projet. Et un site sans groupe __usage_ai-training n'a exprimé aucune préférence, ce qui est vrai de tous les robots.txt publiés aujourd'hui, souligne Relevant Audience.
Le standard est un Internet-Draft de l'IETF, draft-kelley-aipref-training-preference-signal-00, rédigé par Kevin Kelley. C'est une soumission individuelle (individual submission), pas encore approuvée par l'IETF, et elle expire le 3 mai 2027 si elle n'est pas mise à jour.
Qui s'est engagé, et quand
| Entreprise | Ce qu'elle a dit | Quand |
|---|---|---|
| Microsoft | Respectera les préférences d'entraînement et de grounding au moment de l'exploration | 1er février 2027 |
| Vise à prendre en charge ce contrôle | 2027 (« début 2027 » dans sa documentation sur les robots d'exploration) | |
| OpenAI | Respectera le signal pour « l'entraînement de l'IA générative de fondation » | « Dans les prochains mois » |
| Anthropic | L'auteur du projet dit que la prise en charge a commencé | Aucune date donnée |
John Mueller, de Google, a écrit : « Nous visons à prendre en charge ce nouveau contrôle, avec d'autres fournisseurs d'IA, en 2027. » Si un site refuse l'entraînement avec le jeton commun et n'a pas de règle Google-Extended, Google prévoit de le lire comme un Disallow pour Google-Extended. Une règle Google-Extended explicite l'emporte toujours.
Selon PPC Land, OpenAI a déclaré que le nouveau signal « ne remplacera pas les contrôles que nous proposons déjà via robots.txt ». Anthropic n'a fait aucune déclaration en tant qu'entreprise. Kelley a écrit sur la liste de diffusion de l'IETF que « Anthropic a déjà commencé à mettre en œuvre la prise en charge de ce projet », en ajoutant qu'il faudra du temps pour que cette prise en charge atteigne tous ses services.
Microsoft va plus loin
Le plan de Microsoft, décrit par Krishna Madhavan, de Bing, ajoute des contrôles au niveau de la page. Une page peut outrepasser robots.txt avec une balise meta, <meta name="Bingbot" content="ai-training:disallow">, ou avec l'en-tête X-Robots-Tag: Bingbot: ai-training:disallow.
Bing ajoute aussi une préférence de grounding distincte. Le grounding (ancrage) consiste à utiliser une page pour nourrir une réponse d'IA, par opposition à entraîner un modèle dessus. Cette préférence ne fonctionne que page par page, avec les valeurs Allow, Disallow et DisallowExtended.
Les anciennes balises NoArchive et NoCache de Bing cessent de compter comme des contrôles d'IA après le 1er mars 2027, rapporte PPC Land.
Ce que le jeton ne fait pas
C'est une préférence, pas un verrou. Le projet dit que le jeton « n'est pas une directive sur le comportement d'exploration », si bien que les robots peuvent toujours récupérer des pages. Un robot qui ne coopère pas peut l'ignorer, rapporte TokenPost.
Modifier le fichier ne supprime pas non plus le contenu déjà collecté pour les modèles existants. Google affirme que Google-Extended n'affecte ni l'inclusion dans la Recherche ni le classement, et Microsoft affirme que l'éligibilité à la recherche Bing ne change pas. PPC Land cite des données de TollBit d'août 2026 selon lesquelles environ 15 % des outils d'IA qui récupèrent des pages en Europe ont atteint des URL que des sites avaient interdites.
Ce que cela signifie pour les développeurs
- Ajoutez le groupe maintenant si vous voulez en sortir. Un groupe
__usage_ai-trainingne coûte rien aujourd'hui, et Microsoft commence à le lire le 1er février 2027. Mettez-le dans son propre groupe, jamais sousUser-Agent: *. - Gardez vos règles existantes. Les groupes propres à une entreprise, comme GPTBot et Google-Extended, s'appliquent toujours, et la règle la plus spécifique l'emporte. Ne les supprimez pas sur la seule foi d'un projet.
- Séparez entraînement et recherche. Refuser l'entraînement ne vous retire pas de la recherche Google ou Bing, si bien qu'il n'y a aucune raison de classement pour se retenir.
- Préparez le changement de grounding de Bing. Si vous utilisiez NoArchive ou NoCache pour garder du contenu hors des réponses d'IA, passez à la nouvelle préférence de grounding au niveau de la page avant le 1er mars 2027.
- Bloquez les robots par leur nom si vous avez besoin d'un arrêt net. Le jeton exprime une préférence sur l'usage. Seul un
Disallowpar robot, ou un blocage sur votre serveur, arrête la récupération elle-même.
Sources
- Google, Microsoft, OpenAI and Anthropic back one AI training opt-out - PPC Land
- Supporting a shared AI training control for websites - Google Search Central
- Google plans to honour a shared AI training opt-out in robots.txt from 2027 - Relevant Audience
- OpenAI Will Honor Shared Robots.txt Signal for AI Training - TokenPost
- OpenAI, Google, Microsoft, Anthropic Back One AI Opt-Out - FourWeekMBA
Articles liés
L'accord IA de la Maison Blanche engage six laboratoires à recourir à des audits externes
OpenAI, Google, Meta, Anthropic, Nvidia et xAI ont signé un accord volontaire de la Maison Blanche pour faire appel à des auditeurs externes sur l'IA de pointe. Il ne prévoit aucune sanction.
Grok 4.7 choisit les républicains, GPT-6.1 Sol les démocrates
Forcés de choisir dans près de 500 scrutins des midterms américaines via leurs API, Grok 4.7 a choisi le républicain dans 92 % des cas et GPT-6.1 Sol le démocrate dans 97 %.
Les modèles GPT-6 d'OpenAI arrivent sur Google Cloud en préversion
Google Cloud a lancé le 21 octobre 2026 une préversion privée des modèles GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna d'OpenAI, facturés via sa Marketplace.