Google, OpenAI y Microsoft respaldan una exclusión común del entrenamiento de IA
Un nuevo token de robots.txt, __usage_ai-training, permite a un sitio rechazar el entrenamiento de IA una sola vez para varias empresas. Microsoft empieza a respetarlo el 1 de febrero de 2027.
Por Claire Whitmore
3 min de lectura
Traducido automáticamente del original en inglés, que Claire Whitmore verificó y editó. Prevalece la versión en inglés. Cómo trabajamos
En cifras
- when Microsoft starts honoring the token
- Feb 1, 2027
- when Google aims to support it
- 2027
- when the IETF draft expires unless updated
- May 3, 2027
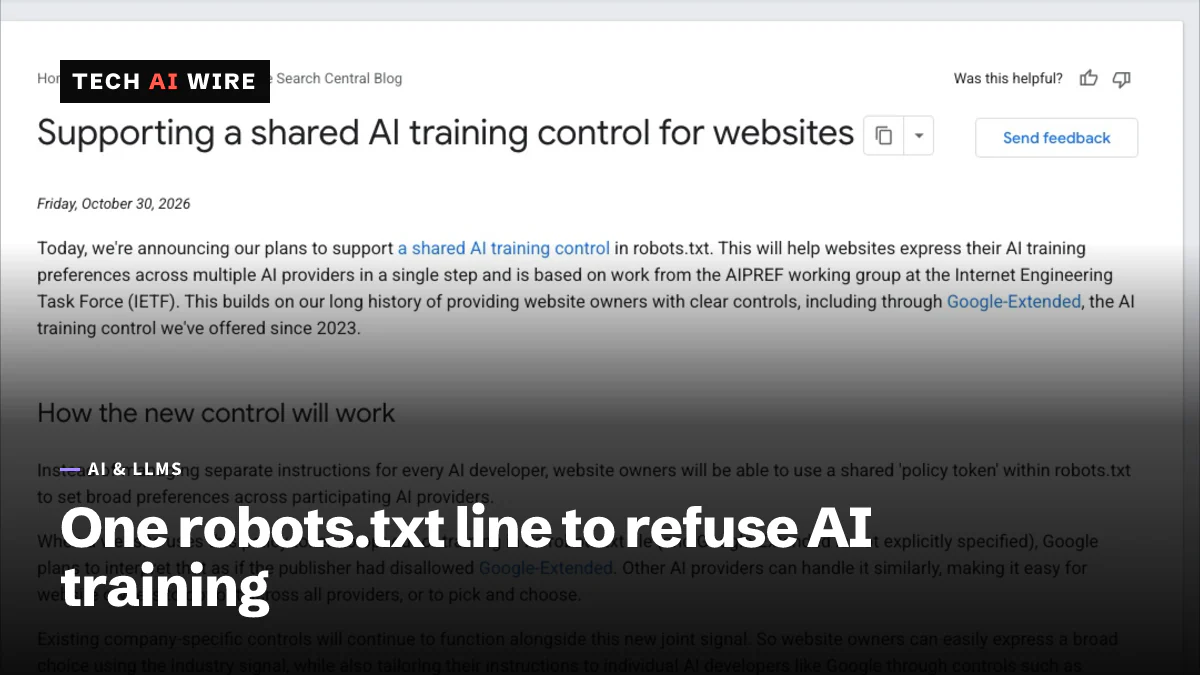
Los propietarios de sitios web podrán rechazar pronto el entrenamiento de IA con una sola línea en robots.txt, en lugar de una regla por cada empresa de IA. El 30 de octubre de 2026, OpenAI, Google y Microsoft dijeron cada una que respetarán un token común llamado __usage_ai-training, según informó PPC Land. El autor del borrador del estándar, que trabaja en Anthropic, dijo que Anthropic también ha empezado a desarrollar el soporte.
Robots.txt es el archivo de texto sin formato que se encuentra en la raíz de un sitio web y que indica a los rastreadores a qué pueden acceder. Hasta ahora, un sitio que quería quedar fuera del entrenamiento de IA tenía que nombrar por separado el rastreador o el control de cada empresa, como GPTBot o Google-Extended.
Cómo funciona el nuevo token
El token va donde normalmente va el nombre de un rastreador, en una línea User-Agent. Las reglas que hay debajo usan las líneas habituales Disallow y Allow. El propio ejemplo del borrador rechaza el entrenamiento en todo el sitio salvo en una carpeta de kit de prensa:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Dos detalles importan para quien edite el archivo. Un grupo comodín, User-Agent: *, no cuenta como preferencia de entrenamiento, según el borrador. Y un sitio sin grupo __usage_ai-training no ha expresado preferencia alguna, lo cual es cierto de todos los robots.txt publicados hoy, señala Relevant Audience.
El estándar es un Internet-Draft del IETF, draft-kelley-aipref-training-preference-signal-00, escrito por Kevin Kelley. Es una propuesta individual (individual submission), aún no respaldada por el IETF, y caduca el 3 de mayo de 2027 si no se actualiza.
Quién se ha comprometido y cuándo
| Empresa | Qué dijo | Cuándo |
|---|---|---|
| Microsoft | Respetará las preferencias de entrenamiento y de grounding en el momento del rastreo | 1 de febrero de 2027 |
| Aspira a dar soporte al control | 2027 («principios de 2027» en su documentación sobre rastreadores) | |
| OpenAI | Respetará la señal para el «entrenamiento de IA generativa fundacional» | «En los próximos meses» |
| Anthropic | El autor del borrador dice que el soporte ha empezado | No se da ninguna fecha |
John Mueller, de Google, escribió: «Aspiramos a dar soporte a este nuevo control, junto con otros proveedores de IA, en 2027». Si un sitio rechaza el entrenamiento con el token común y no tiene regla de Google-Extended, Google planea leerlo como un Disallow de Google-Extended. Una regla explícita de Google-Extended sigue prevaleciendo.
Según PPC Land, OpenAI dijo que la nueva señal «no sustituirá los controles que ya ofrecemos a través de robots.txt». Anthropic no ha emitido ningún comunicado como empresa. Kelley escribió en la lista de correo del IETF que «Anthropic ya ha empezado a implementar el soporte de este borrador», y añadió que llevará tiempo hasta que ese soporte llegue a todos sus servicios.
Microsoft va más allá
El plan de Microsoft, descrito por Krishna Madhavan, de Bing, añade controles a nivel de página. Una página puede anular robots.txt con una etiqueta meta, <meta name="Bingbot" content="ai-training:disallow">, o con la cabecera X-Robots-Tag: Bingbot: ai-training:disallow.
Bing también añade una preferencia de grounding aparte. El grounding (anclaje) consiste en usar una página para fundamentar una respuesta de IA, en lugar de entrenar un modelo con ella. Esta preferencia funciona solo por página, con los valores Allow, Disallow y DisallowExtended.
Las etiquetas más antiguas de Bing, NoArchive y NoCache, dejan de contar como controles de IA después del 1 de marzo de 2027, informa PPC Land.
Lo que el token no hace
Es una preferencia, no un cerrojo. El borrador dice que el token «no es una directiva sobre el comportamiento de rastreo», así que los rastreadores aún pueden acceder a las páginas. Un rastreador que no coopera puede ignorarlo, informa TokenPost.
Cambiar el archivo tampoco elimina el contenido ya recopilado para los modelos existentes. Google dice que Google-Extended no afecta a la inclusión en la Búsqueda ni al posicionamiento, y Microsoft dice que la elegibilidad para la búsqueda de Bing no cambia. PPC Land cita datos de TollBit de agosto de 2026 según los cuales cerca del 15 % de las herramientas de IA que recuperan páginas en Europa llegaron a URL que los sitios habían prohibido.
Qué significa esto para los desarrolladores
- Añada el grupo ahora si quiere salir. Un grupo
__usage_ai-trainingno cuesta nada hoy, y Microsoft empieza a leerlo el 1 de febrero de 2027. Póngalo en su propio grupo, nunca bajoUser-Agent: *. - Mantenga sus reglas actuales. Los grupos específicos de cada empresa, como GPTBot y Google-Extended, siguen aplicándose, y prevalece la regla más específica. No los elimine basándose solo en un borrador.
- Separe el entrenamiento de la búsqueda. Rechazar el entrenamiento no lo saca de la búsqueda de Google ni de Bing, así que no hay ninguna razón de posicionamiento para contenerse.
- Prepárese para el cambio de grounding de Bing. Si usaba NoArchive o NoCache para mantener contenido fuera de las respuestas de IA, pase a la nueva preferencia de grounding por página antes del 1 de marzo de 2027.
- Bloquee rastreadores por su nombre si necesita una parada firme. El token expresa una preferencia sobre el uso. Solo un
Disallowpor rastreador, o un bloqueo en su servidor, detiene el acceso en sí.
Fuentes
- Google, Microsoft, OpenAI and Anthropic back one AI training opt-out - PPC Land
- Supporting a shared AI training control for websites - Google Search Central
- Google plans to honour a shared AI training opt-out in robots.txt from 2027 - Relevant Audience
- OpenAI Will Honor Shared Robots.txt Signal for AI Training - TokenPost
- OpenAI, Google, Microsoft, Anthropic Back One AI Opt-Out - FourWeekMBA
Artículos relacionados
El acuerdo de IA de la Casa Blanca compromete a seis laboratorios con auditorías externas
OpenAI, Google, Meta, Anthropic, Nvidia y xAI firmaron un acuerdo voluntario de la Casa Blanca para recurrir a auditores externos en la IA de frontera. No contempla sanciones.
Grok 4.7 elige a los republicanos y GPT-6.1 Sol a los demócratas
Obligados a elegir en casi 500 contiendas de las elecciones de mitad de mandato de EE. UU. a través de sus API, Grok 4.7 eligió al republicano el 92 % de las veces y GPT-6.1 Sol al demócrata el 97 %.
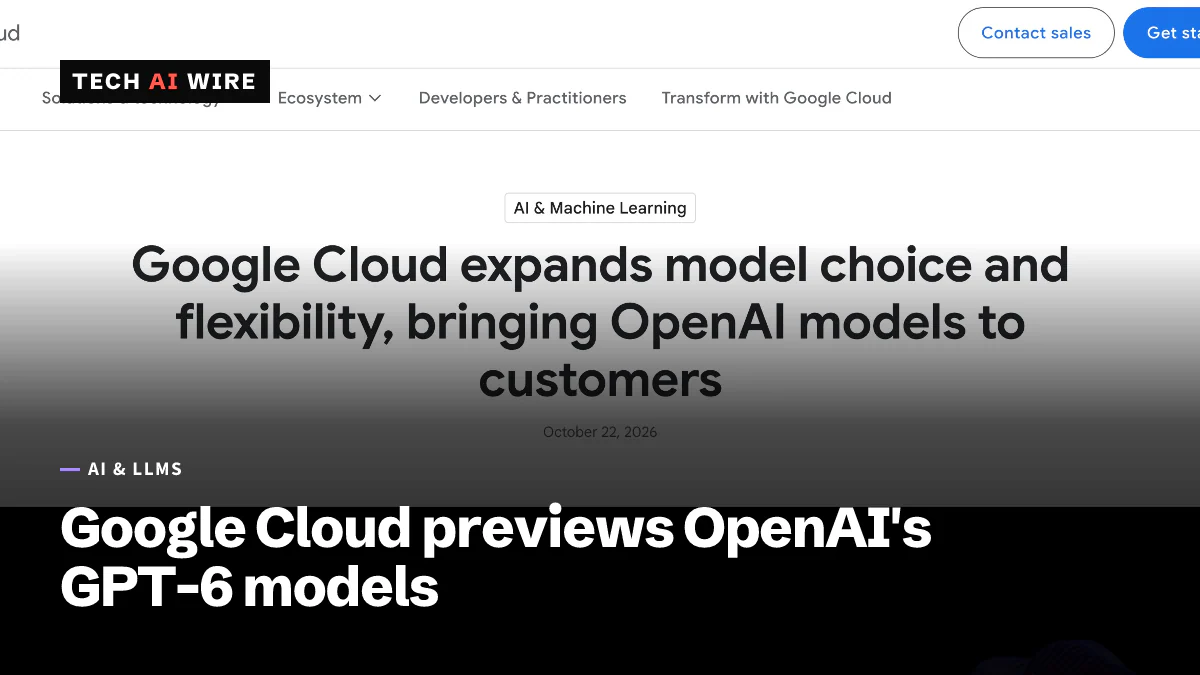
Los modelos GPT-6 de OpenAI llegan a Google Cloud en vista previa
Google Cloud inició el 21 de octubre de 2026 una vista previa privada de GPT-6 Astra, GPT-6.1 Sol y GPT-6 Luna de OpenAI, facturados a través de su Marketplace.