OpenAI zieht 3 von 722 KI-Mathepapieren wegen eines Vorzeichenfehlers zurück
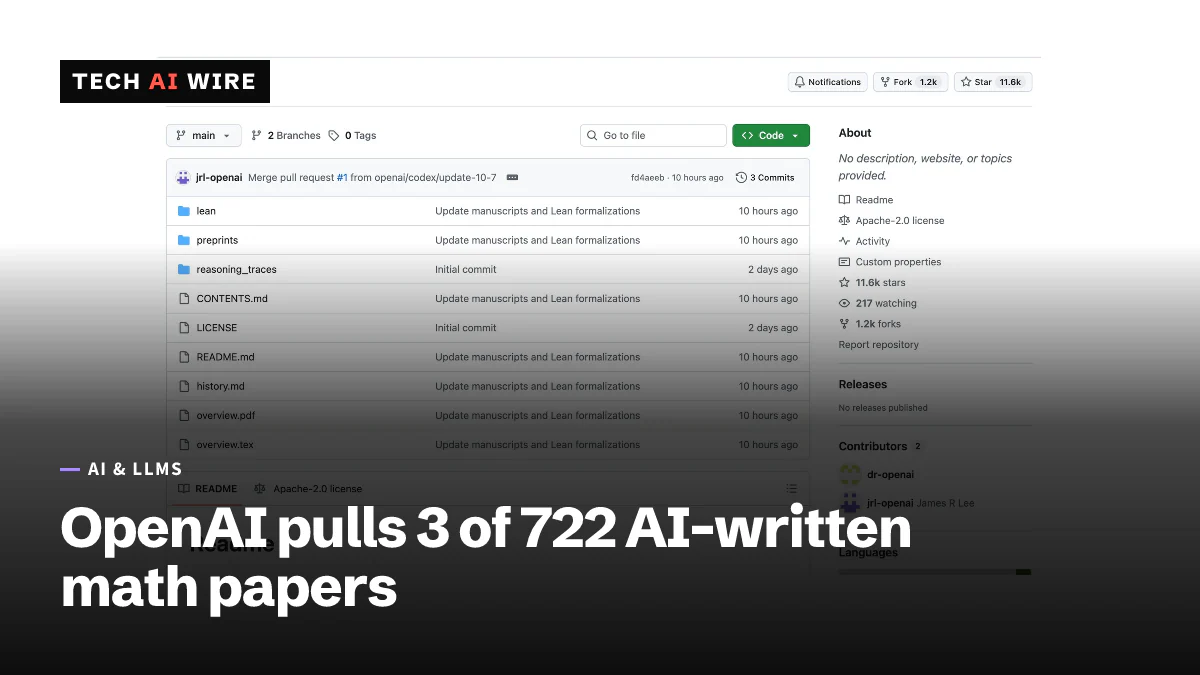
OpenAI stellte am 6. Oktober 722 KI-geschriebene Mathemanuskripte online und zog einen Tag später drei zurück, weil ein Vorzeichenfehler einen Beweis zerstörte. 719 bleiben, 300 Ergebnisse haben Lean-Prüfungen.
3 Min. Lesezeit
Die Zahlen
- manuscripts in the October 6 release
- 722
- withdrawn on October 7
- 3
- top-line results with Lean formal proofs
- 300 of 719
- average compute per result, per OpenAI
- ~3 hours
OpenAI hat am 6. Oktober 2026 722 Mathemanuskripte veröffentlicht, die ein unveröffentlichtes KI-Modell geschrieben hat. Am nächsten Tag zog das Unternehmen drei davon zurück. Laut OpenAIs Änderungsverlauf auf GitHub zerstörte ein Vorzeichenfehler einen wichtigen Schritt in einem Beweis. Zwei weitere Papiere hingen von diesem Beweis ab. Der Fall zeigt, wie schwer sich KI-geschriebene Forschung in großem Umfang prüfen lässt. Er zeigt auch, warum Mathematiker über die Veröffentlichung streiten.
Was OpenAI veröffentlicht hat
Die Dateien liegen in einem öffentlichen GitHub-Repository namens openai/math. Implicator.ai zählt 372 „Ergebnisfamilien“ und 722 Manuskripte. Fortune beschreibt die Veröffentlichung als vollständige oder teilweise KI-Lösungen für mehr als 370 offene Probleme. Das zählt etwas anderes, daher sollte man die beiden Zahlen nicht vermischen.
Implicator.ai und Yahoo Tech sagen beide, die Arbeit stamme von einem internen Modell, das OpenAI nicht veröffentlicht hat. Implicator.ai schreibt, OpenAI habe bei der Auswertung etwa 4.000 Probleme gestellt. Im Schnitt seien pro Ergebnis etwa drei Stunden ChatGPT-Pro-Rechenzeit angefallen. Ein Sprecher sagte, fast jedes Ergebnis stamme aus einem Prompt an einen KI-Agenten.
Fortune berichtet, OpenAI beanspruche auch Fortschritte bei drei weiteren der sieben Millennium-Prize-Probleme. Das sind berühmte offene Probleme mit Preisen von 1 Million Dollar. Keines davon ist vollständig gelöst. OpenAI hatte schon Wochen zuvor eine Lösung des Navier-Stokes-Problems behauptet. Gegen diese Behauptung wehrten sich Mathematiker.
Die drei Rückzüge
Der Änderungsverlauf vom 7. Oktober listet die zurückgezogenen Papiere auf:
| Paper | Rolle |
|---|---|
| Algebraicity of Weil classes on split abelian eightfolds | Enthielt den Fehler |
| Algebraicity of Kuga-Satake Correspondences for K3 Surfaces | Hing davon ab |
| The rational Hodge conjecture for products of K3 surfaces | Hing davon ab |
Als Grund steht dort: „Ein Vorzeichenfehler macht ein Argument zur Auslöschung der Stabilisierungsspur ungültig.“ Der Verlauf nennt außerdem 14 weitere Manuskripte, die OpenAI korrigiert hat. 13 wurden aktualisiert, damit sie überarbeitete Begleitpapiere zitieren. Die zurückgezogenen Fassungen bleiben mit Hinweisen online, berichtet Implicator.ai.
Keine Quelle nennt, wer den Fehler gefunden hat. Auch OpenAIs eigene Seite sagt dazu nichts.
Wie viel geprüft ist
Lean ist eine Programmiersprache, mit der ein Computer jeden logischen Schritt eines Beweises prüfen kann. Laut Implicator.ai und dem Änderungsverlauf haben 300 der 719 verbleibenden Hauptergebnisse Lean-Formalisierungen, etwa 42 %. Fortune sagt nur, „einige“ Probleme seien formal geprüft. Eine Lean-Prüfung bestätigt die Logik. Ob ein Ergebnis neu oder wichtig ist, bestätigt sie nicht, merkt Yahoo Tech an.
Außenstehende können das Modell nicht erneut laufen lassen, weil es nicht verfügbar ist. Implicator.ai sagt, OpenAI habe keine Prompts veröffentlicht, sondern nur durchschnittliche Rechenwerte. Eine Beratergruppe am Institute for Advanced Study hatte am 29. September mehr Offenlegung empfohlen. Fortune sagt, OpenAI sei dem Rat der Gruppe nur teilweise gefolgt.
Was Mathematiker sagen
Die Reaktionen sind geteilt, laut Fortune und Implicator.ai.
- Daniel Litt von der University of Toronto nannte die Veröffentlichung „großartig für die Mathematik“. Er sehe keinen Grund, die Papiere geheim zu halten.
- Tristan Buckmaster von der New York University stellte die Sorgfalt infrage, zitiert über die New York Times.
- Andrew Sutherland vom MIT sagte, man solle „alle Behauptungen über das Lösen von Problemen in einem Schuss mit einem einzelnen Agenten als unbestätigt behandeln“.
- Die IAS-Beratergruppe sagte: „Diese Veröffentlichung ist der Anfang, nicht der Abschluss des Prozesses des menschlichen Verstehens.“
Implicator.ai weist außerdem auf einen Widerspruch hin. Die Beschreibung des Sprechers, „ein Prompt, ein Agent“, passt nicht zu den 10.000 Agenten, die OpenAI nach eigener Aussage für das Navier-Stokes-Ergebnis eingesetzt hat.
Was das für Entwickler bedeutet
Wer KI für Code, Beweise oder Forschung nutzt, steht vor demselben Prüfproblem.
- Erzeugen und Prüfen trennen. Die Lean-Prüfungen fanden, was Lesen nicht fand. Hat Ihre KI-Ausgabe eine maschinenprüfbare Form, etwa Tests, Typen oder Beweise, führen Sie sie aus, bevor jemand ihr traut.
- Abhängigkeiten zwischen KI-Ausgaben verfolgen. Ein fehlerhaftes Papier zog zwei weitere mit. Halten Sie fest, welche erzeugten Artefakte auf welchen aufbauen.
- Die Eingaben verlangen. Ohne Prompts und Modellzugang kann niemand eine verlässliche Methode von einem Glückstreffer unterscheiden, merkt Yahoo Tech an. Fragen Sie nach Prompts, Einstellungen und Logs hinter jeder KI-Behauptung, auf die Sie sich stützen.
- Einen Rückzug als normalen Vorgang behandeln. Drei von 722 in zwei Tagen sind nicht alarmierend. Der klare Änderungsverlauf ist der Teil, den man nachahmen sollte.
Die Zahl, auf die es ankommt, ist der Anteil der Ergebnisse mit formalen Beweisen. Bei jetzt 42 % zeigt sie, wie viel der Veröffentlichung ein Mathematiker noch von Hand lesen muss.
Quellen
- OpenAI publishes solutions to more than 370 outstanding math challenges. Math may never be the same - Fortune
- OpenAI Posts 372 AI Math Results, Then Withdraws Three Papers Over a Sign Error - Implicator.ai
- OpenAI Withdraws Three AI-Generated Math Manuscripts Over a Sign Error That Collapsed a Weil-Classes Argument - AI Weekly
- openai/math revision history - GitHub
Ähnliche Artikel
GPT-6 Astra ist OpenAIs erstes Critical-Cyber-Modell
Astra erreichte 100% auf ExploitBench und baute in 29 Stunden eine funktionierende Browser-Exploit-Kette. Die ausgelieferte Version verweigert Proof-of-Concept-Exploits.
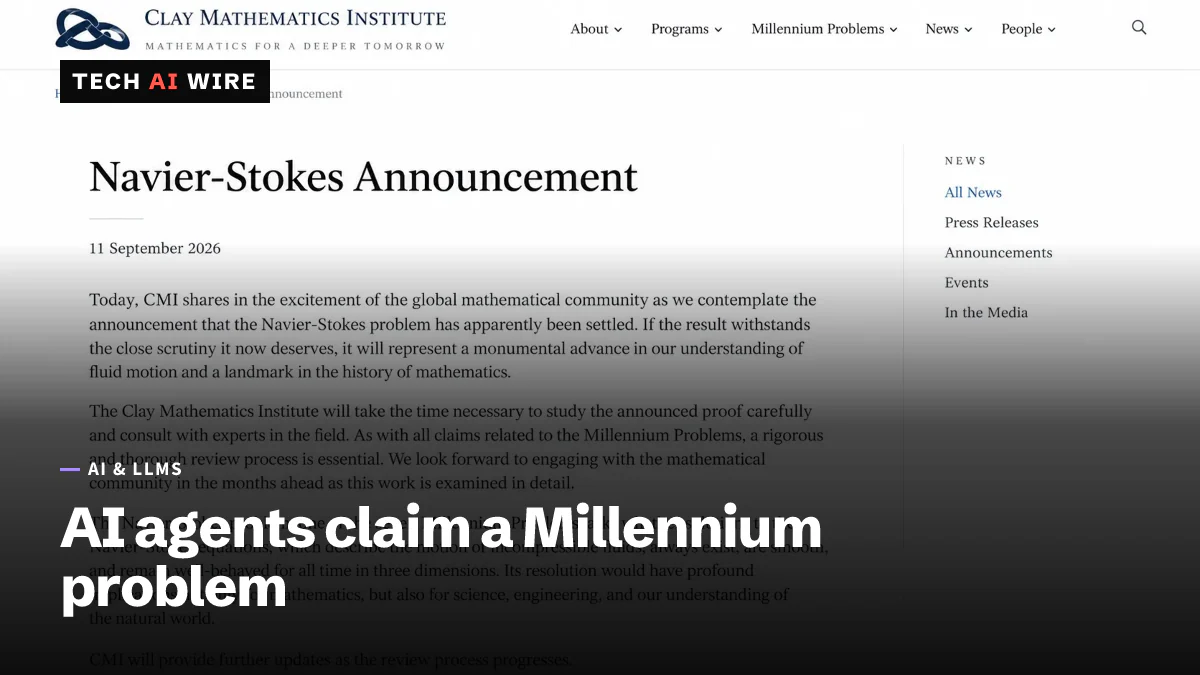
KI-Agenten beanspruchen Navier-Stokes, Mathematiker halten dagegen
OpenAI hat 10.000 Agenten auf ein Problem des Millennium Prize angesetzt und sagt, sie hätten es in 88 Stunden geknackt. Tage später unterzeichneten 25 Träger der Fields Medal eine Warnung.
GPT-6 Astra erreicht 95% bei einer Roboteraufgabe, 10% bei einer anderen
Robocurve hat GPT-6 Astra und Claude Fable 5.1 an echten Roboterarmen getestet. Astra schaffte 19 von 20 bei der leichten Aufgabe und 2 von 20 bei der schweren.