OpenAI retira 3 de 722 artigos de matemática com IA por causa de um erro de sinal
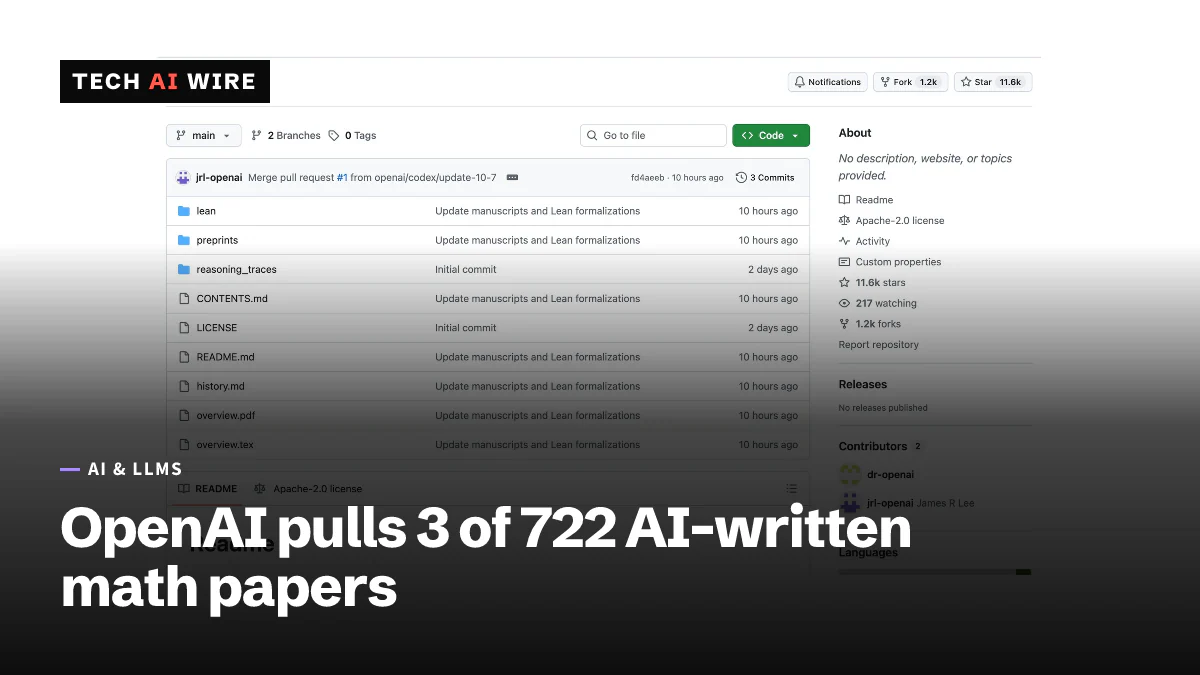
A OpenAI publicou 722 manuscritos de matemática escritos por IA em 6 de outubro e retirou três um dia depois, quando um erro de sinal quebrou uma prova. Restam 719; 300 resultados têm verificações em Lean.
3 min de leitura
Em números
- manuscripts in the October 6 release
- 722
- withdrawn on October 7
- 3
- top-line results with Lean formal proofs
- 300 of 719
- average compute per result, per OpenAI
- ~3 hours
A OpenAI publicou 722 manuscritos de matemática escritos por um modelo de IA ainda não lançado em 6 de outubro de 2026 e retirou três deles no dia seguinte. Segundo o histórico de revisões da OpenAI no GitHub, um erro de sinal quebrou uma etapa-chave de uma prova. Outros dois artigos dependiam dessa prova. O episódio mostra como é difícil verificar em grande escala uma pesquisa escrita por IA. Também explica por que os matemáticos discutem a publicação.
O que a OpenAI publicou
Os arquivos estão em um repositório público do GitHub, o openai/math. O Implicator.ai conta 372 "famílias de resultados" e 722 manuscritos. A Fortune descreve a publicação como soluções totais ou parciais, feitas por IA, para mais de 370 problemas em aberto. Isso conta outra coisa, então os dois números não devem ser misturados.
O Implicator.ai e o Yahoo Tech dizem que o trabalho veio de um modelo interno que a OpenAI não lançou. O Implicator.ai diz que a OpenAI propôs cerca de 4.000 problemas durante a avaliação. Segundo ele, foram gastas em média cerca de três horas de computação do ChatGPT Pro por resultado. Um porta-voz disse que quase todos os resultados vieram de um único prompt para um único agente de IA.
A Fortune relata que a OpenAI também afirma ter avançado em mais três dos sete problemas do Millennium Prize. São problemas em aberto famosos, com prêmios de 1 milhão de dólares. Nenhum tem solução completa. A OpenAI já havia afirmado semanas antes que resolvera o problema de Navier-Stokes. Essa afirmação os matemáticos contestaram.
As três retiradas
O histórico de revisões, datado de 7 de outubro, lista os artigos retirados:
| Artigo | Papel |
|---|---|
| Algebraicity of Weil classes on split abelian eightfolds | Continha o erro |
| Algebraicity of Kuga-Satake Correspondences for K3 Surfaces | Dependia dele |
| The rational Hodge conjecture for products of K3 surfaces | Dependia dele |
O motivo declarado é que "um erro de sinal invalida um argumento de cancelamento do traço de estabilização". O histórico diz também que a OpenAI corrigiu outros 14 manuscritos. Atualizou 13 para que citem artigos complementares revisados. As versões retiradas continuam online com avisos, informa o Implicator.ai.
Nenhuma fonte diz quem encontrou o erro. A própria página da OpenAI também não diz.
Quanto está verificado
Lean é uma linguagem de programação que permite a um computador verificar cada passo lógico de uma prova. Segundo o Implicator.ai e o histórico de revisões, 300 dos 719 resultados principais restantes têm formalizações em Lean, cerca de 42%. A Fortune diz apenas que "alguns" problemas têm verificações formais. Uma verificação em Lean confirma a lógica. Ela não confirma se um resultado é novo ou importante, observa o Yahoo Tech.
Quem está de fora não pode rodar o modelo de novo, porque ele não está disponível. O Implicator.ai diz que a OpenAI não publicou prompts, só números médios de computação. Um grupo consultivo do Institute for Advanced Study havia recomendado mais transparência em 29 de setembro. A Fortune diz que a OpenAI seguiu o conselho do grupo só em parte.
O que dizem os matemáticos
As reações estão divididas, segundo a Fortune e o Implicator.ai.
- Daniel Litt, da University of Toronto, chamou a publicação de "ótima para a matemática". Disse não ver motivo para manter os artigos em segredo.
- Tristan Buckmaster, da New York University, questionou a diligência prévia, citado pelo New York Times.
- Andrew Sutherland, do MIT, disse para "tratar como não verificada qualquer afirmação sobre resolver problemas de primeira tentativa com um único agente".
- O grupo consultivo do IAS disse: "Esta publicação é o começo, não a conclusão, do processo de compreensão humana."
O Implicator.ai também aponta uma tensão. A descrição do porta-voz, "um prompt, um agente", conflita com os 10.000 agentes que a OpenAI disse ter usado no resultado de Navier-Stokes.
O que isso significa para desenvolvedores
Quem usa IA para escrever código, provas ou pesquisa enfrenta o mesmo problema de verificação.
- Separe gerar de verificar. As verificações em Lean pegaram o que a leitura não pegou. Se a saída da sua IA tem uma forma verificável por máquina, como testes, tipos ou provas, execute-a antes que alguém confie nela.
- Acompanhe as dependências entre saídas de IA. Um artigo ruim derrubou outros dois. Registre quais artefatos gerados se apoiam em quais.
- Exija as entradas. Sem prompts e sem acesso ao modelo, ninguém distingue um método confiável de um resultado de sorte, observa o Yahoo Tech. Peça os prompts, as configurações e os registros por trás de qualquer afirmação de IA em que você se apoie.
- Trate uma retirada como um evento normal. Três de 722 em dois dias não é alarmante. Publicar um histórico de revisões claro é a parte a copiar.
O número a acompanhar é a parcela de resultados com provas formais. Com 42% agora, ele mostra quanto da publicação um matemático ainda precisa ler à mão.
Fontes
- OpenAI publishes solutions to more than 370 outstanding math challenges. Math may never be the same - Fortune
- OpenAI Posts 372 AI Math Results, Then Withdraws Three Papers Over a Sign Error - Implicator.ai
- OpenAI Withdraws Three AI-Generated Math Manuscripts Over a Sign Error That Collapsed a Weil-Classes Argument - AI Weekly
- openai/math revision history - GitHub
Artigos relacionados
GPT-6 Astra é o primeiro modelo Critical em ciber da OpenAI
O Astra alcançou 100% no ExploitBench e montou uma cadeia de exploração de navegador em 29 horas. A versão publicada recusa escrever provas de conceito.
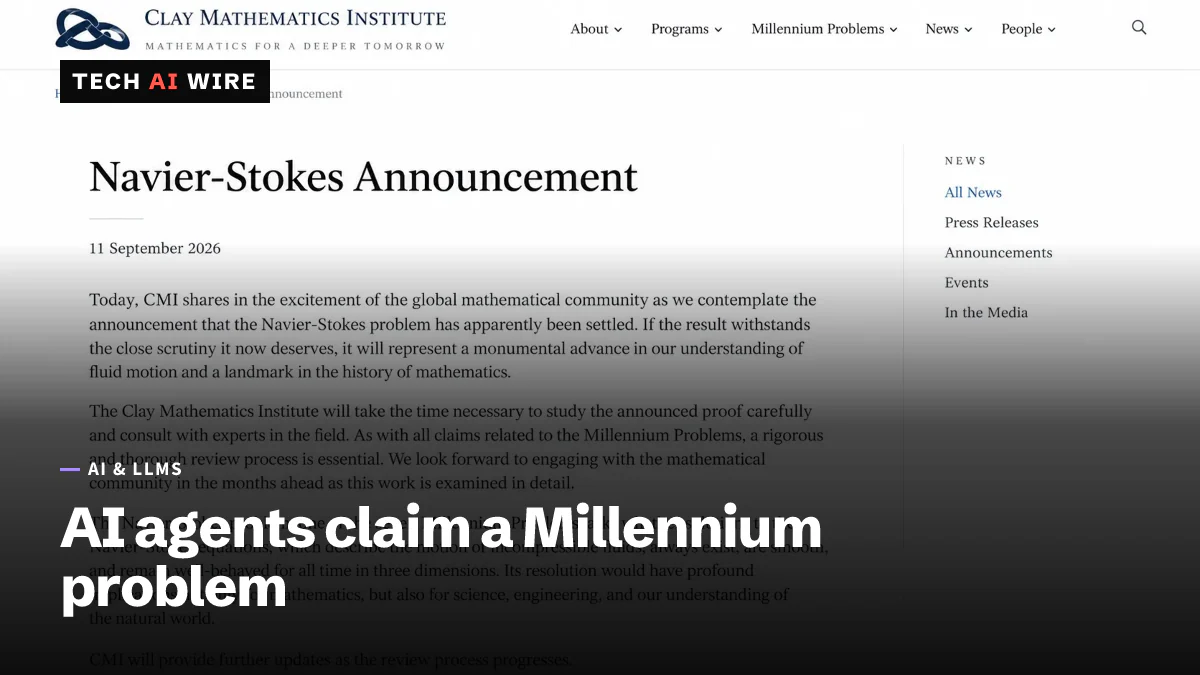
Agentes de IA reivindicam Navier-Stokes e matemáticos reagem
A OpenAI colocou 10.000 agentes em um problema do Millennium Prize e diz que eles o resolveram em 88 horas. Dias depois, 25 laureados com a Fields Medal assinaram um alerta.
GPT-6 Astra faz 95% numa tarefa robótica e 10% noutra
A Robocurve testou o GPT-6 Astra e o Claude Fable 5.1 em braços robóticos reais. O Astra acertou 19 em 20 na tarefa fácil e 2 em 20 na difícil.