Go 1.27: das simd-Paket bringt portables, emuliertes SIMD
Das experimentelle simd-Paket in Go 1.27 führt einen Vektor-Codepfad auf AVX-512, NEON, wasm und RISC-V aus und emuliert ihn, wo Hardware-SIMD fehlt.
4 Min. Lesezeit
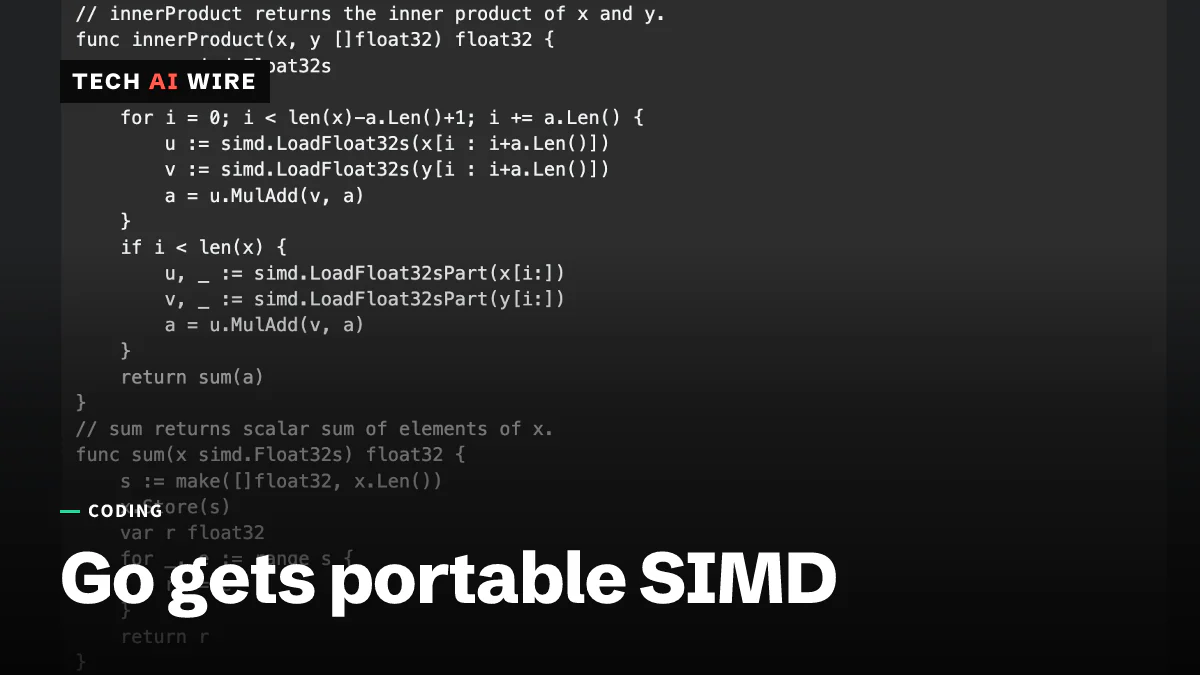
Das Go-Team hat erklärt, wie sein neues portables SIMD-Paket funktioniert, in einem Beitrag im Go-Blog vom 24. September 2026. Go 1.27 liefert ein experimentelles simd-Paket aus, mit dem ein einziges Stück Go-Code Vektorbefehle auf vielen verschiedenen CPUs nutzen kann. Das ist wichtig, denn bis Go 1.26 erreichte man diese Befehle aus Go nur mit handgeschriebenem Assembler.
SIMD steht für Single Instruction, Multiple Data. Es ist eine CPU-Funktion, die eine Operation auf einen ganzen Stapel von Werten zugleich anwendet, etwa acht Zahlenpaare in einem einzigen Schritt addiert. Das beschleunigt Aufgaben wie Kompression, Kryptografie, Bildverarbeitung und maschinelles Lernen.
Vom Assembler zu zwei experimentellen Paketen
Go hat jetzt zwei SIMD-Pakete, und beide sind noch Experimente. Das erste, archsimd, kam mit Go 1.26. Es ist architekturabhängig: Es legt die eigenen Befehle jeder CPU-Familie offen, sodass für Intel-Chips geschriebener Code nicht auf Arm läuft.
Das zweite ist das neue portable simd-Paket in Go 1.27. Die Autoren des Beitrags, David Chase und Junyang Shao, beschreiben es als "an experimental platform-agnostic SIMD API". Phoronix merkt an, dass das Design an Highway angelehnt ist, Googles C++-Bibliothek für portablen Vektorcode.
Beide Pakete stecken hinter demselben Schalter. Man baut mit der Umgebungsvariable GOEXPERIMENT=simd, um sie einzuschalten.
Warum portables SIMD schwierig ist
CPU-Familien sind sich bei Vektoren in fast allem uneinig. Der Go-Blog listet die Vektorbreiten auf, die jede Plattform unterstützt.
| Plattform | Vektorbefehle | Vektorbreite |
|---|---|---|
| amd64 | AVX, AVX2, AVX-512 | 128, 256 und 512 Bit |
| arm64 | NEON | 128 Bit |
| arm64 (geplant für Go 1.28) | SVE | 128 bis 2.048 Bit |
| wasm | WebAssembly SIMD | 128 Bit |
| riscv64 | RVV | 128 bis 65.536 Bit |
Der Beitrag nennt außerdem loong64, ppc64 und s390x als unterstützt. Manche Chips verraten ihre Vektorbreite erst beim Programmstart, daher kann Code zur Build-Zeit keine Größe annehmen.
Das simd-Paket löst das, indem es die Breite aus den Typen herauslässt. Vektortypen heißen wie großgeschriebene Primitive im Plural: simd.Float32s, simd.Int8s, simd.Uint64s. Ein Float32s enthält so viele 32-Bit-Gleitkommazahlen, wie die aktuelle CPU auf einmal verarbeiten kann. Masken, die Wahr-oder-falsch-Werte aus Vergleichen, bekommen passende Typen wie Mask32s.
Wie es schnell läuft, ohne die Breite zu kennen
Die Spezialisierung übernimmt der Compiler. Laut Go-Blog schreibt er Funktionen, die simd nutzen, in Varianten für jede Vektorbreite um, bezeichnet etwa als @simd128. Das Programm führt dann die Variante aus, die zur Maschine passt, ohne Dispatch-Aufwand in der heißen Schleife.
Eine GODEBUG-Einstellung steuert die Wahl zur Laufzeit. simd=0 schaltet Vektorcode ab, und simd=128, simd=256 oder simd=512 begrenzen die Breite. Um jeden Pfad zu testen, muss nichts neu kompiliert werden.
Wo eine Plattform keine passenden Befehle hat, wird jede Operation emuliert. Die Autoren nennen ihre Ziele für das Paket. Es soll "as efficient as assembly language when the source code operations match the underlying hardware" sein. Andernfalls soll es "emulated as well as possible" sein. Und es soll "easy to read and understand (even/especially if an LLM ends up writing the code)" sein.
Was in Go 1.27 fehlt
Die erste Version hat deutliche Lücken. Es gibt keine horizontale Reduktion, also keinen eingebauten Weg, alle Elemente eines Vektors zu summieren. Das eigene Beispiel des Blogs schreibt dafür eine kleine skalare Schleife und kündigt eine ReduceSum-Operation für die nächste Version an.
Auch Arms SVE-Befehle sind für Go 1.28 vorgesehen, berichtet Phoronix, zusammen mit weiteren Operationen. Manche Operationen sind heute auf manchen Architekturen nicht verfügbar.
Was das für Entwickler bedeutet
Wenn Ihr Go-Dienst eine heiße Schleife über Zahlen-Slices hat, probieren Sie das Paket jetzt auf einem Branch aus. Gute Kandidaten sind Prüfsummen, Parsing, Abstandsberechnungen für die Vektorsuche und Bildfilter. Mit der portablen API schreiben Sie diese Schleife einmal statt einmal pro CPU-Familie.
Benchmarken Sie jede Breite, nicht nur die Ihres Laptops. Führen Sie denselben Benchmark mit GODEBUG=simd=0, simd=128, simd=256 und simd=512 aus. Die Null-Einstellung liefert Ihnen die skalare Basislinie gratis, und die anderen zeigen, ob sich breitere Vektoren bei Ihren Daten wirklich lohnen.
Halten Sie es aus allem heraus, was Sie nicht schnell neu bauen können. Beide SIMD-Pakete stecken hinter GOEXPERIMENT, und experimentelle APIs können sich zwischen Releases ändern. Planen Sie auch das fehlende ReduceSum ein, denn jeder Code, der einen Vektor summiert, braucht bis Go 1.28 eine vorübergehende skalare Schleife.
Andere Ökosysteme gehen denselben Handel ein. Go hatte bereits einen Erfolg aus der Praxis: Debian Code Search warf seine letzte C-Abhängigkeit hinaus, mit dem älteren archsimd-Paket. Rust ging diesen Monat den Weg über eine Bibliothek, als Fearless SIMD 1.0 ein stabiles, sicheres SIMD-Crate auslieferte. Go baut die Fähigkeit in seine Toolchain ein, und der Compiler erledigt die Arbeit pro CPU.
Quellen
- Platform-independent SIMD in Go - The Go Blog
- Go's Improving SIMD Support, Platform-Independent SIMD Interface - Phoronix
Ähnliche Artikel
Fearless SIMD 1.0 bringt stabiles, sicheres SIMD nach Rust
Fearless SIMD 1.0 erschien am 21. September und bringt Rust sicheres SIMD von SSE2 bis AVX-512, NEON und WebAssembly, mit stabiler API und 3 Jahren Sicherheitsupdates.
Mojo 1.1 nimmt erstmals externe Compiler-Beiträge an
Mojo 1.1 nimmt einen Monat nach der Apache-2.0-Freigabe externe Compiler-Beiträge an und vollendet die Entfernung von fn, alias und @parameter if.
LLVM debattiert, ClangIR standardmäßig zu bauen
Ein LLVM-RFC schlägt vor, ClangIR standardmäßig in Clang zu kompilieren. Genutzt würde es nur mit Flag, doch Schätzungen sehen mehr als doppelte Bauzeiten.