Go 1.27: o pacote simd traz SIMD portátil e emulado
O pacote experimental simd do Go 1.27 executa um único caminho de código vetorial em AVX-512, NEON, wasm e RISC-V, e o emula onde falta SIMD em hardware.
4 min de leitura
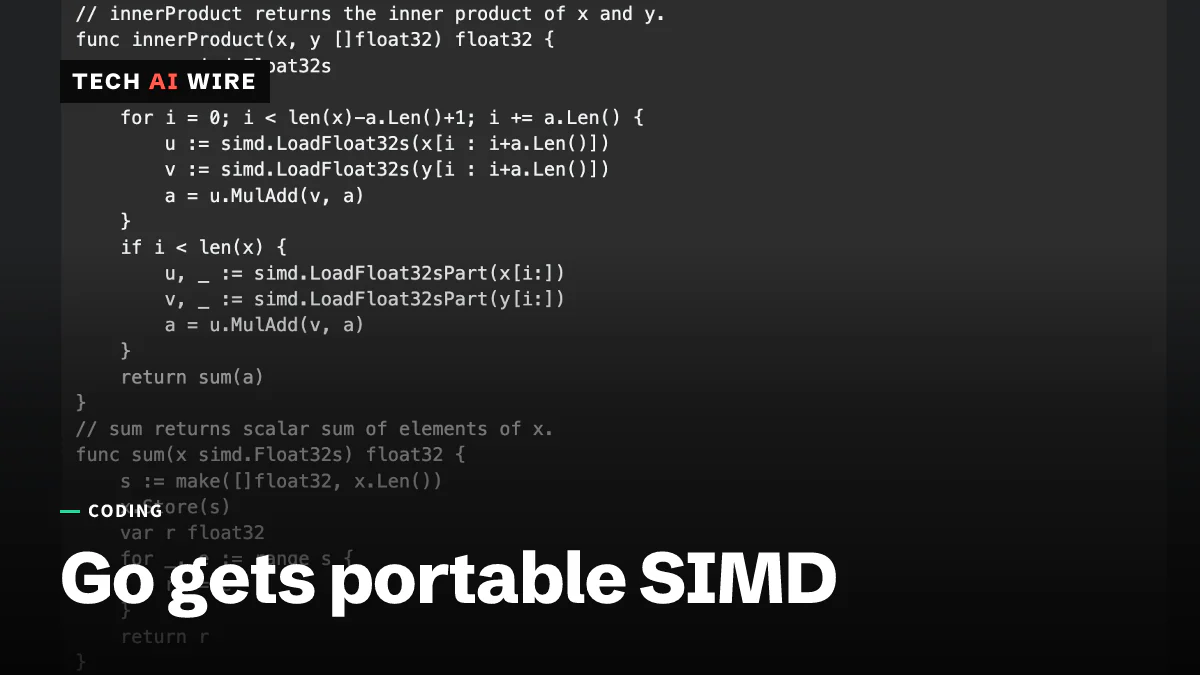
A equipe do Go explicou como funciona seu novo pacote SIMD portátil, em um post no blog do Go datado de 24 de setembro de 2026. O Go 1.27 traz um pacote experimental simd que permite que um mesmo trecho de código Go use instruções vetoriais em muitas CPUs diferentes. Isso importa porque, até o Go 1.26, a única forma de chegar a essas instruções a partir do Go era escrever assembly à mão.
SIMD significa single instruction, multiple data. É um recurso da CPU que aplica uma operação a um lote inteiro de valores de uma vez, como somar oito pares de números em um único passo. Ele acelera tarefas como compressão, criptografia, processamento de imagens e aprendizado de máquina.
Do assembly a dois pacotes experimentais
O Go tem agora dois pacotes SIMD, e ambos ainda são experimentos. O primeiro, archsimd, chegou no Go 1.26. Ele depende da arquitetura: expõe as instruções próprias de cada família de CPU, então o código escrito para chips da Intel não roda em Arm.
O segundo é o novo pacote portátil simd do Go 1.27. Os autores do post, David Chase e Junyang Shao, o descrevem como "an experimental platform-agnostic SIMD API". O Phoronix observa que o design tem como modelo o Highway, a biblioteca C++ do Google para código vetorial portátil.
Os dois pacotes ficam atrás do mesmo interruptor. Para ativá-los, você compila com a variável de ambiente GOEXPERIMENT=simd.
Por que SIMD portátil é difícil
As famílias de CPU discordam em quase tudo sobre vetores. O blog do Go lista as larguras de vetor que cada plataforma suporta.
| Plataforma | Instruções vetoriais | Largura de vetor |
|---|---|---|
| amd64 | AVX, AVX2, AVX-512 | 128, 256 e 512 bits |
| arm64 | NEON | 128 bits |
| arm64 (previsto para o Go 1.28) | SVE | 128 a 2.048 bits |
| wasm | WebAssembly SIMD | 128 bits |
| riscv64 | RVV | 128 a 65.536 bits |
O post também cita loong64, ppc64 e s390x como suportados. Alguns chips só revelam sua largura de vetor quando um programa inicia, então o código não pode assumir um tamanho na compilação.
O pacote simd resolve isso deixando a largura de fora dos tipos. Os tipos vetoriais têm nomes de tipos primitivos no plural e com inicial maiúscula: simd.Float32s, simd.Int8s, simd.Uint64s. Um Float32s guarda tantos floats de 32 bits quanto a CPU atual consegue processar de uma vez. As máscaras, os valores de verdadeiro ou falso que as comparações produzem, ganham tipos correspondentes como Mask32s.
Como roda rápido sem conhecer a largura
Quem faz a especialização é o compilador. Segundo o blog do Go, ele reescreve as funções que usam simd em variantes para cada largura de vetor, rotuladas por exemplo como @simd128. O programa então executa a variante que combina com a máquina, sem custo de despacho dentro do laço crítico.
Uma configuração de GODEBUG controla a escolha em tempo de execução. simd=0 desliga o código vetorial, e simd=128, simd=256 ou simd=512 limitam a largura. Não é preciso recompilar para testar cada caminho.
Onde uma plataforma não tem instruções adequadas, cada operação é emulada. Os autores listam seus objetivos para o pacote. Ele deve ser "as efficient as assembly language when the source code operations match the underlying hardware". Caso contrário, deve ser "emulated as well as possible". E deve ser "easy to read and understand (even/especially if an LLM ends up writing the code)".
O que falta no Go 1.27
A primeira versão tem lacunas claras. Não há redução horizontal, ou seja, não existe uma forma embutida de somar todos os elementos de um vetor. O próprio exemplo do blog escreve um pequeno laço escalar para essa etapa e diz que uma operação ReduceSum virá na próxima versão.
As instruções SVE da Arm também estão previstas para o Go 1.28, segundo o Phoronix, junto com mais operações. Hoje, algumas operações não estão disponíveis em algumas arquiteturas.
O que isso significa para desenvolvedores
Se o seu serviço em Go tem um laço crítico sobre slices de números, experimente o pacote agora em um branch. Bons candidatos são checksums, parsing, cálculos de distância para busca vetorial e filtros de imagem. A API portátil permite escrever esse laço uma vez, em vez de uma vez por família de CPU.
Faça benchmark de cada largura, não só da do seu notebook. Rode o mesmo benchmark com GODEBUG=simd=0, simd=128, simd=256 e simd=512. A configuração zero dá a você a referência escalar de graça, e as outras mostram se vetores mais largos realmente compensam com os seus dados.
Mantenha-o longe de qualquer coisa que você não consiga recompilar rápido. Os dois pacotes SIMD ficam atrás de GOEXPERIMENT, e APIs experimentais podem mudar entre versões. Planeje também a falta do ReduceSum, já que qualquer código que some um vetor precisa de um laço escalar temporário até o Go 1.28.
É a mesma troca que outros ecossistemas estão fazendo. O Go já teve uma vitória no mundo real: o Debian Code Search eliminou sua última dependência de C usando o pacote archsimd, mais antigo. O Rust seguiu o caminho da biblioteca este mês, quando o Fearless SIMD 1.0 lançou um crate SIMD estável e seguro. O Go está embutindo essa capacidade em sua toolchain, com o compilador fazendo o trabalho específico de cada CPU.
Fontes
- Platform-independent SIMD in Go - The Go Blog
- Go's Improving SIMD Support, Platform-Independent SIMD Interface - Phoronix
Artigos relacionados
Fearless SIMD 1.0 traz SIMD estável e seguro ao Rust
O Fearless SIMD 1.0, lançado em 21 de setembro, dá ao Rust SIMD seguro do SSE2 ao AVX-512, NEON e WebAssembly, com uma API estável e 3 anos de correções de segurança.
Mojo 1.1 passa a aceitar contribuições externas ao compilador
O Mojo 1.1 aceita contribuições externas ao compilador um mês após a liberação sob Apache 2.0, e completa a remoção de fn, alias e @parameter if.
LLVM debate compilar o ClangIR por omissão
Uma RFC do LLVM propõe compilar o ClangIR dentro do Clang por omissão. Ninguém o usaria sem uma opção, mas há estimativas que duplicam os tempos de compilação.