Go 1.27: el paquete simd trae SIMD portable y emulado
El paquete experimental simd de Go 1.27 ejecuta una sola ruta de código vectorial en AVX-512, NEON, wasm y RISC-V, y la emula donde falta SIMD por hardware.
4 min de lectura
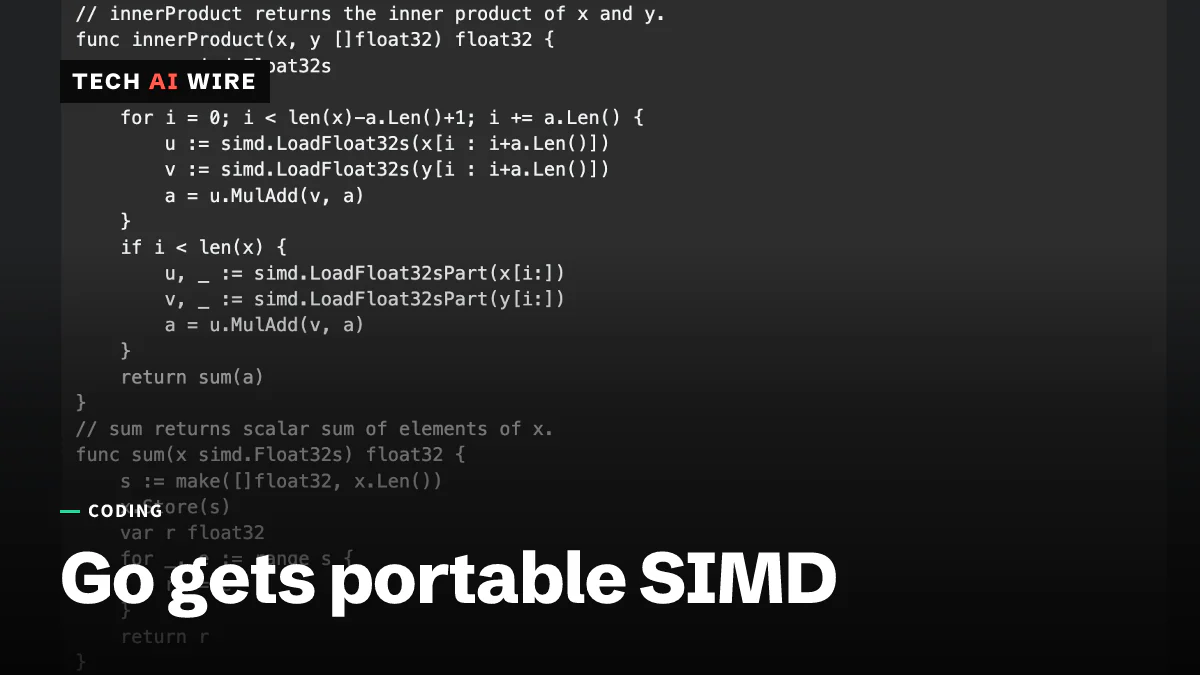
El equipo de Go ha explicado cómo funciona su nuevo paquete SIMD portable, en una entrada del blog de Go fechada el 24 de septiembre de 2026. Go 1.27 incluye un paquete experimental simd que permite que un mismo fragmento de código Go use instrucciones vectoriales en muchas CPU distintas. Eso importa porque, hasta Go 1.26, la única forma de llegar a esas instrucciones desde Go era escribir ensamblador a mano.
SIMD significa single instruction, multiple data. Es una función de la CPU que aplica una operación a todo un lote de valores a la vez, como sumar ocho pares de números en un solo paso. Acelera tareas como la compresión, la criptografía, el procesamiento de imágenes y el aprendizaje automático.
Del ensamblador a dos paquetes experimentales
Go tiene ahora dos paquetes SIMD, y ambos siguen siendo experimentos. El primero, archsimd, llegó con Go 1.26. Depende de la arquitectura: expone las instrucciones propias de cada familia de CPU, así que el código escrito para chips de Intel no funciona en Arm.
El segundo es el nuevo paquete portable simd de Go 1.27. Los autores de la entrada, David Chase y Junyang Shao, lo describen como "an experimental platform-agnostic SIMD API". Phoronix señala que el diseño toma como modelo Highway, la biblioteca de C++ de Google para código vectorial portable.
Ambos paquetes están detrás del mismo interruptor. Para activarlos, se compila con la variable de entorno GOEXPERIMENT=simd.
Por qué el SIMD portable es difícil
Las familias de CPU discrepan en casi todo lo relativo a los vectores. El blog de Go enumera los anchos de vector que admite cada plataforma.
| Plataforma | Instrucciones vectoriales | Ancho de vector |
|---|---|---|
| amd64 | AVX, AVX2, AVX-512 | 128, 256 y 512 bits |
| arm64 | NEON | 128 bits |
| arm64 (previsto para Go 1.28) | SVE | 128 a 2.048 bits |
| wasm | WebAssembly SIMD | 128 bits |
| riscv64 | RVV | 128 a 65.536 bits |
La entrada también menciona loong64, ppc64 y s390x como compatibles. Algunos chips solo revelan su ancho de vector cuando arranca un programa, así que el código no puede suponer un tamaño al compilar.
El paquete simd lo resuelve dejando el ancho fuera de los tipos. Los tipos vectoriales se llaman como los tipos primitivos en plural y con mayúscula: simd.Float32s, simd.Int8s, simd.Uint64s. Un Float32s contiene tantos flotantes de 32 bits como la CPU actual pueda procesar a la vez. Las máscaras, los valores de verdadero o falso que producen las comparaciones, tienen tipos equivalentes como Mask32s.
Cómo va rápido sin conocer el ancho
La especialización la hace el compilador. Según el blog de Go, reescribe las funciones que usan simd en variantes para cada ancho de vector, etiquetadas por ejemplo como @simd128. Después, el programa ejecuta la variante que encaja con la máquina, sin sobrecoste de despacho dentro del bucle crítico.
Un ajuste de GODEBUG controla la elección en tiempo de ejecución. simd=0 desactiva el código vectorial, y simd=128, simd=256 o simd=512 limitan el ancho. No hace falta recompilar para probar cada ruta.
Donde una plataforma no tiene instrucciones adecuadas, cada operación se emula. Los autores enumeran sus objetivos para el paquete. Debe ser "as efficient as assembly language when the source code operations match the underlying hardware". En caso contrario, debe ser "emulated as well as possible". Y debe ser "easy to read and understand (even/especially if an LLM ends up writing the code)".
Lo que falta en Go 1.27
La primera versión tiene carencias claras. No hay reducción horizontal, es decir, no existe una forma integrada de sumar todos los elementos de un vector. El propio ejemplo del blog escribe un pequeño bucle escalar para ese paso y dice que una operación ReduceSum llegará en la próxima versión.
Las instrucciones SVE de Arm también están previstas para Go 1.28, según Phoronix, junto con más operaciones. Hoy, algunas operaciones no están disponibles en algunas arquitecturas.
Qué significa esto para los desarrolladores
Si tu servicio en Go tiene un bucle crítico sobre slices de números, prueba el paquete ya en una rama. Buenos candidatos son las sumas de verificación, el análisis sintáctico, los cálculos de distancia para búsqueda vectorial y los filtros de imagen. La API portable te permite escribir ese bucle una vez en lugar de una vez por familia de CPU.
Mide cada ancho, no solo el de tu portátil. Ejecuta el mismo benchmark con GODEBUG=simd=0, simd=128, simd=256 y simd=512. El ajuste cero te da la referencia escalar gratis, y los demás muestran si los vectores más anchos compensan de verdad con tus datos.
Mantenlo fuera de cualquier cosa que no puedas recompilar rápido. Ambos paquetes SIMD están detrás de GOEXPERIMENT, y las API experimentales pueden cambiar entre versiones. Ten en cuenta también la falta de ReduceSum, ya que cualquier código que sume un vector necesita un bucle escalar temporal hasta Go 1.28.
Es el mismo intercambio que están haciendo otros ecosistemas. Go ya tuvo un logro en el mundo real: Debian Code Search eliminó su última dependencia de C usando el paquete archsimd, más antiguo. Rust eligió el camino de la biblioteca este mes, cuando Fearless SIMD 1.0 publicó un crate SIMD estable y seguro. Go está integrando esa capacidad en su cadena de herramientas, y el compilador hace el trabajo específico de cada CPU.
Fuentes
- Platform-independent SIMD in Go - The Go Blog
- Go's Improving SIMD Support, Platform-Independent SIMD Interface - Phoronix
Artículos relacionados
Fearless SIMD 1.0 lleva SIMD estable y seguro a Rust
Fearless SIMD 1.0, publicado el 21 de septiembre, da a Rust SIMD seguro desde SSE2 hasta AVX-512, NEON y WebAssembly, con una API estable y 3 años de parches de seguridad.
Mojo 1.1 empieza a aceptar aportes externos al compilador
Mojo 1.1 acepta aportes externos al compilador un mes después de la publicación bajo Apache 2.0, y completa la retirada de fn, alias y @parameter if.
LLVM debate compilar ClangIR por defecto
Una RFC de LLVM propone compilar ClangIR dentro de Clang por defecto. Nadie lo usaría sin un indicador, pero hay estimaciones que doblan los tiempos de compilación.