Go 1.27のsimdパッケージ、移植可能でエミュレーションにも対応したSIMDを実現
Go 1.27の実験的なsimdパッケージ(シムディー)は、1つのベクトルコード経路をAVX-512、NEON、wasm、RISC-Vで動かし、ハードウェアSIMDがない環境ではエミュレーションします。
4 分で読めます
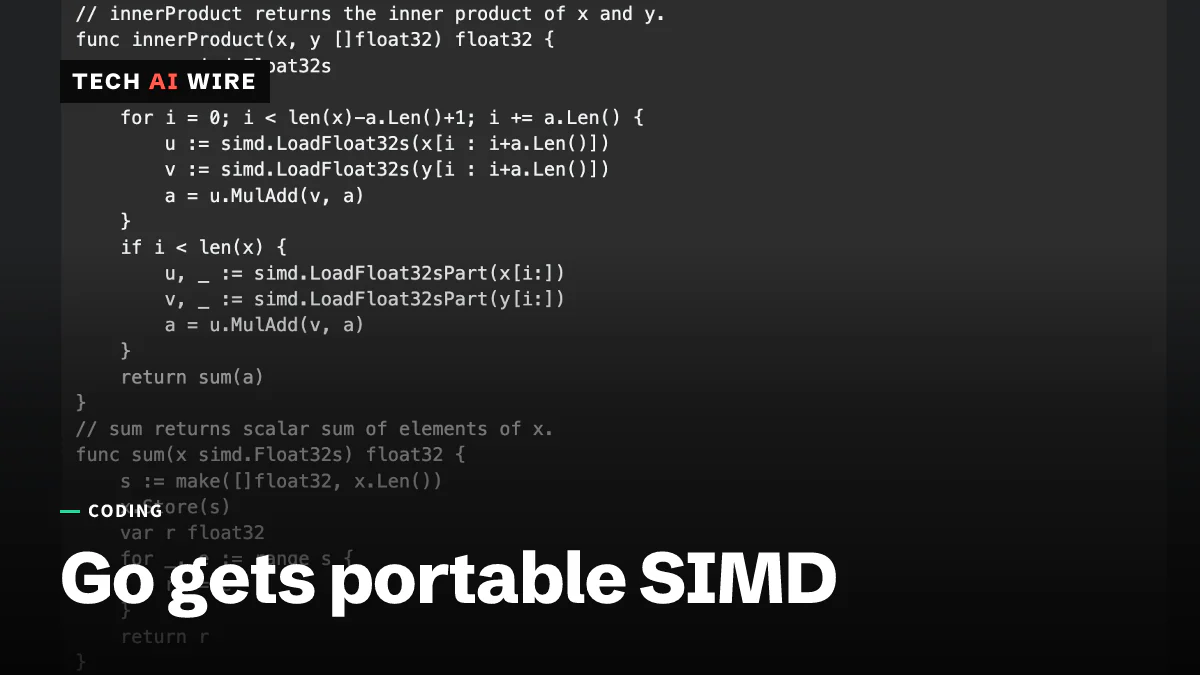
Goチームが、新しい移植可能なSIMDパッケージの仕組みを説明しました。2026年9月24日付のGoブログの記事です。Go 1.27には実験的なsimdパッケージが含まれており、1つのGoコードでさまざまなCPUのベクトル命令を使えます。これが重要なのは、Go 1.26までは、Goからこれらの命令を使うにはアセンブリを手で書くしかなかったからです。
SIMDはsingle instruction, multiple dataの略です。1つの演算を値のまとまり全体に一度に適用するCPUの機能で、たとえば8組の数の足し算を1ステップで行います。圧縮、暗号、画像処理、機械学習といった処理を高速化します。
アセンブリから2つの実験的パッケージへ
GoにはいまSIMDのパッケージが2つあり、どちらもまだ実験段階です。1つ目のarchsimdはGo 1.26で登場しました。これはアーキテクチャ依存です。CPUファミリーごとの命令をそのまま公開するため、Intelのチップ向けに書いたコードはArmでは動きません。
2つ目が、Go 1.27の新しい移植可能なsimdパッケージです。記事の著者であるDavid Chase氏とJunyang Shao氏は、これを「an experimental platform-agnostic SIMD API」と説明しています。Phoronixは、この設計が移植可能なベクトルコードのためのGoogleのC++ライブラリ、Highwayをモデルにしていると指摘しています。
どちらのパッケージも同じスイッチの後ろにあります。有効にするには、環境変数GOEXPERIMENT=simdを付けてビルドします。
移植可能なSIMDが難しい理由
CPUファミリーは、ベクトルについてほぼすべての点で食い違っています。Goブログは、各プラットフォームが対応するベクトル幅を挙げています。
| プラットフォーム | ベクトル命令 | ベクトル幅 |
|---|---|---|
| amd64 | AVX、AVX2、AVX-512 | 128、256、512ビット |
| arm64 | NEON | 128ビット |
| arm64(Go 1.28で予定) | SVE | 128〜2,048ビット |
| wasm | WebAssembly SIMD | 128ビット |
| riscv64 | RVV | 128〜65,536ビット |
記事は、loong64、ppc64、s390xも対応対象として挙げています。一部のチップはプログラムの起動時にしかベクトル幅を明かさないため、コードはビルド時にサイズを仮定できません。
simdパッケージは、型から幅を外すことでこれを解決します。ベクトル型は、プリミティブ型を大文字で始めて複数形にした名前です。simd.Float32s、simd.Int8s、simd.Uint64sといった具合です。Float32sは、現在のCPUが一度に処理できる数だけ32ビット浮動小数点数を保持します。比較が生む真偽値であるマスクにも、Mask32sのような対応する型があります。
幅を知らずに速く動く仕組み
特殊化を担うのはコンパイラです。Goブログによると、コンパイラはsimdを使う関数を、ベクトル幅ごとの派生版に書き換えます。派生版には@simd128のようなラベルが付きます。プログラムはマシンに合った派生版を実行し、ホットループの中でディスパッチのオーバーヘッドは生じません。
GODEBUGの設定で、実行時に選択を制御できます。simd=0はベクトルコードを無効にし、simd=128、simd=256、simd=512は幅の上限を設けます。各経路を試すのに再コンパイルは不要です。
適した命令がないプラットフォームでは、すべての演算がエミュレーションされます。著者たちはこのパッケージの目標を挙げています。「as efficient as assembly language when the source code operations match the underlying hardware」であること。そうでない場合は「emulated as well as possible」であること。そして「easy to read and understand (even/especially if an LLM ends up writing the code)」であることです。
Go 1.27に足りないもの
最初のリリースには明らかな欠落があります。水平方向のリダクションがないため、1つのベクトルの全要素を合計する組み込みの方法がありません。ブログ自身の例ではその部分を小さなスカラーのループで書き、次のリリースでReduceSum演算が入ると述べています。
Phoronixによると、ArmのSVE命令もGo 1.28で予定されており、さらに多くの演算も加わります。現時点では、一部のアーキテクチャで使えない演算もあります。
これが開発者にとって意味すること
Goのサービスに数値のスライスを回すホットループがあるなら、いまブランチでこのパッケージを試してください。候補として良いのは、チェックサム、パース、ベクトル検索のための距離計算、画像フィルターです。移植可能なAPIなら、そのループをCPUファミリーごとではなく一度だけ書けば済みます。
自分のノートPCの幅だけでなく、すべての幅でベンチマークを取ってください。同じベンチマークをGODEBUG=simd=0、simd=128、simd=256、simd=512で実行します。ゼロの設定ではスカラーの基準値が手間なく得られ、ほかの設定では、より広いベクトルが自分のデータで本当に効果を出すかがわかります。
すぐに作り直せないものには入れないでください。どちらのSIMDパッケージもGOEXPERIMENTの後ろにあり、実験的なAPIはリリース間で変わる可能性があります。ReduceSumがないことも計画に入れてください。ベクトルを合計するコードは、Go 1.28までは一時的なスカラーのループが必要です。
これは、ほかのエコシステムも選んでいるのと同じ取引です。Goにはすでに実例での成果が1つあります。Debian Code Searchが最後のC依存を削除しました。使ったのは旧来のarchsimdパッケージです。Rustは今月、ライブラリという道を選びました。Fearless SIMD 1.0が安定した安全なSIMDクレートを公開したのです。Goはこの機能をツールチェーンに組み込み、CPUごとの作業をコンパイラが担います。
出典
- Platform-independent SIMD in Go - The Go Blog
- Go's Improving SIMD Support, Platform-Independent SIMD Interface - Phoronix
関連記事
Fearless SIMD 1.0がRustに安定した安全なSIMDをもたらす
9月21日に公開されたFearless SIMD(フィアレスSIMD)1.0は、SSE2からAVX-512、NEON、WebAssemblyまでの安全なSIMDをRustに提供する。APIは安定し、3年間のセキュリティ修正も約束された。
Mojo 1.1、コンパイラへの外部からの貢献を受け付け開始
Mojo 1.1はApache 2.0公開の1か月後にコンパイラへの外部貢献を受け入れ、fn、alias、@parameter ifの削除も完了させた。
LLVM、ClangIRを既定でビルドするか議論
ClangIRをClangに既定で組み込むRFCが出ました。使うにはフラグが必要ですが、ビルド時間が2倍以上になるという見積もりもあります。