GPT-6 Astra faz 95% numa tarefa robótica e 10% noutra
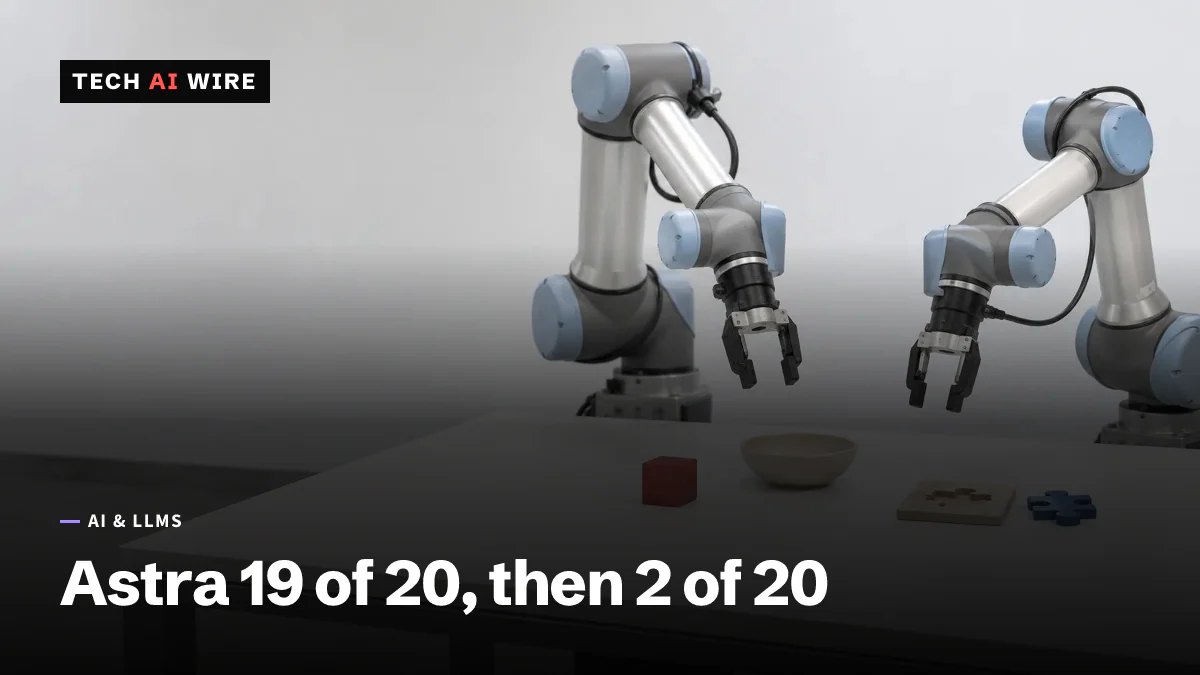
A Robocurve testou o GPT-6 Astra e o Claude Fable 5.1 em braços robóticos reais. O Astra acertou 19 em 20 na tarefa fácil e 2 em 20 na difícil.
3 min de leitura
Em números
- Astra's success rate on the block task
- 19/20
- Astra's success rate on the puzzle task
- 2/20
- cost per run for Astra on the block task
- $0.94
A Robocurve pôs o GPT-6 Astra da OpenAI e o Claude Fable 5.1 da Anthropic a controlar braços robóticos reais, e os resultados dividem-se com nitidez consoante a tarefa. O Astra completou a tarefa fácil 19 vezes em 20. Na mais difícil conseguiu 2 em 20, exatamente como o Fable 5.1. A Robocurve publicou os resultados do Astra a 4 de setembro de 2026, e os do Fable 5.1 no dia anterior.
A Robocurve é um avaliador independente, não um dos dois laboratórios. Descreve-se como uma Public Benefit Corporation e diz ter o apoio da Y Combinator.
As duas tarefas e os números
Ambos os modelos comandaram o mesmo conjunto: braços I2RT YAM bimanuais, seis graus de liberdade cada, garras de maxilas paralelas e três vistas de câmara. Cada modelo fez 20 tentativas por tarefa, pontuadas por avaliadores humanos numa escala de cinco fases.
A primeira tarefa era colocar um bloco vermelho numa taça. A segunda, encaixar uma peça de puzzle azul numa ranhura correspondente.
| Modelo | Tarefa do bloco | Tarefa do puzzle | Custo por tentativa, bloco |
|---|---|---|---|
| GPT-6 Astra | 19/20 | 2/20 | 0,94 $ |
| Claude Fable 5.1 | 8/20 | 2/20 | 2,12 $ |
| Claude Fable 5 | 1/20 | 0/20 | 2,69 $ |
O Astra foi também mais rápido. Fez em média 2,5 minutos por tentativa na tarefa do bloco, contra 6,8 minutos do Fable 5.1 e 8,2 minutos do Fable 5.
Onde a diferença desaparece
Os números do bloco parecem decisivos. Os do puzzle é que são interessantes.
Na tarefa do puzzle, os dois modelos atuais ficaram em 2 de 20. Uma pontuação de 95% e outra de 40% juntaram-se nos mesmos 10%. O que separa os modelos na tarefa fácil deixa de contar assim que é preciso encaixar uma forma numa fenda.
É um padrão conhecido. Contámos como o Astra faz 99,9% ou 62,7% no ARC-AGI-3 consoante o arnês, e aqui chega a mesma lição por outra porta. Uma percentagem isolada diz tanto sobre a tarefa como sobre o modelo.
O texto da Robocurve sobre o Fable 5.1 faz uma afirmação estreita em vez de larga. O Fable 5.1 "reached later stages of both tasks than Fable 5, completed each task more often, and produced fewer output tokens doing it."
O arnês é de código aberto
A estrutura de avaliação, chamada inspect-robots, está no GitHub sob licença MIT. Isso conta mais do que qualquer pontuação isolada.
O repositório guarda as definições das tarefas e o código de pontuação, não apenas os resultados. Os modelos ligam-se por uma interface definida, e a estrutura verifica o espaço de ação, o de observação e a taxa de controlo antes de uma tentativa arrancar. Cada tentativa fica registada com a configuração resolvida, a revisão git e as versões dos pacotes.
Ou seja, os números podem ser repetidos e contestados, o que não acontece na maioria das comparações de modelos.
O que isto significa para programadores
Leia os números por tarefa, nunca a média. Se a Robocurve tivesse dado um único número a misturar as duas tarefas, o Astra pareceria cerca do dobro do Fable 5.1. Na tarefa que é mesmo difícil, são iguais.
Se está a orçamentar um agente que toca o mundo físico, a coluna do custo merece tanta atenção como a do sucesso. O Astra fez a tarefa do bloco a 0,94 $ contra 2,12 $, por isso ali foi mais barato e melhor. O Fable 5.1 cortou bastante o preço das leituras de cache este mês, e mudanças destas movem estes números de uma avaliação para a seguinte.
Se vai construir a sua própria avaliação, clone o arnês antes de escrever uma. Já trata daquilo que costuma correr mal: validar que uma política e um robô concordam sobre o espaço de ação, e fixar a revisão exata de onde saiu um resultado.
E encare as 20 tentativas pelo que são. Chegam para separar 19 de 8. Não chegam para separar 2 de 2.
Continuação: GPT-6 Astra entra em disponibilidade geral no Bedrock e no Copilot.
Fontes
- GPT-6 Astra - Robocurve
- Claude Fable 5.1 - Robocurve
- robocurve/inspect-robots - GitHub
Artigos relacionados
OpenAI retira 3 de 722 artigos de matemática com IA por causa de um erro de sinal
A OpenAI publicou 722 manuscritos de matemática escritos por IA em 6 de outubro e retirou três um dia depois, quando um erro de sinal quebrou uma prova. Restam 719; 300 resultados têm verificações em Lean.
Claude Haiku 5.5 corta os preços em 90% em relação ao Haiku 4.5
O Claude Haiku 5.5 custa 0,10 dólar por milhão de tokens de entrada e 0,50 de saída, 90% menos que o Haiku 4.5, e marca 39,2% no Terminal-Bench 4.0, contra 0%.
Claude Sonnet 5.5 chega perto do Opus 5.5 pela metade do preço
O Claude Sonnet 5.5 marca 70,6% no Terminal-Bench 4.0 a 2/10 dólares por milhão de tokens, metade do preço do Opus 5.5. O Sonnet 4.5 será desativado em 30 de novembro de 2026.