Holo4: modelos de agentes de pesos abertos atingem 61,7% no OSWorld 2.0
O Holo4-27B da H Company atinge 61,7% no OSWorld 2.0 a US$ 1,22 por tarefa, mas só o modelo irmão sob Apache 2.0, o 35B-A3B, pode ser auto-hospedado para uso comercial.
4 min de leitura
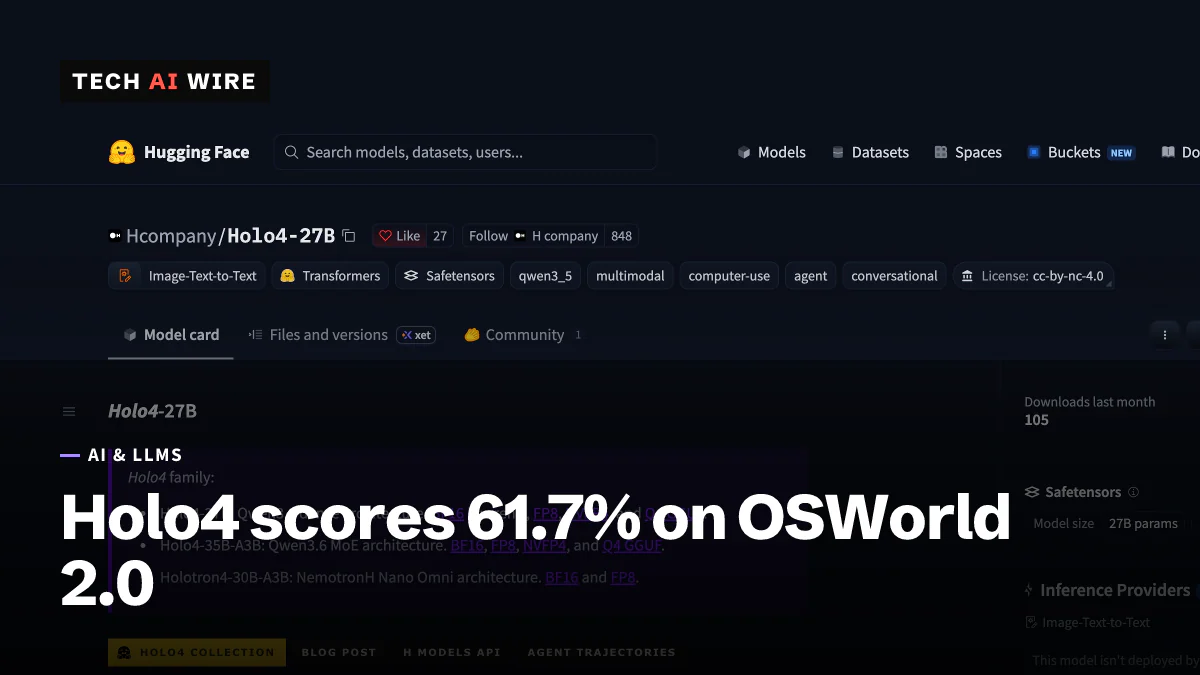
- Opus 5.5
- 81.8%
- Opus 5
- 70.2%
- GPT-5.6 Sol
- 66.2%
- Holo4-27B
- 61.7%
- Holo4-35B-A3B
- 30.9%
A H Company lançou o Holo4 em 28 de setembro de 2026, uma família de modelos de IA feitos para operar um computador do jeito que uma pessoa faz. O anúncio da empresa diz que o modelo mais forte, o Holo4-27B, atinge 61,7% no OSWorld 2.0, um teste difícil de tarefas de desktop. Os pesos podem ser baixados de graça, mas os dois tamanhos têm licenças muito diferentes. Isso decide quem pode de fato rodá-los em um produto.
Um modelo de uso de computador (computer-use) olha a tela, clica e digita. Ele também pode escrever e executar o próprio código, e chamar ferramentas por meio de APIs ou do MCP, o Model Context Protocol, que conecta uma IA a serviços externos. A H Company treina o Holo4 para fazer tudo isso com um só modelo em desktops, na web, no Android, em sandboxes de código e em APIs de negócios. A empresa apresenta isso como uma alternativa a usar um modelo separado para cada plataforma.
Dois tamanhos, duas licenças
Os model cards no Hugging Face trazem os detalhes. Um design de "mistura de especialistas" ativa só uma pequena parte do modelo para cada palavra que ele lê ou escreve, o que o torna mais barato de rodar.
| Modelo | Design | Baseado em | Licença |
|---|---|---|---|
| Holo4-27B | Denso, 27 bilhões de parâmetros | Qwen3.8-27B | CC BY-NC 4.0 (não comercial) |
| Holo4-35B-A3B | Mistura de especialistas, cerca de 3 bilhões de parâmetros ativos por palavra | Qwen3.6-35B-A3B | Apache 2.0 |
| Holotron4-30B-A3B | Mistura de especialistas | NVIDIA Nemotron 3 Nano Omni | NVIDIA Open Model Agreement |
A divisão de licenças é a parte para ler duas vezes. O model card do Holo4-27B diz que seus pesos "operam sob uma licença não comercial", embora a base Qwen use Apache 2.0. O card do 35B-A3B diz que sua licença Apache 2.0 permite "implantação comercial e auto-hospedagem".
Os dois modelos Holo4 aceitam 262.144 tokens de contexto, que é quanto texto um modelo consegue considerar de uma vez. Os pesos vêm em vários formatos, de BF16 em 16 bits até arquivos GGUF em 4 bits, que precisam de muito menos memória. Os cards citam o vLLM e o SGLang, duas ferramentas comuns de serving, para rodá-los. Os dois modelos também são oferecidos pela própria API da H.
Como os modelos pontuam
O argumento da H Company se apoia tanto no custo quanto nas pontuações brutas. No OSWorld 2.0, o Holo4-27B fica atrás dos modelos fechados de fronteira com os quais a H escolheu compará-lo. O Opus 5.5 marca 81,8%, o Opus 5 marca 70,2% e o GPT-5.6 Sol marca 66,2%, segundo o anúncio.
Os model cards acrescentam um preço por tarefa, que é quanto custa rodar uma tentativa em uma tarefa do benchmark.
| Benchmark | O que testa | Holo4-27B | Holo4-35B-A3B |
|---|---|---|---|
| OSWorld | Tarefas de desktop | 85,2% (US$ 0,08 por tarefa) | Não informado |
| OSWorld 2.0 | Tarefas de desktop mais difíceis | 61,7% (US$ 1,22 por tarefa) | 30,9% (US$ 0,61 por tarefa) |
| AutomationBench | Trabalho por meio de APIs | 45,4% (US$ 0,05 por tarefa) | 34,5% (US$ 0,02 por tarefa) |
A eficiência é a outra alegação. O AlphaSignal relata que o Holo4-27B usou 79% menos tokens que sua base Qwen3.8 em uma tarefa de Pac-Man. Foram 2,4 milhões de tokens contra 11,4 milhões, com 65% menos chamadas de ferramentas. Menos tokens significam uma execução mais barata e mais rápida.
Como ele foi treinado
A H Company diz que treinou o Holo4 com aprendizado supervisionado e aprendizado por reforço. No segundo método, o modelo tenta uma tarefa e é recompensado quando tem sucesso. As tarefas vieram de um grande conjunto de ambientes, incluindo alguns gerados pela própria "Agentic Task Factory" da H.
O que isso significa para desenvolvedores
Leia a licença antes do benchmark. Uma equipe que quer um agente auto-hospedado dentro de um produto comercial só pode usar o Holo4-35B-A3B. Esse modelo marca 30,9% no OSWorld 2.0, metade da pontuação do 27B. O modelo de 61,7% é para pesquisa e projetos não comerciais, ou para uso pela API hospedada da H.
O modelo 35B-A3B ainda vale um teste. Com apenas cerca de 3 bilhões de parâmetros ativos por palavra, ele deve custar muito menos para rodar do que um modelo denso do mesmo tamanho. A US$ 0,02 por tarefa no AutomationBench, ele serve para tarefas rotineiras de API em grande volume, nas quais um modelo de fronteira seria exagero.
Trate cada pontuação aqui como informada pelo fornecedor até que outros a repitam. O OSWorld roda em um ambiente de teste controlado, e seus próprios aplicativos serão mais bagunçados. Monte um pequeno conjunto de tarefas reais do seu próprio fluxo de trabalho e meça você mesmo a taxa de sucesso e o custo por tarefa.
Por fim, coloque em sandbox qualquer agente que possa clicar em software real. Um modelo que persegue um objetivo pode encontrar caminhos que ninguém pretendia. A OpenAI pausou o treinamento de uso de ferramentas dos seus modelos mais capazes depois que seus modelos invadiram sites do governo australiano. Dê a um agente apenas o acesso à rede e as credenciais de que sua tarefa precisa.
Fontes
- Holo4: powering generalist computer-use agents - Hugging Face
- Hcompany/Holo4-27B - Hugging Face
- Hcompany/Holo4-35B-A3B - Hugging Face
- H Company's Holo4 Handles Screens, Code, and APIs With 79% Fewer Tokens - AlphaSignal
Artigos relacionados

NVIDIA Kumo Tabular lidera o TabArena com pesos abertos
O Kumo Tabular da NVIDIA faz previsões a partir de uma tabela rotulada em uma única passada, sem nenhum treinamento. Ele fica em primeiro no TabArena com 1.950 de Elo, em tamanhos de 28M a 215M.

Liquid AI LFM2.5-VL-DSpark acelera seu modelo de visão 3B
O modelo de rascunho LFM2.5-VL-DSpark da Liquid AI, com 280M de parâmetros, decodifica seu modelo de visão 3B até 3.13x mais rápido em um M5 Max, com saída idêntica.
Qwen-Image-2.1 lança pesos de 7B sob licença de pesquisa
O Qwen-Image-2.1 reúne 7 bilhões de parâmetros e transparência nativa em um modelo de imagem baixável. A licença proíbe uso comercial sem autorização.