BlockのDessa、テキストを一切使わずに話すことを学んだ音声AI
BlockのDessa(デッサ)は、テキストを使わず、録音された人間の会話だけで訓練され、MacBook Pro M4 Maxで動きます。まず安全性の研究者が利用でき、詐欺への懸念も続いています。
4 分で読めます
数字で見る
- in Dessa's training data, only human conversation
- No text
- Nvidia GB200 NVL72 system used to train it
- 1
- minimum MacBook Pro chip to run it locally
- M4 Max
SquareとCash Appを手がけるBlockは、音声AIモデルDessaを発表しました。Dessaは人が話す録音だけで訓練され、書かれたテキストは一切使われていません。Blockは2026年10月23日にこの研究プレビューを公開し、モデルはMacBook Proで動くとしています。主張が裏付けられれば、Dessaは書き起こしを読む代わりに、声の調子や感情を聞き取る音声アシスタントの方向性を示すことになります。
まだ一般公開はされていません。BlockのDessaのページによると、Blockはまず少人数のAI安全性研究者のグループに早期アクセスを提供し、それ以外の人にはウェイトリストを用意しています。
Dessaが今の音声AIとどう違うのか
ほとんどの音声アシスタントは、段階を踏んで動きます。話した言葉をテキストに変換し、テキストモデルに返答を書かせ、その返答を読み上げます。Blockは、この処理の流れでは、声が運ぶものの大半が失われると主張しています。TechCrunchによると、同社は「あなたの声をテキストに変え、テキストだけでは運べない膨大な量の情報を捨ててしまう」と書いています。
Dessaはテキストを飛ばします。音声が入り、音声が出てきます。Blockのページには「私たちはDessaを、人間の会話だけを使ってゼロから訓練しました」とあり、テキストも、土台となる事前学習済みの言語モデルも使っていません。
Dessaは全二重(フルデュプレックス)でもあります。これは、トランシーバーではなく電話のように、聞くことと話すことを同時に行えるという意味です。Dessaは話に割って入ったり、割り込みに反応したり、笑ったりできます。こちらがまだ話している間に、「うん!」のような短い返事をすることもできます。Blockはこれを「これまでに作られた中で最も本物らしい全二重音声モデル」と呼んでいますが、この主張はまだ外部のテスターによって確かめられていません。
訓練とハードウェア
Blockによると、Dessaは大規模言語モデルが必要とする量の「数百分の一の単語数」で言語を学びました。同社のページは、話された単語は、同じ単語を書いた場合より数千倍多くのバイトを使うと指摘しています。
BlockのページとNotebookcheckによると、訓練には、72基のBlackwell GPUを搭載したラック規模のシステムであるNvidia GB200 NVL72が1台使われました。TechCrunchの記事は、Blockの言葉として「単一のNVIDIA GPU」と引用しました。Block自身のページは、GB200 NVL72システム全体を挙げています。
モデルを動かすのに必要なものは、はるかに少なくて済みます。Blockによると、DessaはM4 Max以上のチップを搭載したMacBook Proでローカルに動作し、リアルタイムより速く動きます。
| Blockが明らかにしたこと | 明らかにしていないこと |
|---|---|
| 人間の会話だけで訓練 | 何時間分か、録音の入手元 |
| GB200 NVL72 1台で訓練 | モデルの規模やパラメーター数 |
| MacBook Pro M4 Max以上で動作 | ミリ秒単位の遅延 |
| 安全性の研究者が最初にアクセス | 公開日、価格、ライセンス、重み |
CoinDeskとNotebookcheckが指摘するように、Blockは論文もベンチマークのスコアも公表していません。デモはBlockが選んだものです。あるデモでは、DessaとGPT-Live-1を組み合わせています。GPT-Live-1はAI音声で、Blockによると、その開発元は同社と関係がありません。
誰が作ったのか
このラボを率いるのはRagavan Thurairatnam氏です。CoinDeskによると、メンバーは、Squareが2020年に買収したトロントのディープラーニングのスタートアップDessaの出身で、モデルは今その名前を引き継いでいます。Thurairatnam氏はBlockのページに、「音だけから話すことを学んだモデルは未知の領域であり、外部の目で見てほしい」と書いています。
Jack Dorsey氏は、自身の会社が作ったこのモデルの成果をXで称賛しました。CoinDeskが引用したところでは、同氏は「話していると人と話しているように感じる…感情、ニュアンス、間、そして自然なリズムに満ちている」と書いています。
詐欺への懸念
同じリアルさが、人々を不安にさせています。CoinDeskによると、映画監督のJustine Bateman氏は、その目的は「人をだまして警戒を解かせることができる」ようにするためなのかと問いかけました。ジャーナリストのShiv Aroor氏は、「詐欺電話がパンデミック級になろうとしている」と書きました。
Blockのページは、安全性を別の角度からとらえています。苦しんでいる声を聞き取れない音声AIこそがリスクだと主張し、研究者に早い段階でDessaを試してほしいとしています。このページは、電子透かし、音声クローンの制限、その他の悪用対策には触れていません。
Dessaは、音声モデルにとって忙しい月に登場しました。Tech AI Wireは10月、ElevenLabsのEleven Realtime音声エージェントとxAIのGrok Voice 3.0を取り上げました。
開発者にとっての意味
まだ、これをもとに開発できるものはありません。DessaにはAPIも重みもライセンスもありません。音声製品に取り組んでいるなら、ウェイトリストに登録し、実際にアクセスできるようになるまで、Dessaを前提にした計画は待ってください。
端末上で動くという主張に注目してください。ノートPCでリアルタイムより速く動く全二重音声モデルが実現すれば、音声アプリのコストが変わります。通話で、返答のたびにクラウドとやり取りする必要がなくなるでしょう。Blockが動作要件を公表したら、より小型のMacで動くかどうかを確認してください。
声を音だけでは信頼できない世界に備えてください。アプリで支払い、サポート電話、アカウント復旧を扱うなら、「人間らしく聞こえる」声を何かの証拠として頼らないでください。折り返し電話の番号、アプリ内での確認、そのほか合成音声では通過できないチェックを加えてください。
導入する前に、未解決の疑問をBlockに確認してください。訓練に使った会話はどこから来たのか、話し手は同意したのか、そしてモデルが実在の人物の声をコピーすることを何が防ぐのか、という点です。
出典
- Dessa - the Conversation Model trained only on speech - Block
- Block's new voice model sounds eerily human - TechCrunch
- Jack Dorsey's new voice AI is impressing users and alarming fraud watchers - CoinDesk
- Jack Dorsey's new AI never read a single word, yet it can hold disturbingly human conversations - Notebookcheck
関連記事
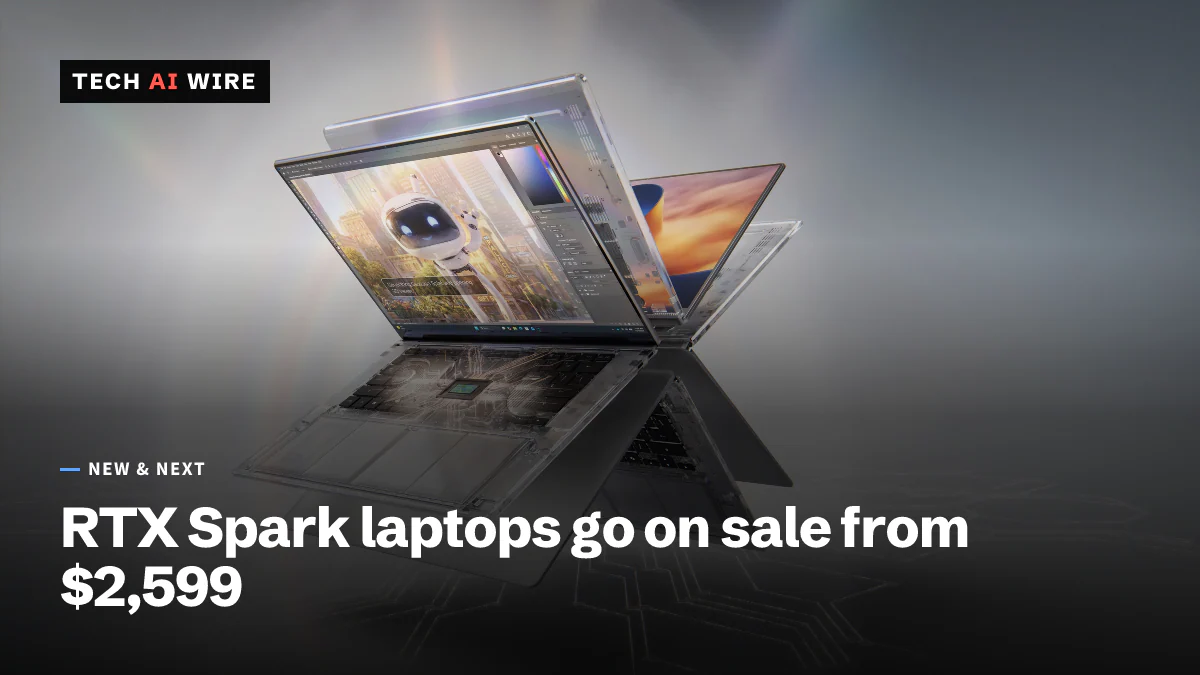
Nvidia RTX Spark搭載ノートPCが発売、2,599ドルから
Nvidia(エヌビディア)のRTX Spark搭載ノートPCが10月16日、メーカー6社から発売されました。価格は2,599ドルからで、メモリは最大128GBです。新しい74Bのオープンモデル、Nemotron 3.5 Bolt(ネモトロン3.5ボルト)も公開されました。
RTX Spark搭載のSurface Laptop Ultra、価格は2599ドルから
マイクロソフトのSurface Laptop Ultraは、NvidiaのRTX Sparkチップと最大128GBの共有メモリを組み合わせた。価格は2599.99ドルからで、予約受付中、出荷は10月16日だ。
Surface RTX Spark Dev Box、$5,999で予約受付を開始
Microsoftは2026年10月7日、Surface RTX Spark Dev Boxの米国での予約注文(プレオーダー)を$5,999で開始した。ローカルAIモデル向けに128GBのユニファイドメモリを備える。