Aleph Alpha Kolibri 1: modelo MoE abierto en alemán e inglés
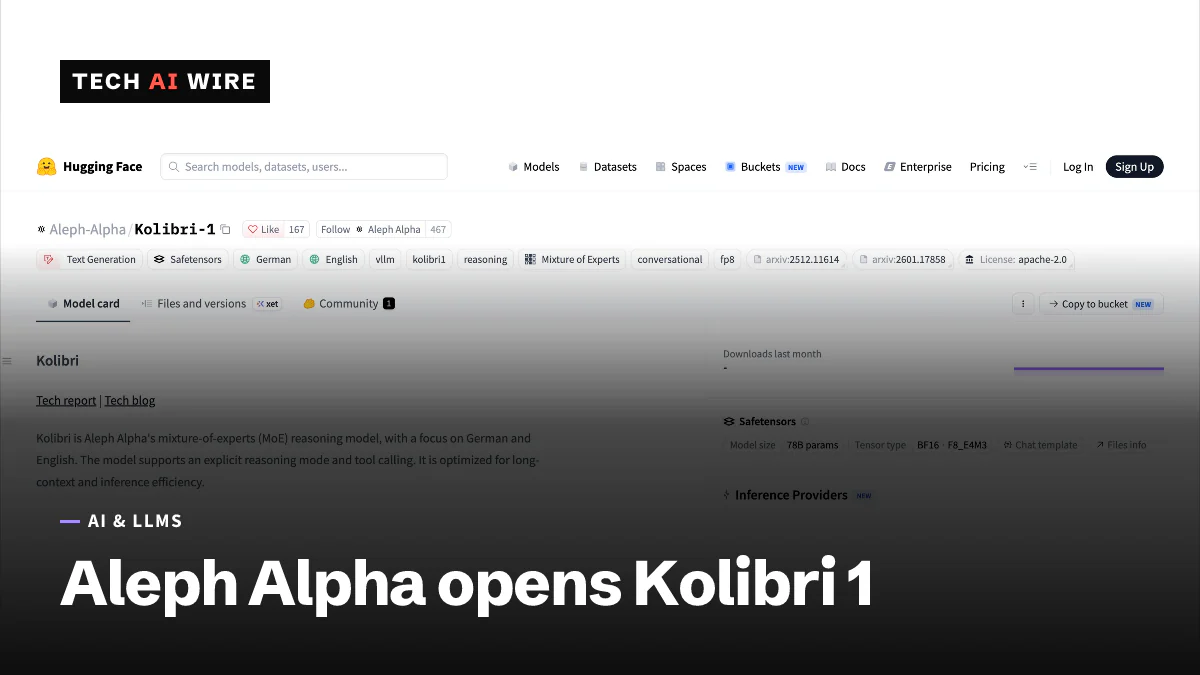
Aleph Alpha lanzó Kolibri 1 el 3 de octubre: un modelo abierto de 78.100 millones de parámetros, con 3.460 millones activos, creado para alemán e inglés y con licencia Apache 2.0.
4 min de lectura
En cifras
- total parameters
- 78.1B
- parameters active per token
- 3.46B
- size of the FP8 weights
- ~78 GB
- Nvidia B200 GPUs used for training
- 768
La empresa alemana de IA Aleph Alpha lanzó Kolibri 1 el 3 de octubre de 2026, un modelo de lenguaje de pesos abiertos creado para el alemán y el inglés. Tiene 78.100 millones de parámetros, pero solo 3.460 millones trabajan en cada token, lo que lo mantiene rápido para su tamaño. Los pesos se pueden descargar gratis y usar con fines comerciales bajo la licencia Apache 2.0. Aleph Alpha lo dirige a gobiernos y empresas reguladas que quieren ejecutar la IA en su propio hardware en lugar de enviar documentos a un proveedor externo.
Qué es Kolibri 1
Kolibri es un modelo de mezcla de expertos (MoE). En lugar de una sola red grande, tiene muchos "expertos" más pequeños, y un enrutador elige unos pocos para cada token. Según la ficha del modelo en Hugging Face, tiene 50 capas con 384 expertos cada una. Seis expertos enrutados más un experto compartido procesan cada token.
| Especificación | Kolibri 1 |
|---|---|
| Parámetros totales | 78.100 millones |
| Activos por token | 3.460 millones |
| Capas / expertos | 50 capas, 384 expertos por capa |
| Ventana de contexto | Hasta 1.048.576 tokens |
| Vocabulario | 128.000 tokens |
| Pesos | FP8, unos 78 GB |
| Licencia | Apache 2.0 |
| Fecha de corte de conocimiento | 18 de junio de 2026 |
La cifra de contexto necesita una aclaración. La ficha del modelo indica un contexto nativo de 1.048.576 tokens, aproximadamente un millón. Su fase de entrenamiento más larga usó 262.144 tokens. RuntimeWire y el blog tej.as describen 262.144 como el contexto nativo, con el millón completo probado.
Cómo se entrenó
Aleph Alpha entrenó Kolibri en 768 GPU Nvidia B200 durante 21 días, en centros de datos de Alemania y Finlandia, según su anuncio. La ficha del modelo cuenta unos 23,6 billones de tokens de entrenamiento en total, empezando por 20 billones en el preentrenamiento.
Las fuentes no coinciden en cuánto de eso es alemán. El blog de Aleph Alpha dice un 21,3 %, unos 4,3 billones de tokens. La ficha del modelo da un 23,9 % de los datos de preentrenamiento. En cualquier caso, más de una quinta parte de los datos de entrenamiento estaba en alemán.
Ese enfoque se nota en el tokenizador, la parte que divide el texto en fragmentos. RuntimeWire informa de que Kolibri divide la Ley Fundamental de Alemania en 35.190 tokens. El tokenizador que usan GPT-4o y GPT-5 necesita 41.482 para el mismo texto. Menos tokens significan menor coste y más espacio en la ventana de contexto.
Qué puntuaciones obtiene
Aleph Alpha y el blog tej.as recogen estos resultados:
| Benchmark | Kolibri 1 | Comparación |
|---|---|---|
| AIME 2025 (inglés) | 96,9 % | |
| AIME 2025 (alemán) | 87,5 % | Nemotron 3 Nano: 84,4 % |
| General (alemán) | 70,8 % | Qwen3.5 35B-A3B: 69,8 % |
| General (inglés) | 75,5 % | |
| GPQA Diamond (inglés) | 84,3 % | |
| HumanEval+ | 92,7 % | |
| Contexto largo, 1M de tokens | 63,2 % | Nemotron 3 Nano: 57,5 % |
Aleph Alpha también dice que entrenó al modelo para admitir lagunas. "Kolibri está entrenado para decir 'no lo sé' cuando la respuesta no está en el contexto", escribe la empresa. Según tej.as, el modelo también "razona en alemán ante instrucciones en alemán".
Para quién es
Aleph Alpha dirige Kolibri a trabajos "soberanos y de misión crítica" en sectores regulados, como la administración pública, la industria aeroespacial y la fabricación. El argumento es el control: un cliente puede ejecutar el modelo en sus propios servidores bajo la legislación alemana y europea. La entrada de tej.as resume el argumento como "plena libertad de despliegue y seguridad de la propiedad intelectual".
Kolibri llega en una semana ajetreada para los modelos abiertos. Ai2 lanzó el 2 de octubre AstaBrief 8B, un modelo pequeño para informes de investigación con citas.
Qué significa esto para los desarrolladores
Planifica tu hardware en función de los 78 GB completos, no de los 3.460 millones de parámetros activos. Como lo expresa tej.as, "solo unos 3.500 millones de parámetros trabajan en cada token, pero los 78.000 millones tienen que estar en memoria". El modelo funciona rápido una vez cargado. Pero necesitas más de 78 GB de memoria de acelerador solo para los pesos FP8, más espacio para el contexto.
Si tu producto atiende a hablantes de alemán, prueba Kolibri frente a tu modelo actual con texto real en alemán. El ahorro del tokenizador por sí solo puede reducir costes. Además, sus puntuaciones en alemán superan por poco a los dos modelos abiertos con los que lo compara tej.as. Mide la calidad de las respuestas con tus propios documentos, no solo con benchmarks.
La licencia Apache 2.0 facilita su adopción. Puedes ajustarlo, incluirlo en un producto y ejecutarlo totalmente sin conexión. Para los equipos del sector público o sanitario, eso elimina la cuestión de la transferencia de datos que bloquea muchos modelos alojados.
Trata con cuidado el contexto de un millón de tokens. La fase de entrenamiento más larga usó 262.144 tokens. La puntuación del 63,2 % con 1M de tokens muestra que la recuperación cae a longitud completa. Mantén el material crítico dentro de un cuarto de millón de tokens hasta que hayas probado entradas más largas con tu propia carga de trabajo.
Fuentes
- Kolibri Has Landed: A Sovereign Open-Weight Model - Aleph Alpha
- Aleph-Alpha/Kolibri-1 - Hugging Face
- Aleph Alpha releases German AI model with 78 GB of FP8 weights - RuntimeWire
- Aleph Alpha Kolibri: How the Sovereign German LLM Works - tej.as
Artículos relacionados

Xiaomi lanza MiMo-V2.6-Pro con 1 billón de parámetros en pesos abiertos bajo MIT
MiMo-V2.6-Pro de Xiaomi tiene 1,02 billones de parámetros, 42.000 millones activos, un contexto de 1 millón de tokens y pesos con licencia MIT, pero necesita unos 680 GB de memoria de GPU.
AstaBrief 8B: el modelo abierto de Ai2 escribe informes con citas
Ai2 lanzó AstaBrief 8B, un modelo con licencia Apache 2.0 basado en Qwen3-8B que escribe informes de investigación con citas en 51,1 segundos, 3,5 veces más rápido que el modo Thinking de Asta.

Las decisiones tipadas de Laya, explicadas
Un modelo de decisiones tipadas rellena preguntas fijas con respuestas tipadas y un número de confianza. Los pesos abiertos de Laya, 421M, le permiten comprobarlo usted mismo.