Aleph Alpha Kolibri 1: offenes MoE-Modell für Deutsch und Englisch
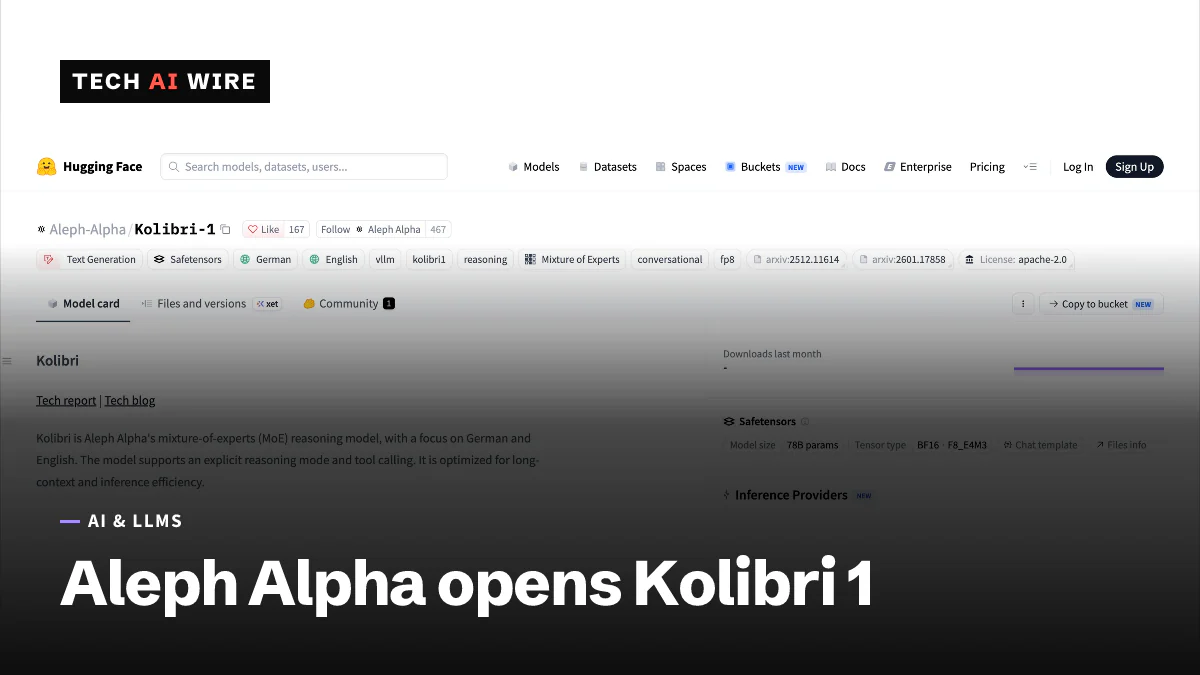
Aleph Alpha hat Kolibri 1 am 3. Oktober veröffentlicht: ein offenes Modell mit 78,1 Milliarden Parametern, davon 3,46 Milliarden aktiv, gebaut für Deutsch und Englisch, unter der Lizenz Apache 2.0.
4 Min. Lesezeit
Die Zahlen
- total parameters
- 78.1B
- parameters active per token
- 3.46B
- size of the FP8 weights
- ~78 GB
- Nvidia B200 GPUs used for training
- 768
Das deutsche KI-Unternehmen Aleph Alpha hat am 3. Oktober 2026 Kolibri 1 veröffentlicht, ein Sprachmodell mit offenen Gewichten, das für Deutsch und Englisch gebaut ist. Es hat 78,1 Milliarden Parameter, aber nur 3,46 Milliarden arbeiten an jedem Token. Das hält es für seine Größe schnell. Die Gewichte lassen sich unter der Lizenz Apache 2.0 kostenlos herunterladen und kommerziell nutzen. Aleph Alpha richtet es an Regierungen und regulierte Unternehmen, die KI auf eigener Hardware betreiben wollen, statt Dokumente an einen externen Anbieter zu schicken.
Was Kolibri 1 ist
Kolibri ist ein Mixture-of-Experts-Modell (MoE). Statt eines großen Netzes hat es viele kleinere "Experten", und ein Router wählt für jedes Token einige davon aus. Laut der Modellkarte auf Hugging Face hat es 50 Schichten mit je 384 Experten. Sechs geroutete Experten plus ein gemeinsamer Experte verarbeiten jedes Token.
| Merkmal | Kolibri 1 |
|---|---|
| Parameter insgesamt | 78,1 Milliarden |
| Aktiv pro Token | 3,46 Milliarden |
| Schichten / Experten | 50 Schichten, 384 Experten pro Schicht |
| Kontextfenster | Bis zu 1.048.576 Token |
| Vokabular | 128.000 Token |
| Gewichte | FP8, etwa 78 GB |
| Lizenz | Apache 2.0 |
| Wissensstichtag | 18. Juni 2026 |
Die Kontextangabe braucht eine Anmerkung. Die Modellkarte nennt einen nativen Kontext von 1.048.576 Token, etwa eine Million. Die längste Trainingsphase des Modells nutzte 262.144 Token. RuntimeWire und der Blog tej.as beschreiben 262.144 als nativ und die volle Million als getestet.
Wie es trainiert wurde
Aleph Alpha hat Kolibri 21 Tage lang auf 768 Nvidia-B200-GPUs trainiert, in Rechenzentren in Deutschland und Finnland, heißt es in der Ankündigung. Die Modellkarte zählt insgesamt etwa 23,6 Billionen Trainingstoken, beginnend mit 20 Billionen im Pre-Training.
Die Quellen unterscheiden sich darin, wie viel davon Deutsch ist. Aleph Alphas Blog nennt 21,3 %, etwa 4,3 Billionen Token. Die Modellkarte gibt 23,9 % der Pre-Training-Daten an. So oder so war mehr als ein Fünftel der Trainingsdaten Deutsch.
Dieser Schwerpunkt zeigt sich im Tokenizer, dem Teil, der Text in Stücke zerlegt. RuntimeWire berichtet, dass Kolibri das deutsche Grundgesetz in 35.190 Token zerlegt. Der Tokenizer von GPT-4o und GPT-5 braucht für denselben Text 41.482. Weniger Token bedeuten geringere Kosten und mehr Platz im Kontextfenster.
Wie es abschneidet
Aleph Alpha und der Blog tej.as nennen diese Ergebnisse:
| Benchmark | Kolibri 1 | Vergleich |
|---|---|---|
| AIME 2025 (Englisch) | 96,9 % | |
| AIME 2025 (Deutsch) | 87,5 % | Nemotron 3 Nano: 84,4 % |
| Gesamt (Deutsch) | 70,8 % | Qwen3.5 35B-A3B: 69,8 % |
| Gesamt (Englisch) | 75,5 % | |
| GPQA Diamond (Englisch) | 84,3 % | |
| HumanEval+ | 92,7 % | |
| Langer Kontext, 1 Mio. Token | 63,2 % | Nemotron 3 Nano: 57,5 % |
Aleph Alpha sagt außerdem, es habe das Modell darauf trainiert, Lücken zuzugeben. "Kolibri ist darauf trainiert, 'Ich weiß es nicht' zu sagen, wenn die Antwort nicht im Kontext steht", schreibt das Unternehmen. Laut tej.as denkt das Modell außerdem "bei deutschen Prompts auf Deutsch".
Für wen es gedacht ist
Aleph Alpha zielt mit Kolibri auf "souveräne, missionskritische" Arbeit in regulierten Bereichen wie öffentlicher Verwaltung, Luft- und Raumfahrt und Fertigung. Das Argument ist Kontrolle: Ein Kunde kann das Modell auf eigenen Servern unter deutschem und europäischem Recht betreiben. Der Beitrag von tej.as fasst das Argument als "volle Freiheit beim Einsatz und Sicherheit des geistigen Eigentums" zusammen.
Kolibri erscheint in einer ereignisreichen Woche für offene Modelle. Ai2 hat am 2. Oktober AstaBrief 8B veröffentlicht, ein kleines Modell für Forschungsberichte mit Quellenangaben.
Was das für Entwickler bedeutet
Plane deine Hardware für die vollen 78 GB, nicht für die 3,46 Milliarden aktiven Parameter. Wie tej.as es formuliert: "Nur etwa 3,5 Milliarden Parameter arbeiten an jedem Token, aber alle 78 Milliarden müssen im Speicher liegen." Das Modell läuft schnell, sobald es geladen ist. Du brauchst aber mehr als 78 GB Beschleunigerspeicher allein für die FP8-Gewichte, plus Platz für den Kontext.
Wenn dein Produkt deutschsprachige Nutzer bedient, teste Kolibri auf echten deutschen Texten gegen dein aktuelles Modell. Allein die Ersparnis beim Tokenizer kann Kosten senken, und seine deutschen Werte liegen knapp vor den beiden offenen Modellen, mit denen tej.as es vergleicht. Miss die Antwortqualität an deinen eigenen Dokumenten, nicht nur an Benchmarks.
Die Lizenz Apache 2.0 macht die Einführung leicht. Du kannst das Modell feinabstimmen, in einem Produkt ausliefern und vollständig offline betreiben. Für Teams im öffentlichen Sektor oder im Gesundheitswesen entfällt damit die Frage der Datenübertragung, an der viele gehostete Modelle scheitern.
Geh mit dem Kontext von einer Million Token vorsichtig um. Die längste Trainingsphase nutzte 262.144 Token, und der Wert von 63,2 % bei 1 Mio. Token zeigt, dass die Erinnerung bei voller Länge nachlässt. Halte kritisches Material innerhalb einer Viertelmillion Token, bis du längere Eingaben mit deiner eigenen Arbeitslast getestet hast.
Quellen
- Kolibri Has Landed: A Sovereign Open-Weight Model - Aleph Alpha
- Aleph-Alpha/Kolibri-1 - Hugging Face
- Aleph Alpha releases German AI model with 78 GB of FP8 weights - RuntimeWire
- Aleph Alpha Kolibri: How the Sovereign German LLM Works - tej.as
Ähnliche Artikel

Xiaomi veröffentlicht MiMo-V2.6-Pro mit 1 Billion Parametern als offene Gewichte unter MIT
Xiaomis MiMo-V2.6-Pro hat 1,02 Billionen Parameter, davon 42 Milliarden aktiv, einen Kontext von 1 Million Tokens und MIT-lizenzierte Gewichte, braucht aber rund 680 GB GPU-Speicher.
AstaBrief 8B: Ai2s offenes Modell schreibt Berichte mit Quellenangaben
Ai2 hat AstaBrief 8B veröffentlicht, ein Apache-2.0-Modell auf Basis von Qwen3-8B, das Forschungsberichte mit Quellenangaben in 51,1 Sekunden schreibt, 3,5-mal schneller als Astas Thinking mode.

Layas typisierte Entscheidungen, erklärt
Ein Modell für typisierte Entscheidungen füllt feste Fragen mit typisierten Antworten und einer Vertrauenszahl. Layas offene 421M-Gewichte lassen Sie das selbst prüfen.