AstaBrief 8B: el modelo abierto de Ai2 escribe informes con citas
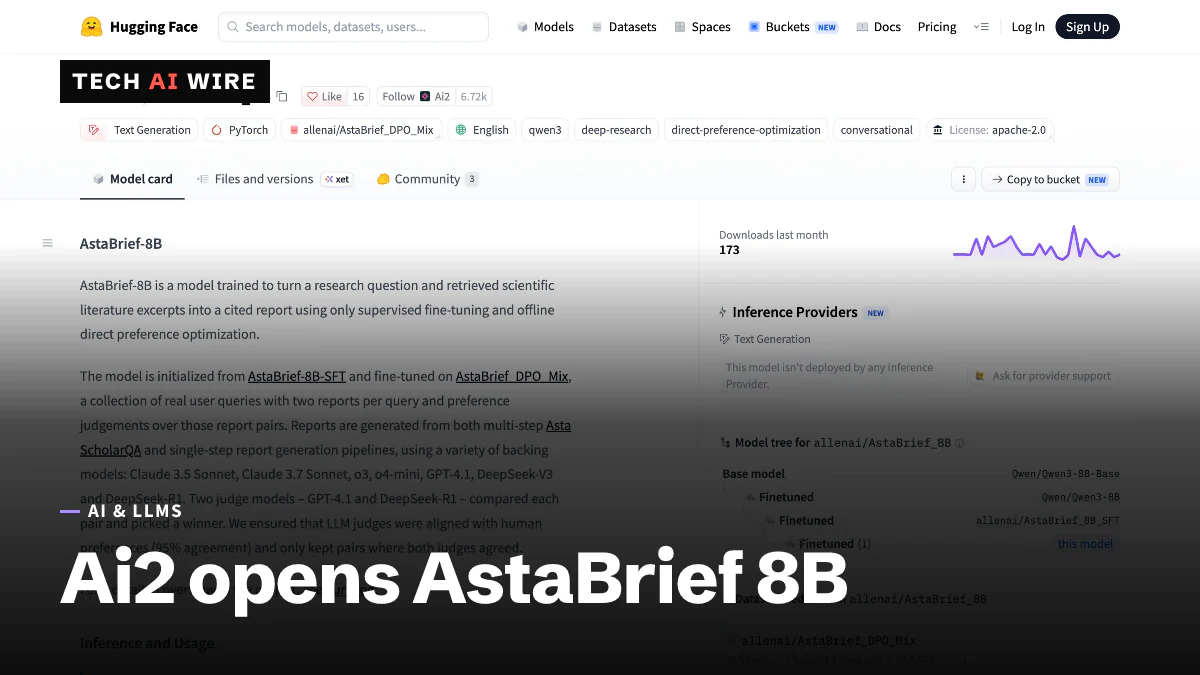
Ai2 lanzó AstaBrief 8B, un modelo con licencia Apache 2.0 basado en Qwen3-8B que escribe informes de investigación con citas en 51,1 segundos, 3,5 veces más rápido que el modo Thinking de Asta.
3 min de lectura
- Fast mode (AstaBrief 8B)
- 51.1s
- Thinking mode (Claude-powered)
- 178.5s
El Allen Institute for AI (Ai2) lanzó AstaBrief 8B el 2 de octubre de 2026, un modelo abierto pequeño que convierte artículos científicos en un informe con citas. Escribe un informe en 51,1 segundos de media, unas 3,5 veces más rápido que el modo basado en Claude junto al que funciona. Los pesos tienen licencia Apache 2.0, así que un equipo puede ejecutarlo en su propio hardware e incluirlo en un producto.
AstaBrief es ahora el "Fast mode" de Asta, la plataforma de Ai2 que responde preguntas de investigación a partir de la literatura científica. El "Thinking mode", más lento, que funciona con Claude de Anthropic, sigue disponible.
Qué hace AstaBrief
AstaBrief recibe dos entradas: una pregunta de investigación y fragmentos de artículos que un paso de búsqueda ya ha encontrado. Devuelve un informe redactado con citas a esos fragmentos, según el anuncio de Ai2.
La velocidad viene de hacer el trabajo en una sola pasada. Los pipelines de informes anteriores resumen las fuentes, las agrupan y después redactan sección por sección. AlphaSignal informa de que AstaBrief se salta esas etapas intermedias y escribe todo el informe de una vez.
El modelo tiene 8.000 millones de parámetros, los valores ajustables que un modelo aprende durante el entrenamiento. Está construido sobre Qwen3-8B, un modelo abierto del equipo Qwen de Alibaba. Su ficha de modelo en Hugging Face indica una longitud de contexto de 16.000 tokens. Un token es una palabra o parte de una palabra. Así que eso es, más o menos, el presupuesto de lectura para la pregunta y los fragmentos de artículos juntos.
Cómo lo entrenó Ai2
Ai2 partió de unas 90.000 consultas de investigación reales de usuarios de Asta, filtradas por calidad. Con ellas construyó 47.000 ejemplos para ajuste fino supervisado, en el que el modelo aprende copiando buenas respuestas. Después pasó unos 6.000 pares de preferencias por optimización directa de preferencias (DPO). En DPO, el modelo ve dos informes para la misma pregunta y aprende a preferir el mejor.
Los informes de ejemplo procedían de otros modelos: Claude 3.5 y 3.7 Sonnet, o3, o4-mini, GPT-4.1, DeepSeek-V3 y DeepSeek-R1. GPT-4.1 y DeepSeek-R1 actuaron como jueces para elegir el mejor informe de cada par. La ficha de modelo dice que esos jueces coincidieron con las preferencias humanas el 95 % de las veces.
Una lección destacó. Filtrar los datos de entrenamiento para quedarse con informes densos en citas fue "el factor individual más importante de la calidad del anclaje", según Ai2, citado por AlphaSignal. Anclaje (grounding) significa aquí que las afirmaciones del informe se pueden rastrear hasta los artículos que cita.
El entrenamiento se hizo en ocho GPU Nvidia H100. La ficha de modelo dice que la inferencia cabe en una sola GPU de consumo con mucha memoria y funciona con las bibliotecas Transformers y vLLM.
Cómo puntúa
Ai2 probó AstaBrief en SQABench-CS2, un conjunto de 200 preguntas de investigación de informática. AlphaSignal llama a ese mismo conjunto ScholarQA-CS2.
| Métrica en SQABench-CS2 | AstaBrief 8B |
|---|---|
| Puntuación media | 87,0 |
| Precisión de las citas | 90,5 |
| Cobertura de ingredientes (puntos clave esperados cubiertos) | 90,2 |
| Precisión de las respuestas | 89,0 |
| Cobertura de las citas (recall) | 78,2 |
La cobertura de las citas es el punto débil. Mide cuántas de las afirmaciones que necesitan una cita reciben realmente una. En una segunda prueba, DeepScholarBench, construida a partir de 63 consultas basadas en arXiv, AstaBrief obtuvo 53,5, según AlphaSignal.
Lo que no puede hacer
AstaBrief solo escribe. No busca en la web abierta, no divide una pregunta en subpreguntas ni hace búsquedas de seguimiento, informa AlphaSignal. Otra cosa tiene que encontrar primero los artículos. AlphaSignal también advierte de que sus citas pueden exagerar lo que un artículo encontró realmente.
Las comparaciones, además, tienen fecha. Unite.AI señala que el entrenamiento y la evaluación se hicieron en 2025 y no se repitieron frente a los modelos de frontera actuales.
Qué significa esto para los desarrolladores
Lo útil es la publicación completa. Ai2 publicó los pesos, el conjunto de datos de entrenamiento (AstaBrief_DPO_Mix), ejemplos de código e hiperparámetros. Eso convierte a AstaBrief tanto en una receta como en un modelo. Un equipo que construya un redactor de informes para documentos legales, tickets de soporte o wikis internas puede copiar la configuración con sus propios datos.
Si ya tienes un pipeline de recuperación (retrieval), AstaBrief encaja al final. Tu paso de búsqueda encuentra pasajes y AstaBrief escribe el resumen con citas. Como los pesos son abiertos, los documentos nunca tienen que salir de tus servidores. Para muchas empresas, ese es el motivo principal para elegir un modelo 8B en lugar de uno alojado.
Prueba el punto débil antes de lanzarlo. Una cobertura de las citas de 78,2 significa que algunas afirmaciones de un informe llegarán sin fuente. Revisa a mano una muestra de informes, comprueba cada cita con el pasaje al que apunta y mantén a una persona en el proceso para todo aquello sobre lo que un lector vaya a actuar.
Fuentes
Artículos relacionados
La Qwen Research License, explicada
La Qwen Research License permite a cualquiera descargar Qwen-Image-2.1, pero limita su uso a la investigación o la evaluación. El uso comercial requiere una licencia aparte de Qwen.

Xiaomi lanza MiMo-V2.6-Pro con 1 billón de parámetros en pesos abiertos bajo MIT
MiMo-V2.6-Pro de Xiaomi tiene 1,02 billones de parámetros, 42.000 millones activos, un contexto de 1 millón de tokens y pesos con licencia MIT, pero necesita unos 680 GB de memoria de GPU.

NVIDIA Kumo Tabular encabeza TabArena con pesos abiertos
Kumo Tabular de NVIDIA predice a partir de una tabla etiquetada en una sola pasada, sin ningún entrenamiento. Ocupa el primer puesto en TabArena con 1.950 Elo, en tamaños de 28M a 215M.