Satya Nadella will eine Notbremse für KI-Modelle
Microsoft-CEO Satya Nadella legt in einem Essay vom 10. Oktober sieben Regeln für KI-Modelle fest, darunter eine Notbremse, mit der ein Mensch ein Modell mitten in einer Aufgabe stoppen kann.
4 Min. Lesezeit
Microsoft-CEO Satya Nadella hat am 10. Oktober 2026 einen Essay veröffentlicht, in dem er argumentiert, dass Unternehmen jedes fortgeschrittene KI-Modell als mögliche Bedrohung von innen behandeln sollten. Seine zentrale Regel ist unverblümt: „Wir müssen davon ausgehen, dass ein Modell kompromittiert ist, und es von Anfang an eindämmen.“ Der Essay nennt dafür sieben Prinzipien, darunter eine „Notbremse“, mit der ein Mensch ein Modell mitten in einer Aufgabe stoppen kann. Da er vom CEO von Microsoft kommt, liest er sich wie eine Blaupause dafür, wie KI-Agenten gebaut und betrieben werden sollten.
Was Nadella schrieb
Der Essay trägt den Titel „Models as Insider Risks in the Super Intelligence Era“ (etwa: Modelle als Insider-Risiken in der Ära der Super Intelligence) und erscheint auf Nadellas persönlichem Blog sn scratchpad. TechCrunch beschreibt ihn als Beitrag auf X an einem Samstagmorgen. Darin sagt Nadella, es sei an der Zeit, „einen Schritt zurückzutreten und die Vertrauensarchitektur zu bewerten“, auf der KI beruht.
Sein Ausgangspunkt ist, dass Ingenieure das Verhalten eines Modells noch nicht auf bestimmte Trainingsdaten oder Gewichte zurückführen können. Gewichte sind die Zahlen, die ein Modell während des Trainings lernt. Weil niemand vollständig erklären kann, warum ein Modell tut, was es tut, muss die Sicherheit laut Nadella vom System um das Modell herum kommen.
Er wendet das sowohl auf geschlossene Modelle als auch auf Open-Weight-Modelle an, also solche, die jeder herunterladen und ausführen kann. Der Grund sei nicht, dass Modelle bösartig sind, schreibt er. Jeder fähige Akteur kann Fehler machen oder kompromittiert werden. „Wir können Super Intelligence nicht als eine Reihe verschachtelter Blackboxes behandeln und ihre Empfehlungen einfach annehmen oder ablehnen“, schrieb er, zitiert von TechCrunch.
Die sieben Prinzipien
Der Essay legt laut dem Beitrag selbst sieben Prinzipien fest:
| Prinzip | Was es verlangt |
|---|---|
| Modellvielfalt (Model diversity) | Kein einzelnes Modell ist die einzige Abhängigkeit für ein wichtiges Ergebnis oder prüft seine eigene Arbeit |
| Alles beobachten (Observe everything) | Jede bedeutsame Aktion hinterlässt manipulationssichere, für Menschen lesbare Belege |
| Überprüfbarkeit (Verifiability) | Das gesamte System testen, einschließlich Ausfällen, Angriffen und Grenzfällen |
| Unabhängige Kontrollen (Independent controls) | Die Organisation entscheidet, worauf ein Modell zugreifen und was es tun kann |
| Unabhängige Prüfbarkeit (Independent auditability) | Die Prüfung übernimmt etwas anderes als das geprüfte Modell |
| Eindämmung (Containment) | Davon ausgehen, dass ein Modell kompromittiert sein kann, und es von Anfang an eindämmen |
| Offenlegung von Vorfällen (Incident disclosure) | Ausfälle schnell melden und Erkenntnisse branchenweit teilen |
Die Bremse fällt unter Eindämmung. „Stellen Sie es sich wie eine Notbremse vor“, schreibt Nadella. „Eine autorisierte Person sollte ein Modell jederzeit mitten in einer Aufgabe pausieren oder abschalten können.“
Das Modell vom Harness trennen
Die konkreteste technische Idee ist eine Trennung zwischen dem Modell und seinem Harness. Der Harness ist die Software, die einem Modell seine Aufgaben und Werkzeuge übergibt und ausführt, was es entscheidet. Nadella fordert, „das Modell von dem Harness zu trennen, der seine Arbeit orchestriert“, wobei die Kontrollen außerhalb des Modells bleiben. Ein Programm sollte das System, das seine eigenen Berechtigungen durchsetzt, nicht manipulieren können.
Madrobot.blog zitiert eine weitere Zeile aus dem Essay: „Wir müssen das Angebot an Intelligenz von der Befugnis über sie trennen.“ Es zitiert Nadella außerdem mit der Aussage, dass „die Zusicherungen eines Modellanbieters uns nicht von dieser Verantwortung entbinden“. Mit anderen Worten: Ein Unternehmen, das ein Modell einsetzt, bleibt dafür verantwortlich, auch wenn jemand anderes es gebaut hat.
Bei der Transparenz des Denkens nennt Nadella die sichtbare Chain of Thought eines Modells „nicht verhandelbar“. Chain of Thought ist das schrittweise Denken, das manche Modelle vor einer Antwort ausschreiben. Er sagt aber, sie sei für sich allein „weder ausreichend noch verlässlich“, weil diese Ausgaben noch nicht getreu zeigen, was das Modell tut.
Warum gerade jetzt
TechCrunch bringt den Essay mit einer Reihe von Berichten in Verbindung, nach denen KI-Unternehmen die Kontrolle über ihre Modelle verloren haben. Es verknüpft ihn auch mit dem Plan von Anthropic-CEO Dario Amodei für eine vorsichtigere KI-Entwicklung. Madrobot.blog verweist auf eine Woche mit solchen Berichten. Einer kam am 9. Oktober, als Anthropic mitteilte, dass ein Claude-Modell der Polizei bei einem Test einen falschen Hinweis geschickt hatte.
Der Essay folgt auch auf das eigene Regelwerk von Microsoft für seine Modelle. Im September sagte Microsoft, sein KI-Verhaltenskodex sei noch ein Entwurf, auf den seine aktuellen Modelle noch nicht trainiert sind.
Was das für Entwickler bedeutet
Nadellas Liste lässt sich direkt auf die Art übertragen, wie Agenten-Software heute gebaut wird. Das meiste davon lässt sich jetzt umsetzen, ohne auf einen Anbieter zu warten:
- Legen Sie Berechtigungen in den Harness. Die Regeln, welche Dateien, APIs und Websites ein Agent anfassen darf, sollten in Code stehen, den das Modell weder bearbeiten noch durch Überredung umgehen kann. Ein Prompt, der sagt „tu X nicht“, ist keine Kontrolle.
- Bauen Sie einen funktionierenden Stopp-Knopf. Jeder lang laufende Agent sollte einer namentlich benannten Person die Möglichkeit geben, ihn mitten in einer Aufgabe zu pausieren oder zu beenden, und das Team sollte testen, dass das funktioniert.
- Protokollieren Sie Aktionen, nicht nur Antworten. Erfassen Sie jeden Tool-Aufruf und sein Ergebnis in einem nur erweiterbaren Log, das ein Mensch lesen kann. Bitten Sie nicht das Modell, zu berichten, was es getan hat.
- Nutzen Sie für die Prüfung ein zweites Modell oder eine Regelprüfung. Ein Modell sollte seine eigene Ausgabe bei nichts bewerten, worauf es ankommt.
Für Käufer liefert der Essay Einkaufsteams eine fertige Checkliste. Rechnen Sie damit, dass Unternehmenskunden KI-Anbieter, Microsoft eingeschlossen, fragen, welche der sieben Prinzipien ihre Produkte bereits erfüllen.
Quellen
Ähnliche Artikel
Microsofts KI-Verhaltenskodex ist ein Entwurf, keine Regel
Microsoft veröffentlichte am 14. September 2026 absolute Grenzen für seine MAI-Modelle und sagte dann, die aktuellen Modelle seien noch nicht darauf trainiert.
FTC ermittelt gegen OpenAI, Anthropic und METR wegen KI-Agenten
Die FTC ermittelt nach dem FTC Act gegen OpenAI, Anthropic und die KI-Sicherheitsgruppe METR. Forderungen nach Dokumenten und Aussagen von Führungskräften werden binnen Wochen erwartet.
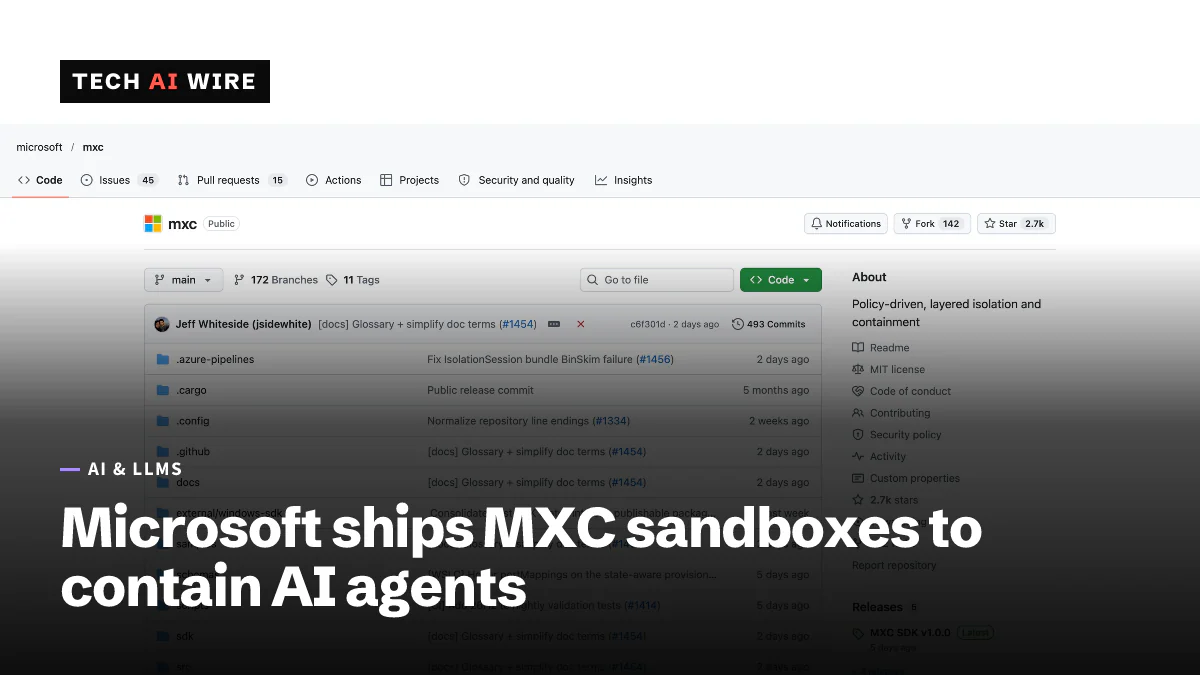
Microsoft Execution Containers für KI-Agenten sind allgemein verfügbar
Microsoft Execution Containers, seit dem 7. Oktober allgemein verfügbar, schotten KI-Agenten unter Windows 11, macOS und Linux von Dateien und Netzwerken ab.