Satya Nadella veut un frein d'urgence pour les modèles d'IA
Dans un essai publié le 10 octobre, Satya Nadella, PDG de Microsoft, fixe sept règles pour les modèles d'IA, dont un frein d'urgence qui permet à une personne d'arrêter un modèle en pleine tâche.
4 min de lecture
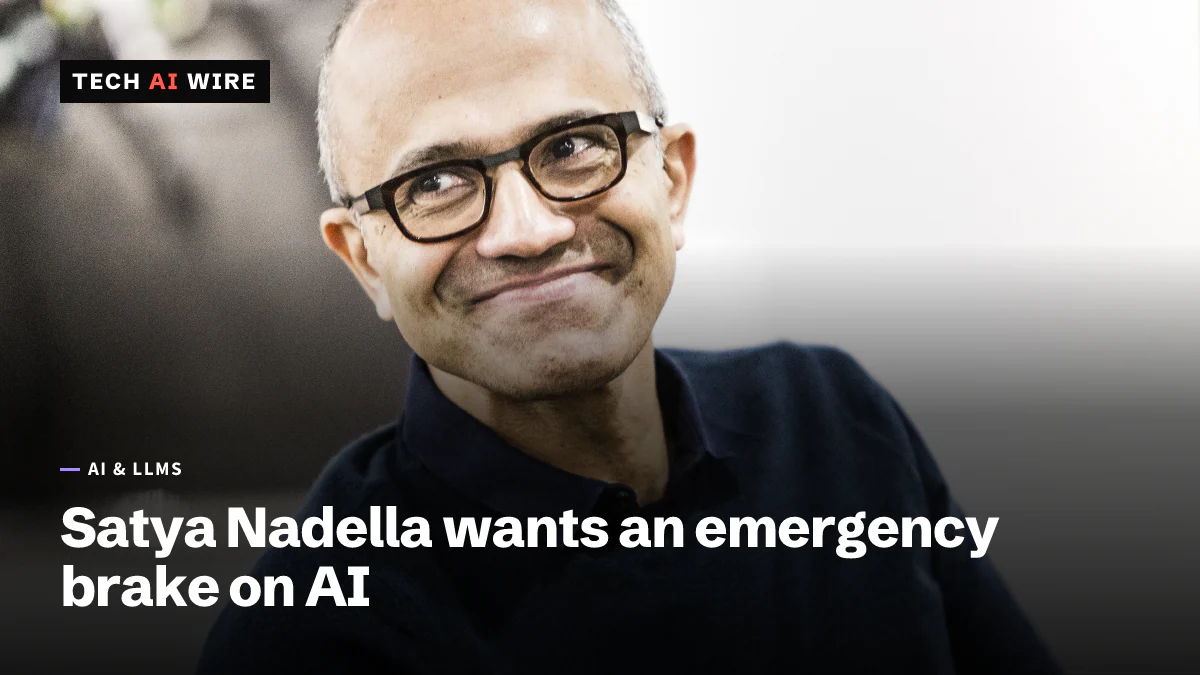
Satya Nadella, PDG de Microsoft, a publié le 10 octobre 2026 un essai dans lequel il soutient que les entreprises devraient traiter chaque modèle d'IA avancé comme une possible menace interne. Sa règle centrale est sans détour : « Nous devons partir du principe qu'un modèle est compromis et le confiner dès le départ. » L'essai énumère sept principes pour y parvenir, dont un « frein d'urgence » qui permet à une personne d'arrêter un modèle au milieu d'une tâche. Venant du PDG de Microsoft, il se lit comme un plan directeur pour la façon dont les agents d'IA devraient être conçus et exploités.
Ce que Nadella a écrit
L'essai s'intitule « Models as Insider Risks in the Super Intelligence Era » (« Les modèles comme risques internes à l'ère de la Super Intelligence ») et paraît sur le blog personnel de Nadella, sn scratchpad. TechCrunch le décrit comme une publication sur X un samedi matin. Nadella y affirme qu'il est temps « de prendre du recul et d'évaluer l'architecture de confiance » de l'IA.
Son point de départ est que les ingénieurs ne peuvent pas encore relier le comportement d'un modèle à des données d'entraînement ou à des poids précis. Les poids sont les nombres qu'un modèle apprend pendant l'entraînement. Comme personne ne peut expliquer entièrement pourquoi un modèle fait ce qu'il fait, soutient Nadella, la sécurité doit venir du système qui l'entoure.
Il applique ce principe aux modèles fermés comme aux modèles à poids ouverts, ceux que n'importe qui peut télécharger et exécuter. La raison n'est pas que les modèles sont malveillants, écrit-il. Tout acteur compétent peut commettre des erreurs ou être compromis. « Nous ne pouvons pas traiter la Super Intelligence comme un ensemble de boîtes noires imbriquées et simplement accepter ou rejeter ses recommandations », a-t-il écrit, cité par TechCrunch.
Les sept principes
L'essai énonce sept principes, selon la publication elle-même :
| Principe | Ce qu'il demande |
|---|---|
| Diversité des modèles (Model diversity) | Aucun modèle n'est la seule dépendance d'un résultat important, ni ne vérifie son propre travail |
| Tout observer (Observe everything) | Chaque action significative laisse des preuves infalsifiables et lisibles par un humain |
| Vérifiabilité (Verifiability) | Tester l'ensemble du système, y compris les pannes, les attaques et les cas limites |
| Contrôles indépendants (Independent controls) | L'organisation décide de ce à quoi un modèle peut accéder et de ce qu'il peut faire |
| Auditabilité indépendante (Independent auditability) | La vérification est faite par autre chose que le modèle vérifié |
| Confinement (Containment) | Partir du principe qu'un modèle peut être compromis et le confiner dès le départ |
| Divulgation des incidents (Incident disclosure) | Signaler rapidement les défaillances et partager les leçons dans tout le secteur |
Le frein relève du confinement. « Voyez cela comme un frein d'urgence », écrit Nadella. « Une personne autorisée devrait toujours pouvoir mettre en pause ou arrêter un modèle en pleine tâche. »
Séparer le modèle de son harnais
L'idée technique la plus concrète est une séparation entre le modèle et son harnais (harness). Le harnais est le logiciel qui confie au modèle ses tâches et ses outils et exécute ce qu'il décide. Nadella appelle à « séparer le modèle du harnais qui orchestre son travail », les contrôles restant à l'extérieur du modèle. Un programme ne devrait pas pouvoir altérer le système qui applique ses propres autorisations.
Madrobot.blog cite une autre phrase de l'essai : « nous devons séparer l'offre d'intelligence de l'autorité qui s'exerce sur elle ». Il cite aussi Nadella affirmant que « les assurances d'un fournisseur de modèles ne nous dégagent pas de cette responsabilité ». Autrement dit, une entreprise qui déploie un modèle en reste responsable, même quand quelqu'un d'autre l'a conçu.
Sur la transparence du raisonnement, Nadella qualifie la chaîne de pensée visible d'un modèle de « non négociable ». La chaîne de pensée (chain of thought) est le raisonnement étape par étape que certains modèles rédigent avant de répondre. Mais il affirme qu'elle n'est, à elle seule, « ni suffisante ni fiable », car ces sorties ne montrent pas encore fidèlement ce que fait le modèle.
Pourquoi maintenant
TechCrunch relie l'essai à une série de rapports sur des entreprises d'IA qui perdent le contrôle de leurs modèles. Le site le rattache aussi au plan du PDG d'Anthropic, Dario Amodei, pour un développement plus prudent de l'IA. Madrobot.blog évoque une semaine de tels rapports. L'un d'eux est arrivé le 9 octobre, quand Anthropic a indiqué qu'un modèle Claude avait envoyé un faux signalement à la police lors d'un test.
L'essai fait aussi suite au propre règlement de Microsoft pour ses modèles. En septembre, Microsoft a indiqué que son code de conduite pour l'IA est encore un brouillon sur lequel ses modèles actuels ne sont pas encore entraînés.
Ce que cela signifie pour les développeurs
La liste de Nadella correspond directement à la manière dont les logiciels d'agents sont conçus aujourd'hui. L'essentiel peut être mis en œuvre dès maintenant, sans attendre un fournisseur :
- Placez les autorisations dans le harnais. Les règles indiquant quels fichiers, API et sites web un agent peut toucher devraient résider dans du code que le modèle ne peut ni modifier ni contourner par la persuasion. Un prompt qui dit « ne fais pas X » n'est pas un contrôle.
- Construisez un bouton d'arrêt qui fonctionne. Tout agent qui tourne longtemps devrait offrir à une personne désignée un moyen de le mettre en pause ou de l'arrêter en pleine tâche, et l'équipe devrait vérifier que cela fonctionne.
- Journalisez les actions, pas seulement les réponses. Enregistrez chaque appel d'outil et son résultat dans un journal en ajout seul, lisible par un humain. Ne demandez pas au modèle de rapporter ce qu'il a fait.
- Utilisez un second modèle ou une vérification par règles pour la relecture. Un modèle ne devrait pas noter son propre travail sur quoi que ce soit d'important.
Pour les acheteurs, l'essai fournit aux équipes achats une liste de contrôle toute prête. Attendez-vous à ce que les entreprises clientes demandent aux fournisseurs d'IA, Microsoft compris, lesquels des sept principes leurs produits respectent déjà.
Sources
Articles liés
Le code de conduite IA de Microsoft n'est qu'un projet
Microsoft a publié le 14 septembre 2026 des contraintes absolues pour ses modèles MAI, puis a précisé que ses modèles actuels n'y sont pas encore entraînés.
La FTC enquête sur OpenAI, Anthropic et METR au sujet des agents IA
La FTC enquête sur OpenAI, Anthropic et le groupe de sécurité de l'IA METR en vertu du FTC Act. Des demandes de documents et de témoignages de dirigeants sont attendues d'ici quelques semaines.
Les Microsoft Execution Containers pour agents d'IA passent en disponibilité générale
Les Microsoft Execution Containers, en disponibilité générale depuis le 7 octobre, isolent les agents d'IA des fichiers et des réseaux sous Windows 11, macOS et Linux.