Linux 7.4 deixa o flush de workqueues ociosas até 100 vezes mais rápido
O Linux 7.4 incorpora uma correção de workqueues: num servidor de 192 CPUs, os flushes ociosos subiram de 40 mil para 4,2 milhões por segundo. Flushes cheios podem ficar 15-20% mais lentos.
3 min de leitura
Em números
- spent per XFS flush on a 128-CPU machine before the fix
- 64us
- idle flushes a second on a 192-CPU server, up from 40,000
- 4.2M
- slowdown for busy flushes on unbound workqueues
- 15-20%
O Linux 7.4 incorporou uma mudança nas workqueues que deixa o flush de uma workqueue ociosa de 10 a 100 vezes mais rápido em máquinas grandes, informou o Phoronix em 22 de outubro de 2026. A correção do desenvolvedor do kernel Tejun Heo mira servidores com muitos núcleos, como sistemas Intel Xeon e AMD EPYC. Nessas máquinas, uma operação rotineira do sistema de arquivos perdia tempo verificando cada CPU, mesmo quando nada estava esperando.
O que é o flush de uma workqueue
Uma workqueue é o jeito de o kernel passar pequenas tarefas para threads de trabalho em segundo plano, em vez de executá-las na hora. Drivers e sistemas de arquivos a usam o tempo todo. Fazer o flush de uma workqueue significa esperar até que cada tarefa já enfileirada termine.
Cada workqueue se liga às suas threads de trabalho por meio de pool workqueues, ou pwqs. Uma pwq é o elo entre uma workqueue e um grupo de threads de trabalho. Num servidor grande, pode haver uma pwq para cada CPU possível.
O problema vem de um commit anterior do kernel, "workqueue: Make unbound workqueues to use per-cpu pool_workqueues". Desde essa mudança, um flush "percorre uma pwq por CPU possível, pegando um a um cada bloqueio de pool", segundo a carta de apresentação da série de patches. Ele faz isso mesmo quando a workqueue está ociosa. Mais núcleos significavam mais trabalho desperdiçado a cada flush.
Quem encontrou e onde doía
Yao Kai, engenheiro da Huawei, relatou o custo extra no início de setembro, segundo o Phoronix. O ponto fraco era o XFS, um sistema de arquivos Linux muito usado. O XFS faz o flush de uma de suas workqueues, a workqueue CIL, a cada log force. É o momento em que ele precisa gravar seu diário no disco.
Numa máquina de 128 CPUs, esse flush levava até 64 microssegundos a cada vez, segundo o relato. Um microssegundo é um milionésimo de segundo, então 64 parece pouco. Mas um sistema de arquivos ocupado força o log com muita frequência, e o custo se acumulava.
A correção registra quais pwqs foram de fato usadas desde o último flush, em listas por nó. Um nó é um grupo de CPUs com memória local própria. Agora um flush visita apenas essas pwqs ativas. A série tem dois patches, "workqueue: Maintain pwq->total_in_flight" e "workqueue: Make flush_workqueue() visit only pwqs active since the last flush".
Os números dos testes
A série de patches relata seus resultados numa máquina de 192 CPUs com dois nós. Workqueues per-cpu executam tarefas numa CPU escolhida; as unbound deixam o escalonador escolher qualquer CPU.
| Teste num servidor de 192 CPUs e 2 nós | Antes | Depois |
|---|---|---|
| Flush de uma workqueue per-cpu ociosa | 40 mil por segundo | 4,2 milhões por segundo |
| Flush de uma workqueue unbound ociosa | 450 mil | 4,3 milhões |
| 16 threads enfileirando e fazendo flush, per-cpu | 30 mil flushes por segundo | 110 mil flushes por segundo |
| 16 threads enfileirando e fazendo flush, unbound | 60 mil flushes por segundo | 180 mil flushes por segundo |
A contrapartida é dita com clareza. "Flushes densos com todas as pwqs ativas não mudam nas workqueues per-cpu e ficam 15-20% mais lentos nas unbound", escreveu Heo em sua mensagem de commit, citada pelo Phoronix. Enfileirar trabalho novo não é afetado.
A correção já circula além do ramo principal. Em 9 de setembro, Yao Kai publicou um backport dos dois patches na lista de discussão do kernel do openEuler. Ele se destina ao kernel do openEuler baseado na versão 6.6.
O Linux 7.4 também reúne outros ganhos de velocidade nesta janela de merge, como um patch que abre arquivos 39% mais rápido em testes e o Dynamic PAMT do Intel TDX, que economiza RAM em servidores.
O que isso significa para desenvolvedores
A maioria das pessoas nunca vai chamar diretamente um flush de workqueue. Elas vão sentir a mudança pelo sistema de arquivos e pelos drivers de servidores grandes.
- Meça de novo o XFS em máquinas com muitos núcleos. Se você usa XFS em servidores com 100 CPUs ou mais, compare cargas que gravam muito no log no Linux 7.4 e no seu kernel atual. Cargas que sincronizam com o disco com frequência são o lugar para olhar.
- Verifique o custo dos flushes cheios. Código que faz flush de workqueues unbound enquanto todas as pwqs estão ocupadas pode ficar 15-20% mais lento. Desenvolvedores do kernel com caminhos críticos assim devem medi-los antes e depois.
- Não espere ganhos em máquinas pequenas. A economia vem de pular pwqs ociosas. Um notebook com poucos núcleos tinha pouco a pular.
- Acompanhe o kernel da sua distribuição. O openEuler já está fazendo o backport da série para o seu kernel 6.6. Outras distribuições corporativas podem seguir, então confira os changelogs delas se você não puder migrar para o 7.4.
Fontes
- Linux 7.4 Workqueue Changes Bring A "10 To 100 Times Faster" Optimization - Phoronix
- [PATCH OLK-6.6 0/2] workqueue: Make flush_workqueue() cost scale with active pwqs - openEuler kernel mailing list
Artigos relacionados
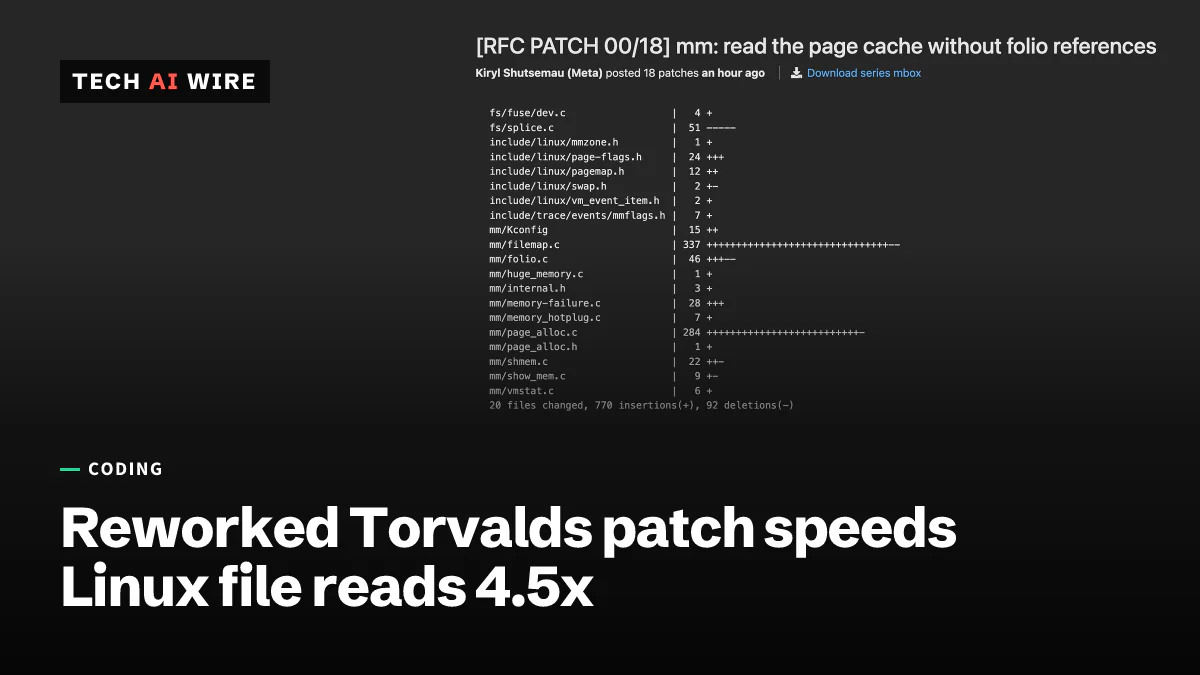
Patch de Torvalds para o cache de páginas é refeito: 4,5 vezes mais rápido no ext4
Kiryl Shutsemau, da Meta, transformou o patch de cache de páginas de Torvalds em um RFC de 18 patches. Com 64 threads no ext4, as leituras pequenas passaram de cerca de 15 para 70 milhões por segundo.
RFC do BeamFS: um sistema de arquivos com Reed-Solomon para o Linux
O BeamFS, uma RFC de 18 patches para o Linux, grava cada bloco como palavras de código Reed-Solomon para reparar bits invertidos em um único disco, ao custo de 7% do espaço.
Linux 7.3 é lançado com fchroot, failfs e Btrfs mais rápido
Linus Torvalds lançou o Linux 7.3 em 18 de outubro de 2026: 18.765 commits de 3.021 desenvolvedores, novas ferramentas de sandboxing e fsync do Btrfs até 5 vezes mais rápido.