GPT-6 Astra est en disponibilité générale sur Bedrock et dans Copilot
GPT-6 Astra est en disponibilité générale sur Amazon Bedrock à 10 dollars par million de tokens d'entrée, et dans GitHub Copilot pour les forfaits Pro+, Max, Business et Enterprise.
3 min de lecture

En chiffres
- standard price per million input / output tokens, short context
- $10 / $50
- per million cached input tokens, short context
- $1
- input tokens of context on Amazon Bedrock
- 1M
Le GPT-6 Astra d'OpenAI est désormais en disponibilité générale en dehors des propres produits d'OpenAI. GitHub l'a passé en disponibilité générale dans Copilot le 4 septembre 2026, et AWS l'a passé en disponibilité générale sur Amazon Bedrock le 8 septembre 2026. Sur Bedrock, il accepte une fenêtre de contexte allant jusqu'à 1 million de tokens d'entrée.
Pour les développeurs, le chiffre qui compte est la facture, et la tarification d'OpenAI est plus compliquée qu'un tarif unique.
Ce que cela coûte
La documentation tarifaire d'OpenAI découpe GPT-6 Astra de deux façons à la fois. Les prix changent avec la longueur de votre contexte, puis à nouveau selon que vous choisissez le mode Standard ou le mode Fast. Tous les chiffres sont par million de tokens.
| Mode et contexte | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Standard, contexte court | $10.00 | $1.00 | $50.00 |
| Standard, contexte long | $20.00 | $2.00 | $75.00 |
| Mode Fast, contexte court | $20.00 | - | $100.00 |
| Mode Fast, contexte long | $40.00 | - | $150.00 |
Deux détails sont faciles à manquer et coûteux à découvrir tard.
Le mode Fast double le prix d'entrée et double le prix de sortie par rapport au Standard. Il n'est pas non plus disponible partout : la documentation d'OpenAI indique que « le mode Fast est indisponible pour GPT-6 Astra avec résidence des données dans l'UE. Utilisez le traitement Standard pour ces requêtes. »
Par ailleurs, les modèles publiés après le 5 mars 2026 subissent une hausse de coût de 10 % lorsqu'ils sont appelés via des points de terminaison régionaux. GPT-6 Astra se trouve dans cette fenêtre, donc un déploiement régional coûte plus cher que le tableau ci-dessus.
C'est l'entrée en cache qui concentre les vraies économies. À 1,00 dollar contre 10,00 dollars, une lecture servie depuis le cache en contexte court coûte un dixième d'une lecture fraîche. Ce schéma est désormais la norme chez les fournisseurs de pointe, et Anthropic a actionné le même levier quand Claude Fable 5.1 a réduit de 75 % le prix des lectures de cache tout en maintenant les prix des tokens inchangés.
Où l'obtenir
| Plateforme | Détails |
|---|---|
| Amazon Bedrock | Disponibilité générale le 8 septembre 2026. Jusqu'à 1M de tokens d'entrée. ChatGPT Work et Codex peuvent être configurés pour l'utiliser ici |
| GitHub Copilot | Disponibilité générale le 4 septembre 2026, via le sélecteur de modèles |
| Forfaits Copilot | Pro+, Max, Business et Enterprise |
| Surfaces Copilot | VS Code, Visual Studio, Copilot CLI, l'agent de codage, l'application Copilot, github.com, GitHub Mobile, les IDE JetBrains, Xcode et Eclipse |
GitHub décrit le déploiement dans Copilot comme progressif, le modèle peut donc ne pas apparaître dans votre sélecteur dès le premier jour. Les administrateurs Business et Enterprise contrôlent l'accès via des politiques de modèles, ce qui signifie qu'un développeur sur un forfait d'entreprise attend peut-être un administrateur plutôt que GitHub.
GitHub précise aussi que l'utilisation dans Copilot est facturée comme une « facturation à l'usage au tarif public du fournisseur OpenAI ». Les tarifs du tableau ci-dessus sont ceux que vous payez là, pas un barème Copilot distinct.
AWS renvoie à la documentation Bedrock pour la disponibilité par région plutôt que de lister les régions dans l'annonce, et aucune des deux annonces ne précise de limites de débit.
Ce que cela signifie pour les développeurs
Chiffrez votre propre charge de travail avant de changer quoi que ce soit. La division en quatre entre longueur de contexte et mode signifie qu'un seul tarif d'affiche vous en dit très peu. En sortie, un appel en mode Fast avec contexte long coûte trois fois le tarif Standard en contexte court.
Vérifiez si vous êtes réellement en contexte court. La documentation d'OpenAI tarifie différemment le contexte court et le contexte long, mais les annonces ne disent pas où se situe la frontière. Si vos prompts flottent près d'un seuil que vous ne pouvez pas voir, votre coût par appel peut changer sans que votre code change. Cela vaut la peine de le mesurer sur du trafic réel avant d'engager un budget.
Si vous êtes dans l'UE, prévoyez de vous passer du mode Fast plutôt que de compter sur lui. La résidence des données dans l'UE l'exclut entièrement, et un point de terminaison régional ajoute 10 % par-dessus. Une architecture qui suppose le mode Fast ne survivra pas à un examen de conformité exigeant la résidence des données.
Le conseil sur le cache est le moins spectaculaire et le plus précieux. Structurez vos prompts pour que la partie stable vienne en premier et reste identique à l'octet entre les appels, car c'est ce qui rend possible une lecture depuis le cache. À un dixième du prix d'entrée, bien faire cela vaut plus que la plupart des choix de modèle.
Une réserve sur les capacités. Les résultats de benchmark publiés pour Astra ont fortement varié selon la façon de le tester, y compris un écart de 37 points sur ARC-AGI-3 qui tenait au harnais de test. La disponibilité générale change ce que vous pouvez acheter, pas ce qu'il sait faire. Menez votre propre évaluation sur vos propres tâches avant de basculer du trafic de production.
Sources
- OpenAI GPT-6 Astra is now generally available on Amazon Bedrock - AWS
- GPT-6 Astra is generally available in GitHub Copilot - GitHub Changelog
- OpenAI API pricing - OpenAI
Articles liés

Jev, de TypeSafe, renvoie des décisions typées, pas du texte
Jev répond en 70 à 500 millisecondes et coûte 0,042 dollar par million de tokens d'entrée, sortie gratuite. Il ne sait pas produire de texte du tout.
DeepSeek prévient les développeurs d'une hausse significative des prix de son API
DeepSeek a prévenu les développeurs le 6 août que les prix de son API allaient bientôt augmenter « significativement », sans chiffres ni dates - alors que V4-Flash est le modèle connu le moins cher à exploiter.
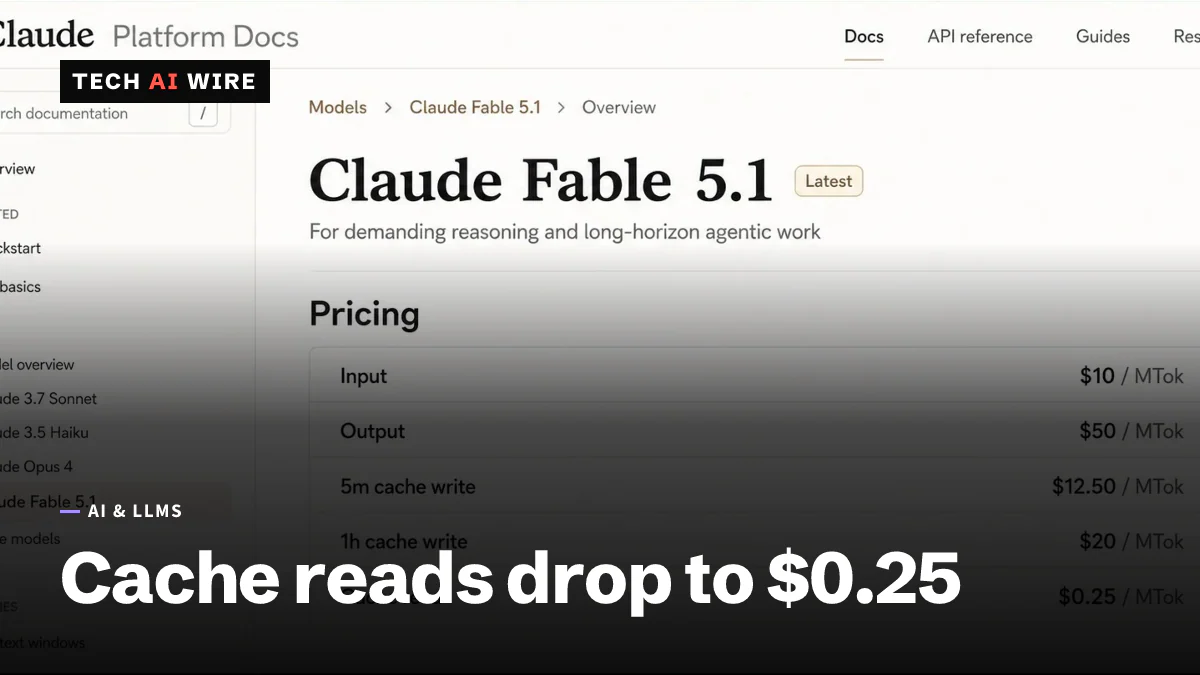
Claude Fable 5.1 réduit de 75% le coût des lectures de cache
Fable 5.1 maintient l'entrée et la sortie à 10 et 50 dollars par million de jetons, et fait passer la lecture de cache de 1,00 à 0,25 dollar. Mythos 5.1 reste sur invitation.