Le modèle Clairic de Cloudflare renvoie des valeurs typées, pas du texte
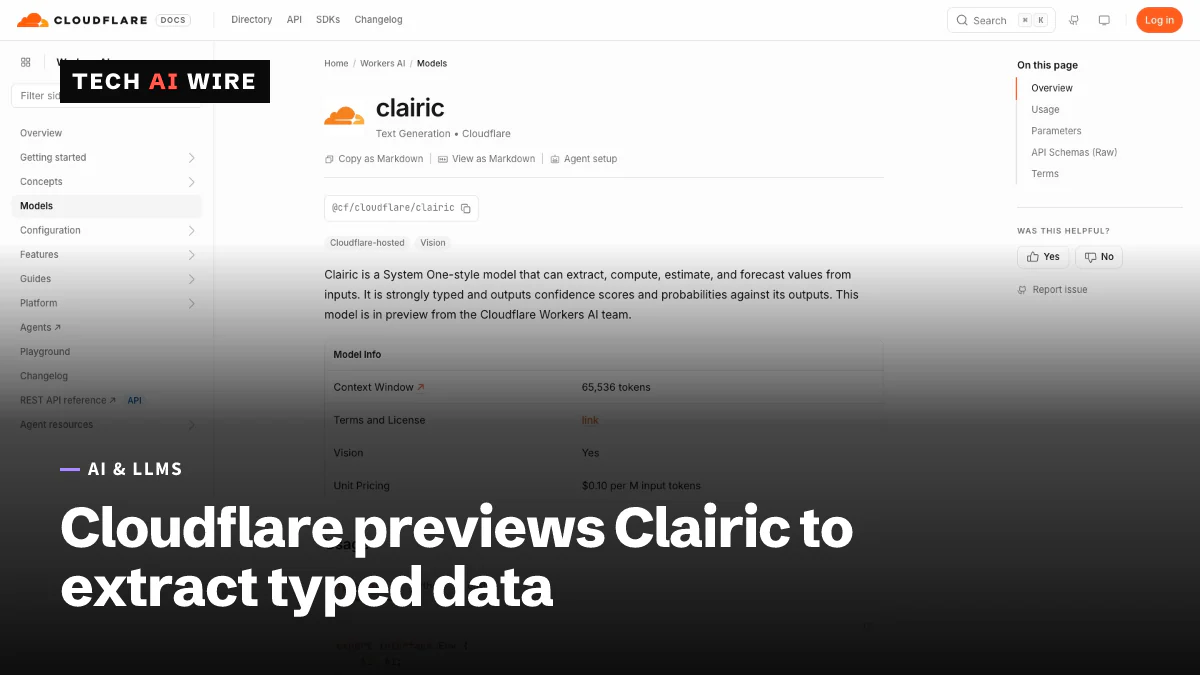
Dans le propre test de Cloudflare sur des sinistres, un pipeline mené par son nouveau modèle Clairic a tourné en 19,3 secondes au lieu de 61,7 et a coûté 49 % de moins qu'un LLM seul.
4 min de lecture
- Clairic + Clef + GLM-5.3
- 19.3s
- GLM-5.3 for every step
- 61.7s
Cloudflare a publié le 19 octobre 2026 une préversion de Clairic, un modèle qui extrait des valeurs exactes d'e-mails, de documents et de photos. Contrairement à un chatbot, il renvoie des données typées, comme un nombre ou une date, et non du texte rédigé. Dans le propre test de Cloudflare, un pipeline qui l'utilisait en premier a terminé plus de trois fois plus vite et a coûté 49 % de moins.
Ce que fait Clairic
L'annonce de Cloudflare présente Clairic comme le premier d'un nouveau type de modèle, que l'entreprise appelle "modèles d'extraction". On lui envoie du texte, plus jusqu'à quatre images, et une liste des champs voulus. Il renvoie chaque champ sous forme de valeur du type demandé.
Les types couvrent le texte, les nombres, les dates et heures, les durées, les listes, les estimations et les prévisions. Quand la réponse ne figure pas dans l'entrée, le modèle renvoie null, c'est-à-dire une valeur vide. Chaque réponse s'accompagne aussi d'un score de confiance.
Clairic tourne sur Workers AI, le service de Cloudflare qui exécute des modèles d'IA sur son propre réseau. Les développeurs l'appellent sous le nom @cf/cloudflare/clairic depuis un Worker, le code serverless de Cloudflare, ou via une API REST.
Pourquoi l'absence de tokens de sortie compte
La plupart des modèles de langage écrivent leur réponse un token à la fois. Un token est un petit morceau de texte, et les tokens de sortie sont en général la partie chère de la facture. Clairic saute cette étape. "Il n'y a ni raisonnement ni tokens de sortie", écrit Cloudflare, et la sortie n'est pas facturée.
Cette conception a une contrepartie. "L'architecture rend chaque réponse bien formée, pas forcément correcte", indique le billet. Une valeur aura toujours le bon type, mais elle peut quand même être fausse.
Les estimations sont fournies avec une fourchette, pas avec un seul nombre. Clairic donne une valeur centrale et un intervalle à 80 %, la fourchette dans laquelle la vraie valeur devrait tomber quatre fois sur cinq.
Le test de Cloudflare
Cloudflare a testé un processus de déclaration de sinistre pour des marchandises endommagées. Un pipeline utilisait Clairic pour extraire les faits, puis Clef pour prendre la décision, puis le modèle de langage GLM-5.3 pour rédiger la réponse. Clef est le modèle de décision que Cloudflare a publié plus tôt ce mois-ci. L'autre pipeline utilisait GLM-5.3 à chaque étape.
| Mesure | Clairic + Clef + GLM-5.3 | GLM-5.3 à chaque étape |
|---|---|---|
| Durée de bout en bout | 19,3 secondes | 61,7 secondes |
| Étape d'extraction des faits | 0,46 seconde (Clairic) | 16,1 secondes |
| Étape de décision | 0,22 seconde (Clef) | 21,9 secondes |
| Coût par million de sinistres | 6 032 dollars | 11 740 dollars |
Les deux pipelines ont obtenu les bons faits et la bonne décision à chaque exécution, selon Cloudflare. Dans un test distinct, Clairic a prévu pendant 21 jours le nombre quotidien de passagers aux contrôles de sécurité des aéroports américains. Ses prévisions s'écartaient en moyenne de 3,3 %, et 17 des 21 chiffres réels sont tombés dans sa fourchette à 80 %.
PPC Land a vérifié les calculs et a trouvé un écart. Les durées des étapes de l'exécution tout-LLM s'additionnent à 60,4 secondes, et non 61,7. Le site calcule aussi que les tokens de sortie représentent environ 97 % du coût de la cascade.
Limites et questions ouvertes
Cloudflare parle franchement des points faibles. "La lecture est solide, mais l'arithmétique en plusieurs étapes ne l'est pas encore", indique le billet. Les fourchettes du modèle peuvent être trop étroites sur des données inhabituelles. Ses prévisions restent basiques et ne remplacent pas les outils dédiés aux séries temporelles. Cloudflare qualifie la version actuelle de "premier checkpoint".
Cloudflare dit qu'elle publiera les poids du modèle "bientôt", mais ne donne ni date ni licence. Le prix est plus clair. La page du modèle de Cloudflare sur Workers AI indique 0,10 dollar par million de tokens d'entrée, le chiffre que rapporte aussi RuntimeWire. La même page indique une fenêtre de contexte de 65 536 tokens, soit le maximum de texte qu'une requête peut contenir. PPC Land, qui ne s'appuyait que sur le billet de blog, avait écrit qu'aucun prix par token n'était publié.
Ce que cela change pour les développeurs
Clairic plaide pour une répartition du travail d'IA par tâche : un modèle peu cher et rapide lit, et un grand modèle ne fait qu'écrire. Si votre application paie surtout des tokens de sortie, cette répartition vaut la peine d'être testée.
- Placez-le en amont, pas à la place. Utilisez Clairic pour extraire des champs d'e-mails ou de reçus, puis n'envoyez que les cas difficiles à un modèle de langage complet.
- Exploitez les valeurs null et de confiance. Fixez un seuil en dessous duquel une personne ou un modèle plus grand vérifie le résultat. Une réponse bien formée n'est pas une réponse correcte.
- Tenez les calculs à l'écart. Demandez les valeurs brutes et faites les sommes dans votre propre code, car l'arithmétique en plusieurs étapes est une faiblesse connue.
- Testez sur vos propres documents. Tous les chiffres ci-dessus viennent des tests de Cloudflare. Faites passer quelques centaines de vos vraies entrées avant de vous fier à la vitesse ou à la précision.
- Budgétez selon la taille des entrées. À 0,10 dollar par million de tokens d'entrée et sans frais de sortie, la facture suit la quantité envoyée. Raccourcissez les longs fils d'e-mails avant de les envoyer.
Sources
- Introducing Clairic, a new System One class of extraction models - Cloudflare Blog
- Cloudflare's Clairic model cuts AI pipeline cost 49% in its own test - PPC Land
- Cloudflare gives structured data tasks their own AI model with Clairic - RuntimeWire
- clairic - Workers AI models - Cloudflare Docs
Articles liés
Inception Mercury 3 : le LLM à diffusion revendique 1 068 tokens par seconde
Le LLM à diffusion Mercury 3 d'Inception revendique 1 068 tokens par seconde, un contexte d'un million de tokens et un prix de 0,20 $/0,70 $ par million de tokens, réduit de moitié au lancement.
Jev, de TypeSafe, renvoie des décisions typées, pas du texte
Jev répond en 70 à 500 millisecondes et coûte 0,042 dollar par million de tokens d'entrée, sortie gratuite. Il ne sait pas produire de texte du tout.
DeepSeek prévient les développeurs d'une hausse significative des prix de son API
DeepSeek a prévenu les développeurs le 6 août que les prix de son API allaient bientôt augmenter « significativement », sans chiffres ni dates - alors que V4-Flash est le modèle connu le moins cher à exploiter.