La beta de TorchNeuron lleva PyTorch nativo a AWS Trainium
El 89 % de los 100 principales modelos de generación de texto ya funciona en AWS Trainium sin cambios, frente al 46 %, con la entrada en beta pública del backend de PyTorch TorchNeuron.
3 min de lectura
En cifras
- of the top 100 text-generation models run out of the box
- 89%
- with the older Optimum Neuron v0.4.5 path
- 46%
- best-case speedup from a vision kernel
- 2.4x
TorchNeuron, una nueva forma de ejecutar código de PyTorch en los chips Trainium de Amazon, entró en beta pública el 20 de octubre de 2026. Importa porque la mayoría de los modelos abiertos populares ya funcionan en Trainium sin cambios. Según Hugging Face, el 89 % de las 100 arquitecturas de modelos de generación de texto más usadas funcionan directamente, frente al 46 % con las herramientas anteriores.
Qué es TorchNeuron
Trainium es el chip de IA que Amazon diseña y alquila a través de AWS, su negocio en la nube. PyTorch es la biblioteca más usada para crear y entrenar modelos de IA. Hasta ahora, el código de PyTorch llegaba a Trainium a través de una capa de traducción, y muchos modelos necesitaban trabajo extra para funcionar.
TorchNeuron es un plugin de PyTorch que añade Trainium como dispositivo nativo. La documentación de AWS dice que «registra Trainium como un dispositivo estándar de PyTorch». En la práctica, un desarrollador mueve un modelo al dispositivo llamado neuron, del mismo modo que lo movería a una GPU con cuda.
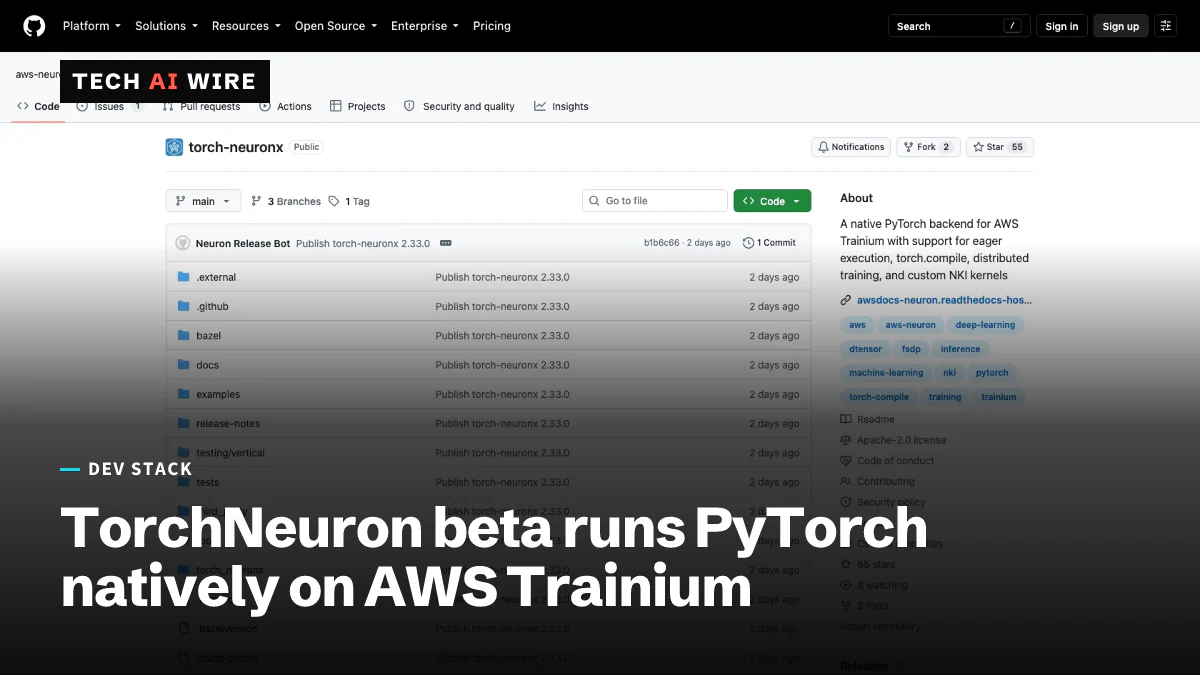
El proyecto es de código abierto con licencia Apache-2.0, según su página de GitHub. AWS lo incluye como beta pública en la versión Neuron 2.33, su kit de software para estos chips.
Qué cambia respecto al método anterior
La ruta anterior pasaba por Optimum Neuron, una biblioteca de Hugging Face, que dependía de PyTorch XLA. XLA es una capa de compilación que convierte un modelo en un grafo fijo antes de ejecutarlo. Ese enfoque hacía difícil dar soporte a muchos modelos, porque cada uno necesitaba su propia adaptación.
TorchNeuron elimina esa capa. Las propias bibliotecas de Hugging Face ya funcionan directamente en Trainium: Transformers para modelos de lenguaje, Diffusers para modelos de imagen, además de Accelerate, PEFT y TRL para entrenamiento y ajuste fino. La tabla siguiente resume las funciones, según la documentación de AWS y la publicación de Hugging Face.
| Función | Qué significa |
|---|---|
| Modo eager | El código se ejecuta línea por línea, como en PyTorch normal |
torch.compile | Compilación opcional para ganar velocidad, con el backend neuron |
| Entrenamiento distribuido | FSDP, DDP, DTensor, paralelismo de tensores y de pipeline |
| Kernels personalizados | Código escrito a mano para el chip mediante el lenguaje NKI de AWS |
| Chips | Trainium 2 y Trainium 3; FP8 y MXFP8 requieren Trainium 3 |
FSDP y DDP son formas estándar de PyTorch de repartir el entrenamiento entre muchos chips. FP8 es un formato numérico más pequeño que ahorra memoria y tiempo.
Modelos y velocidad
La publicación de Hugging Face muestra un ajuste fino de Qwen3-8B con TRL, repartido entre varios chips con paralelismo de tensores y FSDP. También ejecuta pipelines de imagen como FLUX.1-dev, FLUX.2 y Qwen-Image con paralelismo de tensores.
La documentación de AWS incluye modelos de mezcla de expertos (mixture-of-experts), que envían cada entrada a unas pocas subredes especializadas. DeepSeek, GPT-OSS y Qwen3 son compatibles. El entrenamiento de esos modelos pasa por una herramienta aparte, TorchTitan Neuron.
La única cifra de velocidad tiene un alcance limitado. Un kernel de vision transformer del equipo Neuron de AWS ofrece «una aceleración de hasta 2,4 veces en Trainium», según la publicación de Hugging Face. No dice frente a qué se mide.
Cómo instalarlo
La página de GitHub ofrece una instalación con versiones fijadas, que se ejecuta cuando el controlador y los paquetes de runtime de Neuron ya están instalados:
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
Las versiones fijadas importan. TorchNeuron se distribuye con el mismo nombre de paquete, torch-neuronx, que el producto anterior basado en XLA. Las versiones anteriores instalan el producto antiguo, advierte el repositorio. Ejecutar python -m torch_neuronx.collect_env confirma que el dispositivo se puede usar desde PyTorch. Las imágenes de máquina y los contenedores preparados de AWS ya lo traen instalado.
Qué significa esto para los desarrolladores
TorchNeuron convierte Trainium de un destino especial en un dispositivo más de PyTorch. Ese es el paso que hace prácticas las comparaciones de precio con las GPU para los equipos corrientes.
- Prueba primero tu propio modelo. Con un 89 % de cobertura, todavía queda aproximadamente una de cada diez arquitecturas populares que necesita trabajo. Ejecuta un trabajo corto de entrenamiento o inferencia antes de planificar una migración.
- Fija las versiones en cada entorno. Un
torch-neuronxsin versión fijada en un archivo de requisitos puede instalar el producto XLA antiguo. Revisa la salida decollect_enven la CI. - Comprueba la generación del chip. Solo se admiten instancias de Trainium 2 y 3. Si tu plan depende del entrenamiento en FP8, necesitas Trainium 3.
- Trátalo como una beta. Ninguna de las tres fuentes lo considera listo para producción. Mantén una alternativa en GPU para todo lo que tenga fecha límite.
- Compara el coste por trabajo, no por hora. La cifra de 2,4 veces se refiere a un solo kernel, sin una base de comparación indicada. Mide tus propios tokens por dólar antes de comprometer presupuesto.
Fuentes
- TorchNeuron: running HF models on AWS Trainium is easier than ever - Hugging Face
- TorchNeuron: native PyTorch backend overview - AWS Neuron documentation
- aws-neuron/torch-neuronx - GitHub
Artículos relacionados
TorchTPU: Google libera como código abierto un PyTorch nativo para TPU
TorchTPU ejecuta PyTorch de forma nativa en las TPU de Google y superó la prueba con el 98 % de los 4.917 modelos de Hugging Face probados. PyTorch/XLA queda obsoleto y se archivará el 15 de noviembre.
NVIDIA Run:ai pasa a ser de código abierto, con el reparto de GPU incluido
NVIDIA publicó el 13 de octubre toda su plataforma de orquestación de GPU Run:ai como código abierto, dividida en cuatro módulos que los equipos pueden adoptar de uno en uno.
Tenstorrent capta 1.500 M$ con una valoración de 6.200 M$ para escalar sus servidores Galaxy
La empresa de chips de IA de Jim Keller ha captado 1.500 millones de dólares con una valoración de 6.200 millones, más del doble que en 2024, para fabricar servidores Galaxy y licenciar diseños de chips.