TorchNeuron-Beta bringt natives PyTorch auf AWS Trainium
89 % der Top-100-Modelle für Textgenerierung laufen jetzt ohne Anpassung auf AWS Trainium, nach 46 % zuvor. Das PyTorch-Backend TorchNeuron ist in die öffentliche Beta gestartet.
3 Min. Lesezeit
Die Zahlen
- of the top 100 text-generation models run out of the box
- 89%
- with the older Optimum Neuron v0.4.5 path
- 46%
- best-case speedup from a vision kernel
- 2.4x
TorchNeuron, ein neuer Weg, PyTorch-Code auf Amazons Trainium-Chips auszuführen, ist am 20. Oktober 2026 in die öffentliche Beta gestartet. Das ist wichtig, weil die meisten populären offenen Modelle jetzt ohne Änderungen auf Trainium laufen. Laut Hugging Face funktionieren 89 % der 100 meistgenutzten Modellarchitekturen für Textgenerierung sofort, nach 46 % mit den älteren Werkzeugen.
Was TorchNeuron ist
Trainium ist der KI-Chip, den Amazon entwickelt und über sein Cloud-Geschäft AWS vermietet. PyTorch ist die am weitesten verbreitete Bibliothek zum Bauen und Trainieren von KI-Modellen. Bisher gelangte PyTorch-Code über eine Übersetzungsschicht auf Trainium, und viele Modelle brauchten zusätzliche Arbeit, um zu laufen.
TorchNeuron ist ein PyTorch-Plugin, das Trainium als natives Gerät hinzufügt. Laut der AWS-Dokumentation „registriert es Trainium als Standard-PyTorch-Gerät“. In der Praxis verschiebt ein Entwickler ein Modell auf das Gerät namens neuron, so wie er es mit cuda auf eine GPU verschieben würde.
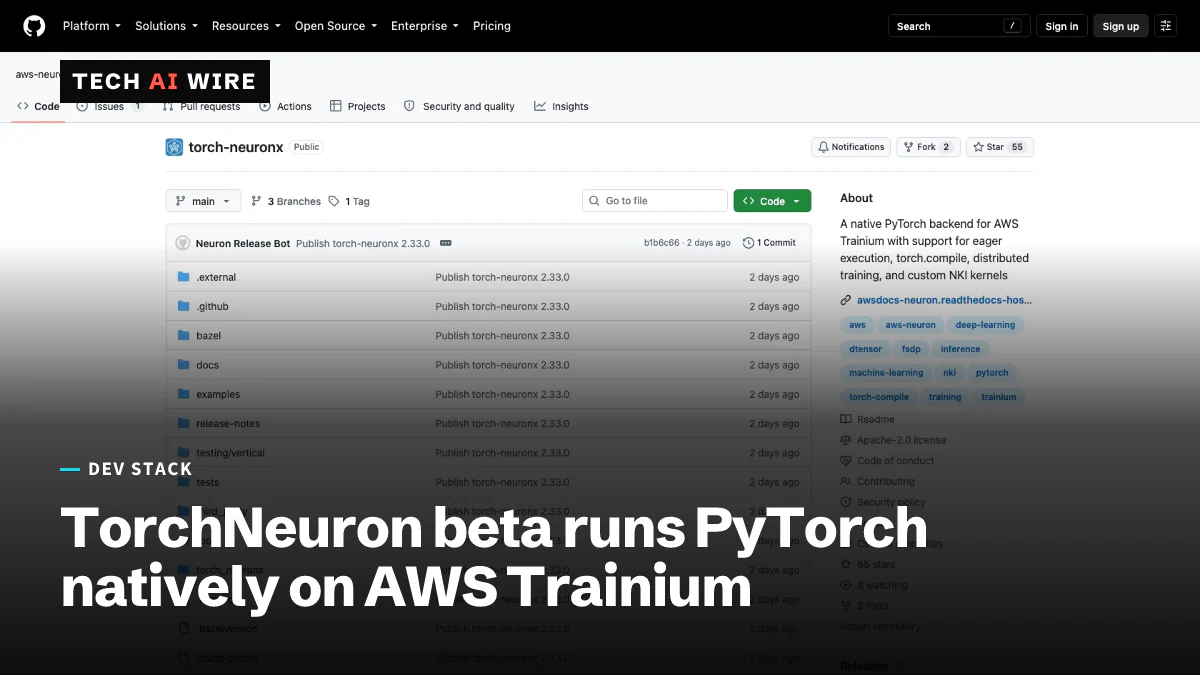
Das Projekt ist laut seiner GitHub-Seite Open Source unter der Apache-2.0-Lizenz. AWS führt es im Release Neuron 2.33, seinem Software-Kit für die Chips, als öffentliche Beta.
Was sich gegenüber dem alten Weg geändert hat
Der ältere Weg führte über Optimum Neuron, eine Bibliothek von Hugging Face, die auf PyTorch XLA aufbaute. XLA ist eine Compiler-Schicht, die ein Modell vor der Ausführung in einen festen Graphen umwandelt. Dieser Ansatz machte die Unterstützung vieler Modelle schwierig, weil jedes eine eigene Anpassung brauchte.
TorchNeuron lässt diese Schicht weg. Die eigenen Bibliotheken von Hugging Face laufen jetzt direkt auf Trainium: Transformers für Sprachmodelle, Diffusers für Bildmodelle sowie Accelerate, PEFT und TRL für Training und Fine-Tuning. Die Tabelle unten fasst die Funktionen zusammen, auf Basis der AWS-Dokumentation und des Beitrags von Hugging Face.
| Funktion | Was sie bedeutet |
|---|---|
| Eager Mode | Code läuft Zeile für Zeile, wie bei normalem PyTorch |
torch.compile | Optionales Kompilieren für mehr Tempo, mit dem Backend neuron |
| Verteiltes Training | FSDP, DDP, DTensor, Tensor- und Pipeline-Parallelität |
| Eigene Kernels | Handgeschriebener Chip-Code über die AWS-Sprache NKI |
| Chips | Trainium 2 und Trainium 3; FP8 und MXFP8 benötigen Trainium 3 |
FSDP und DDP sind Standardverfahren in PyTorch, um Training auf viele Chips zu verteilen. FP8 ist ein kleineres Zahlenformat, das Speicher und Zeit spart.
Modelle und Geschwindigkeit
Der Beitrag von Hugging Face zeigt einen Fine-Tuning-Lauf von Qwen3-8B mit TRL, verteilt auf mehrere Chips mit Tensor-Parallelität und FSDP. Er führt außerdem Bild-Pipelines wie FLUX.1-dev, FLUX.2 und Qwen-Image mit Tensor-Parallelität aus.
Die AWS-Dokumentation nennt Mixture-of-Experts-Modelle, die jede Eingabe an einige spezialisierte Teilnetze weiterleiten. DeepSeek, GPT-OSS und Qwen3 werden unterstützt. Das Training dieser Modelle läuft über ein separates Werkzeug, TorchTitan Neuron.
Die einzige Geschwindigkeitsangabe ist eng gefasst. Ein Vision-Transformer-Kernel des Neuron-Teams von AWS bringt „eine bis zu 2,4-fache Beschleunigung auf Trainium“, heißt es im Beitrag von Hugging Face. Wogegen das gemessen wurde, steht dort nicht.
So wird es installiert
Die GitHub-Seite nennt eine Installation mit festen Versionen, die ausgeführt wird, sobald Neuron-Treiber und Runtime-Pakete eingerichtet sind:
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
Die festen Versionen sind wichtig. TorchNeuron erscheint unter demselben Paketnamen, torch-neuronx, wie das ältere XLA-basierte Produkt. Frühere Versionen installieren das alte, warnt das Repository. Der Befehl python -m torch_neuronx.collect_env bestätigt, dass das Gerät aus PyTorch heraus nutzbar ist. Auf den fertigen Maschinen-Images und Containern von AWS ist es vorinstalliert.
Was das für Entwickler bedeutet
TorchNeuron macht Trainium von einem Sonderziel zu einem weiteren PyTorch-Gerät. Das ist der Schritt, der Preisvergleiche mit GPUs für normale Teams praktikabel macht.
- Testen Sie zuerst Ihr eigenes Modell. Bei 89 % Abdeckung braucht immer noch etwa eine von zehn populären Architekturen zusätzliche Arbeit. Führen Sie einen kurzen Trainings- oder Inferenzjob aus, bevor Sie einen Umstieg planen.
- Fixieren Sie Versionen in jeder Umgebung. Ein nicht fixiertes
torch-neuronxin einer Requirements-Datei kann das alte XLA-Produkt ziehen. Prüfen Sie die Ausgabe voncollect_envin der CI. - Prüfen Sie die Chip-Generation. Nur Instanzen mit Trainium 2 und 3 werden unterstützt. Wenn Ihr Plan von FP8-Training abhängt, brauchen Sie Trainium 3.
- Behandeln Sie es als Beta. Keine der drei Quellen bezeichnet es als produktionsreif. Halten Sie für alles mit Deadline eine Ausweichlösung auf GPUs bereit.
- Vergleichen Sie Kosten pro Job, nicht pro Stunde. Die Angabe von 2,4-fach gilt für einen einzelnen Kernel ohne genannte Vergleichsbasis. Messen Sie Ihre eigenen Tokens pro Dollar, bevor Sie Budget festlegen.
Quellen
- TorchNeuron: running HF models on AWS Trainium is easier than ever - Hugging Face
- TorchNeuron: native PyTorch backend overview - AWS Neuron documentation
- aws-neuron/torch-neuronx - GitHub
Ähnliche Artikel
TorchTPU: Google veröffentlicht natives PyTorch für TPUs als Open Source
TorchTPU führt PyTorch nativ auf Google-TPUs aus und bestand bei 98 % von 4.917 getesteten Hugging-Face-Modellen. PyTorch/XLA ist veraltet und wird am 15. November archiviert.
NVIDIA Run:ai wird Open Source, samt GPU-Sharing
NVIDIA hat die komplette GPU-Orchestrierungsplattform Run:ai am 13. Oktober als Open Source veröffentlicht, aufgeteilt in vier Module, die Teams einzeln einführen können.
Tenstorrent sammelt 1,5 Mrd. Dollar bei 6,2 Mrd. Dollar Bewertung für Galaxy-Server ein
Jim Kellers KI-Chipfirma hat 1,5 Milliarden Dollar bei einer Bewertung von 6,2 Milliarden Dollar eingesammelt, mehr als doppelt so viel wie 2024, um Galaxy-Server zu bauen und Chipdesigns zu lizenzieren.