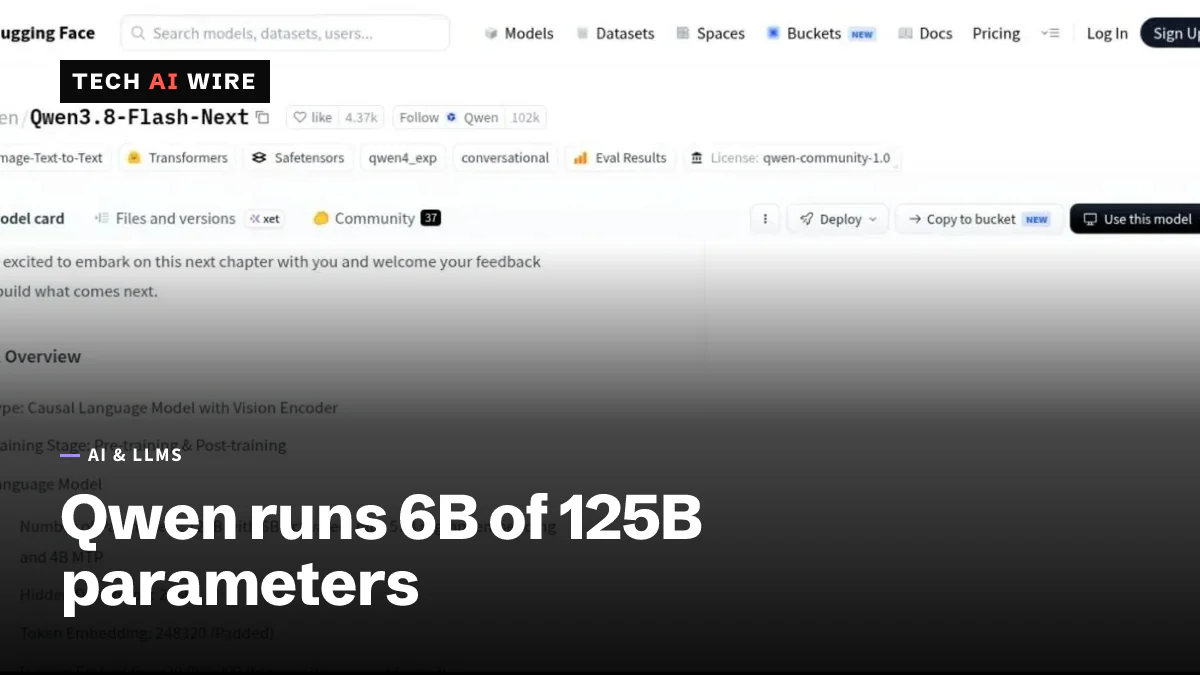
Qwen3.8-Flash-Next umfasst 125 Mrd. Parameter, nutzt aber nur 6 Mrd.
Alibaba veröffentlichte Qwen3.8-Flash-Next am 26. August 2026. Das Modell aktiviert 6 von 125 Milliarden Parametern pro Token und kostet 0,16 Dollar je Million Eingabe-Token.
3 Min. Lesezeit
Die Zahlen
- parameters active per token, out of 125B
- 6B
- per million input tokens on QwenCloud
- $0.16
- token context with YaRN extension
- 1M
Alibabas Qwen-Team veröffentlichte Qwen3.8-Flash-Next am 26. August 2026. Das Modell umfasst 125 Milliarden Parameter, nutzt für ein einzelnes Token aber nur 6 Milliarden davon. Dieses Verhältnis erklärt, warum es sich für 0,16 Dollar je Million Eingabe-Token anbieten lässt. Für Entwickler mit Blick auf die Inferenzkosten ist das der entscheidende Punkt.
Die Veröffentlichung ist eine Vorschau auf die Architektur hinter Qwen4, der nächsten Modellfamilie des Teams. Qwen legt die Konstruktionsänderungen offen, bevor die vollständige Reihe erscheint, damit die Community sie zuerst prüfen kann.
Warum das Modell günstig im Betrieb bleibt
Qwen3.8-Flash-Next ist ein Mixture-of-Experts-Modell. Das Netz ist in viele spezialisierte Abschnitte geteilt, und ein Router wählt für jedes Token eine kleine Auswahl aus. Die übrigen Gewichte bleiben untätig. Die Speicherrechnung ist also hoch, die Rechenlast dagegen gering.
Der vollständige Checkpoint ist größer, als die Schlagzeile vermuten lässt. MarkTechPost schlüsselt ihn auf in ein 125-Mrd.-Grundmodell, eine 51-Mrd.-N-Gramm-Embedding-Tabelle und ein 4-Mrd.-Modul zur Mehrfach-Token-Vorhersage, zusammen rund 180 Milliarden Parameter auf der Festplatte.
Vier Konstruktionsänderungen tragen die Veröffentlichung, laut dem Repository des Qwen-Teams:
| Änderung | Wirkung |
|---|---|
| Gated DeltaNet + Qwen Sparse Attention | Drei von vier Schichten nutzen Gated DeltaNet, die vierte Sparse Attention |
| Gated Residual | Verändert, wie Signale zwischen Schichten weitergegeben werden |
| N-Gram-Embedding | Eine Tabelle mit 20 Millionen Einträgen, die günstig Kapazität schafft |
| Muon-Optimizer | Ein überarbeiteter Trainings-Optimizer |
Das Kontextfenster umfasst nativ 262.144 Token. DataCamp und MarkTechPost berichten beide, es lasse sich mit YaRN auf etwa 1 Million Token dehnen. YaRN ist eine Technik, um ein Modell über seine trainierte Länge hinaus zu erweitern.
Qwen gibt außerdem an, das Training habe rund ein Neuntel des Vorgängers Qwen3.7-Plus gekostet. Diese Zahl stammt von Qwen, und keine unabhängige Stelle hat sie geprüft.
Was die Benchmarks zeigen und wer sie durchgeführt hat
Alle folgenden Werte stammen aus Alibabas eigenen Angaben. Kein unabhängiges Labor hat sie bestätigt.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max |
|---|---|---|
| SWE-bench Pro | 62,5 | 53,4 |
| LiveCodeBench v6 | 91,9 | nicht angegeben |
| AndroidWorld | 84,5 | nicht angegeben |
| MathVision | 95,7 | nicht angegeben |
| Reasoning | 35,9 | 40,0 |
Das Muster ist aufschlussreicher als jede Einzelzahl. Das Modell führt bei Programmier- und Agentenaufgaben und fällt beim anspruchsvollen Schlussfolgern zurück, wo MarkTechPost 35,9 gegenüber 40,0 verzeichnet. Qwens eigene Dokumentation nennt zudem Grenzen: Über lange Agentenketten wird das Modell brüchig, und bei wissensintensiven Prüfungen hinkt es hinterher.
Die Lizenz ist nicht das, was "offene Gewichte" sonst bedeutet
Die Gewichte lassen sich von Hugging Face und ModelScope laden. Der FP8-Checkpoint misst 172,78 GiB, die BF16-Fassung 335,28 GiB. Das ist ein Download für Serverklasse, nicht für einen Laptop.
Die Bedingungen verdienen genaues Lesen. MarkTechPost berichtet, die Veröffentlichung nutze die Lizenz qwen-community-1.0, die vor kommerzieller Nutzung eine Verifizierung verlangt. Das ist ein deutlicher Abstand zu Apache 2.0 oder MIT, wo man herunterlädt und ausliefert. "Offene Gewichte" heißt hier: prüfen und ausführen erlaubt, kommerziell einsetzen nicht ohne Rückfrage.
Was das für Entwickler bedeutet
Kalkulieren Sie mit den aktiven Parametern, nicht mit der Gesamtzahl. Ein 125-Mrd.-Modell, das 6 Mrd. je Token feuert, verhält sich bei Latenz und Kosten wie ein kleines Modell und beim Speicher wie ein großes. Für die Hardware-Auslegung gilt: Die Checkpoint-Größe bestimmt die Zahl der GPUs, die aktive Parameterzahl den Durchsatz.
Lesen Sie die Lizenz, bevor Sie darauf bauen. Prüfen Sie, ob der Verifizierungsschritt aus qwen-community-1.0 für Ihr Produkt gilt, und klären Sie das vor dem Schreiben des Integrationscodes, nicht danach. Nichts ist teurer, als das spät zu entdecken.
Nehmen Sie die Benchmark-Tabelle nicht für bare Münze. Herstellereigene Auswertungen wählen günstige Aufgaben. Ehrlich gelesen steht hier ein Modell, das beim Code stark und beim Schlussfolgern schwächer ist. Testen Sie es an Ihren eigenen Aufgaben, besonders an langen Agentenketten, wo Qwen die Brüchigkeit selbst einräumt.
Der strategische Punkt ist der Preisdruck. Bei 0,16 Dollar Eingabe und 0,47 Dollar Ausgabe je Million Token setzt diese Klasse offener MoE-Modelle eine Untergrenze, auf die gehostete Spitzenmodelle antworten müssen. Das nützt allen, die eine Inferenzrechnung zahlen, unabhängig davon, für welches Modell sie sich am Ende entscheiden.
Fortsetzung: Qwen3.8-Omni-Flash senkt Audio-Eingabekosten um 98 %.
Quellen
Ähnliche Artikel
Offene Gewichte von Reflection Beam erscheinen unter Apache 2.0
Reflection hat die Gewichte von Beam mit 501 Milliarden Parametern am 16. Oktober 2026 unter Apache 2.0 auf Hugging Face gestellt. Die FP8- und 4-Bit-Versionen passen auf einen Server mit 8 GPUs.
StepFun Step 5 Preview: 600B-Agentenmodell mit offenen Gewichten
Step 5 Preview von StepFun, ein Modell mit 600B Parametern, davon 27B aktiv, und 1M Token Kontext, ist auf Hugging Face. Zuvor gab es das Modell einen Monat nur per API, zu 1 $/2,70 $ pro Mio. Tokens.
Ling-3.1-flash: Ant Group öffnet 560B-Modell unter MIT-Lizenz
Ant Groups inclusionAI hat die Gewichte von Ling-3.1-flash unter der MIT-Lizenz veröffentlicht: 560B Parameter, davon 25B aktiv pro Token, und 1M Token Kontext.