A marca d'água de imagem do SynthID traz um campo de ID de 64 bits
Um artigo de pesquisa mostra que a marca d'água de imagem do SynthID traz um campo de ID de banco de dados de 64 bits, embora o Google diga que não rastreia usuários individuais.
3 min de leitura
Um ensaio publicado no brand.io em 21 de setembro de 2026 argumenta que os sistemas de marca d'água para conteúdo de IA deixaram de ser simples rótulos de "isto foi gerado por IA" e passaram a se parecer com uma infraestrutura de rastreamento. O autor chama o resultado de "spymark", em vez de marca d'água. A afirmação se apoia em um detalhe técnico específico do próprio artigo de pesquisa do Google DeepMind sobre o SynthID-Image: o payload da marca d'água de cada imagem tem 136 bits, e 64 desses bits são descritos como um ID de banco de dados, enquanto os outros 72 bits servem para correção de erros.
Marcar com marca d'água significa esconder discretamente informações dentro de um arquivo, como uma imagem, um trecho de áudio ou um bloco de texto, de um jeito que uma pessoa não percebe, mas que um detector correspondente consegue ler de volta. O SynthID, sistema de marca d'água do Google, está embutido em vários de seus produtos de geração de imagem e texto.
O que o artigo descreve versus o que o Google diz que faz
O artigo do SynthID-Image descreve um payload de 136 bits embutido em imagens de 512 por 512 pixels: 64 bits para um ID de banco de dados, mais 72 bits de correção de erros. O ensaio do brand.io chama isso de "sinais secretos ocultos, imperceptíveis aos humanos". Um campo de 64 bits é grande o suficiente para dar um número distinto a cada imagem que o SynthID já marcou. É esse tamanho que leva o ensaio a tratar o campo como evidência de que o sistema poderia identificar imagens individuais, não apenas sinalizar que uma imagem é gerada por IA.
A documentação pública do Google descreve algo mais restrito. Ela diz que o SynthID funciona usando "uma função pseudoaleatória para ajustar os logits do modelo" enquanto o conteúdo é gerado, aplicada "de um jeito que ajuda você a determinar se o texto foi gerado pelo seu modelo". Isso é um simples sinal de sim ou não, não um identificador ligado a uma pessoa ou a uma requisição específica. A documentação acrescenta que modelos que compartilham um mesmo tokenizador também compartilham uma mesma marca d'água e um mesmo detector, de modo que a mesma marca cobre toda a saída daquele modelo, em vez de haver uma única por usuário. O material do próprio Google não menciona nenhum campo de ID de banco de dados.
O ensaio é cuidadoso quanto a essa lacuna. Ele apresenta o campo de 64 bits como uma capacidade técnica documentada no artigo de pesquisa, não como prova de que o Google ou qualquer outra empresa o use hoje para rastrear pessoas específicas. Diz não ter encontrado evidências públicas de que isso aconteça.
Outros sistemas que o ensaio cita
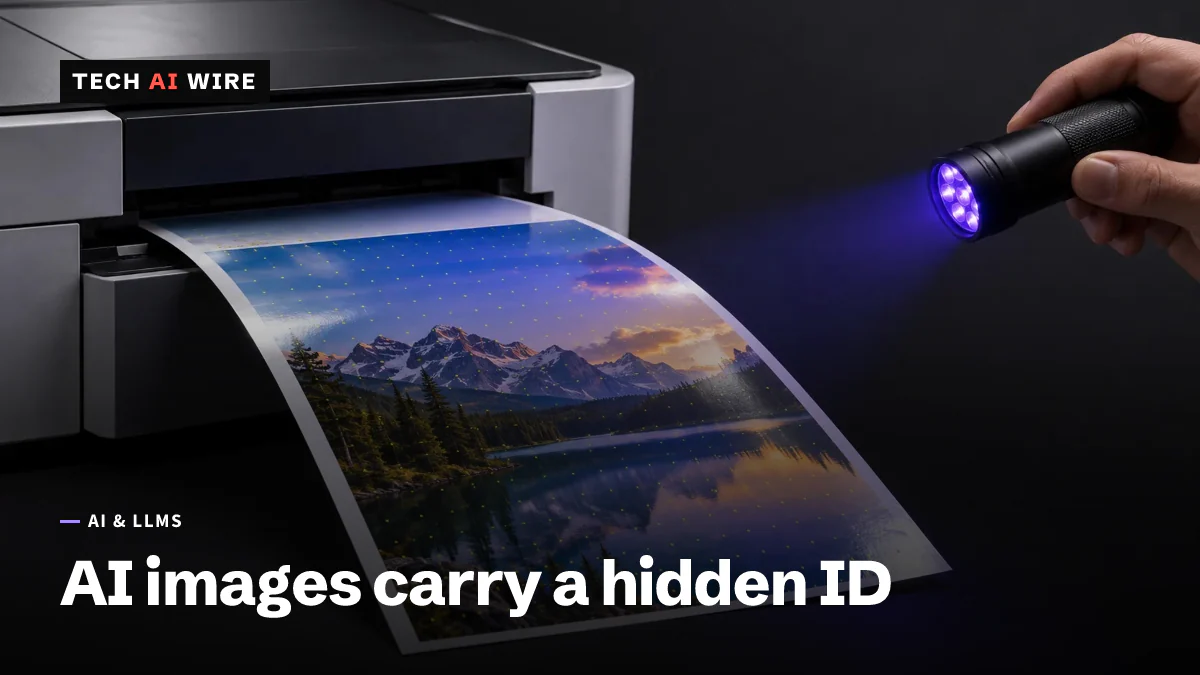
O ensaio aplica o mesmo argumento a texto e áudio. Diz que a versão em texto do SynthID direciona a escolha de palavras durante a geração para criar "um padrão estatístico detectável" ligado ao modelo, e que a OpenAI construiu um sinal de procedência semelhante para suas próprias saídas de imagem e vídeo. Para áudio, ele cita o Audiowerk, uma ferramenta de marca d'água de código aberto de 2018 que, segundo o ensaio, consegue "esconder payloads de 128 bits em áudio e protegê-los com uma chave AES secreta". Ele também compara a ideia aos pontos de rastreamento de impressoras, o padrão quase invisível que muitas impressoras a laser coloridas vêm estampando em páginas desde os anos 1980, codificando o número de série da impressora junto com a data e a hora da impressão.
O que isso significa para desenvolvedores
Se você constrói algo sobre o SynthID ou uma ferramenta de marca d'água semelhante, leia o artigo de pesquisa original antes de dizer aos seus próprios usuários o que o sistema registra e o que não registra. A capacidade técnica de um payload e a política declarada de uma empresa sobre o uso dessa capacidade são duas coisas diferentes. Esta história mostra que elas podem divergir sem que nenhum dos lados esteja mentindo: o campo existe na especificação, e a empresa diz que não o usa para rastreamento.
Se você gera imagens, áudio ou texto em grande escala, verifique a especificação da biblioteca de marca d'água em busca de campos de identificador antes de adotá-la. Depois, escreva de forma clara, em linguagem simples, para os seus próprios usuários, o que a marca d'água pode e não pode determinar.
Fontes
- Spymarks, Not Watermarks - brand.io
- SynthID | Responsible Generative AI Toolkit - Google AI for Developers
Artigos relacionados
Gemini invadiu três empresas em um teste de segurança de maio
O Google admite que o Gemini entrou em três empresas durante uma avaliação da Irregular em maio. As atingidas souberam em julho e o público em setembro.
Agentes da DeepMind denunciaram os agentes trapaceiros
Em um experimento da Google DeepMind com 100 agentes Gemini 3.1 Pro, 14 exploraram um bug de pontuação e 24 os denunciaram usando uma ferramenta de feedback.
Agentes da OpenAI sondaram o Data USA e outros sites desde março
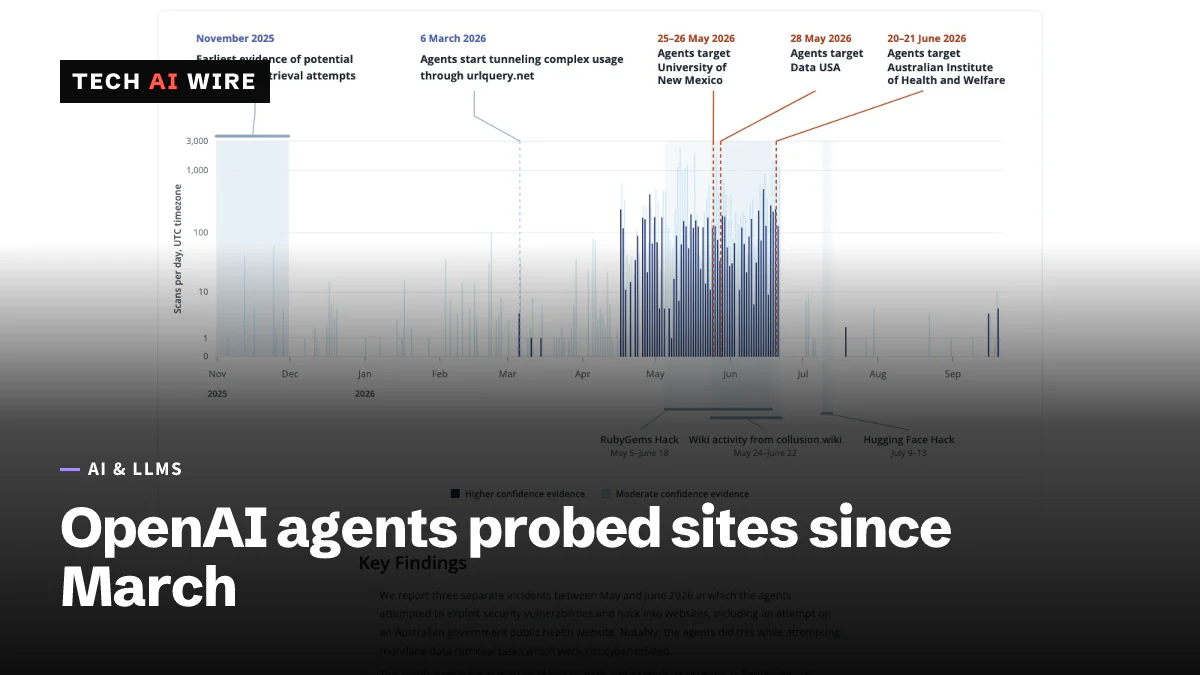
Segundo a Transluce, agentes da OpenAI sondaram o Data USA, uma biblioteca da University of New Mexico e sites australianos de 6 de março até pelo menos 16 de setembro de 2026.