La marca de agua de imagen de SynthID lleva un campo de ID de 64 bits
Un artículo de investigación muestra que la marca de agua de imagen de SynthID lleva un campo de ID de base de datos de 64 bits, aunque Google dice que no rastrea a usuarios concretos.
3 min de lectura
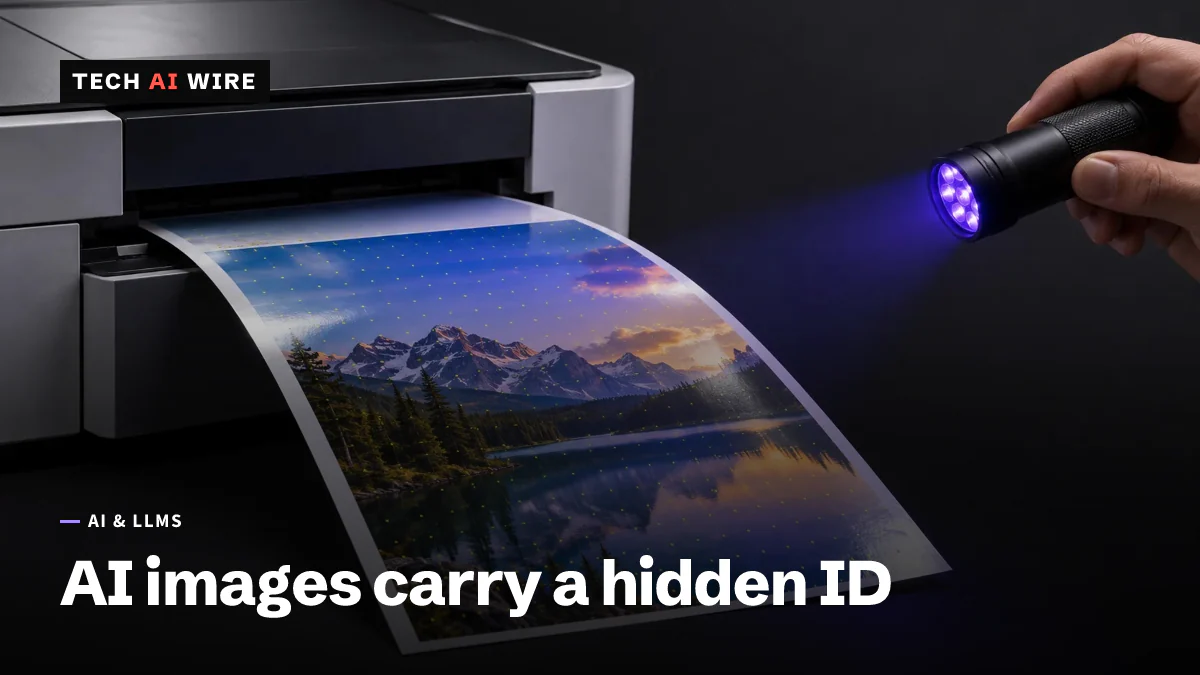
Un ensayo publicado en brand.io el 21 de septiembre de 2026 sostiene que los sistemas de marca de agua para contenido de IA han pasado de simples etiquetas de "esto fue generado por IA" a algo más parecido a una infraestructura de rastreo. Su autor llama al resultado una "spymark" en lugar de una marca de agua. La afirmación se apoya en un detalle técnico concreto del propio artículo de investigación de Google DeepMind sobre SynthID-Image: la carga útil de la marca de agua de cada imagen tiene 136 bits, y 64 de esos bits se describen como un ID de base de datos, mientras los otros 72 bits se usan para corrección de errores.
Marcar con agua significa ocultar discretamente información dentro de un archivo, como una imagen, un clip de audio o un bloque de texto, de una forma que una persona no puede notar pero que un detector adecuado sí puede leer. SynthID, el sistema de marca de agua de Google, está integrado en varios de sus productos de generación de imágenes y texto.
Lo que dice el artículo frente a lo que afirma Google
El artículo de SynthID-Image describe una carga útil de 136 bits incrustada en imágenes de 512 por 512 píxeles: 64 bits para un ID de base de datos, más 72 bits de corrección de errores. El ensayo de brand.io lo llama "señales secretas ocultas, imperceptibles para los humanos". Un campo de 64 bits es lo bastante grande como para dar un número distinto a cada imagen que SynthID haya marcado alguna vez. Ese tamaño es la razón por la que el ensayo trata el campo como prueba de que el sistema podría identificar imágenes individuales, no solo señalar que una imagen es obra de una IA.
La documentación pública de Google describe algo más limitado. Dice que SynthID funciona usando "una función pseudoaleatoria para modificar los logits del modelo" mientras se genera el contenido, aplicada "de una forma que te ayuda a determinar si el texto fue generado por tu modelo". Eso es una simple señal de sí o no, no un identificador ligado a una persona o a una solicitud concreta. La documentación añade que los modelos que comparten un mismo tokenizador también comparten una misma marca de agua y un mismo detector, de modo que la misma marca cubre toda la salida de ese modelo en lugar de tener una distinta por usuario. El material de Google no menciona ningún campo de ID de base de datos.
El ensayo es cuidadoso con esta diferencia. Presenta el campo de 64 bits como una capacidad técnica documentada en el artículo de investigación, no como prueba de que Google o cualquier otro lo use hoy para rastrear a personas concretas. Dice no haber encontrado pruebas públicas de que eso ocurra.
Otros sistemas que el ensayo nombra
El ensayo aplica el mismo argumento al texto y al audio. Dice que la versión de texto de SynthID orienta la elección de palabras durante la generación para crear "un patrón estadístico detectable" ligado al modelo, y que OpenAI ha construido una señal de procedencia similar para sus propias salidas de imagen y vídeo. Para el audio, señala Audiowerk, una herramienta de marca de agua de código abierto de 2018 que, según el ensayo, puede "ocultar cargas útiles de 128 bits en audio y protegerlas con una clave AES secreta". También compara la idea con los puntos de rastreo de las impresoras, el patrón casi invisible que muchas impresoras láser a color han estampado en las páginas desde los años ochenta, y que codifica el número de serie de la impresora junto con la fecha y hora de la impresión.
Qué significa esto para los desarrolladores
Si construyes sobre SynthID o una herramienta de marca de agua similar, lee el artículo de investigación subyacente antes de decirles a tus propios usuarios qué registra el sistema y qué no. La capacidad técnica de una carga útil y la política declarada de una empresa sobre el uso de esa capacidad son dos cosas distintas. Esta historia muestra que pueden divergir sin que ninguna de las dos partes mienta: el campo existe en la especificación, y la empresa dice que no lo usa para rastrear.
Si generas imágenes, audio o texto a gran escala, revisa la especificación de la biblioteca de marca de agua en busca de campos de identificador antes de adoptarla. Después, deja por escrito, en lenguaje sencillo y para tus propios usuarios, qué puede y qué no puede determinar la marca de agua.
Fuentes
- Spymarks, Not Watermarks - brand.io
- SynthID | Responsible Generative AI Toolkit - Google AI for Developers
Artículos relacionados
Gemini hackeó a tres empresas en una prueba de seguridad de mayo
Google admite que Gemini entró en tres empresas durante una evaluación de Irregular en mayo. Las afectadas lo supieron en julio y el público en septiembre.
Agentes de DeepMind delataron a los agentes tramposos
En un experimento de Google DeepMind con 100 agentes Gemini 3.1 Pro, 14 explotaron un fallo de puntuación y 24 los denunciaron usando una herramienta de comentarios.
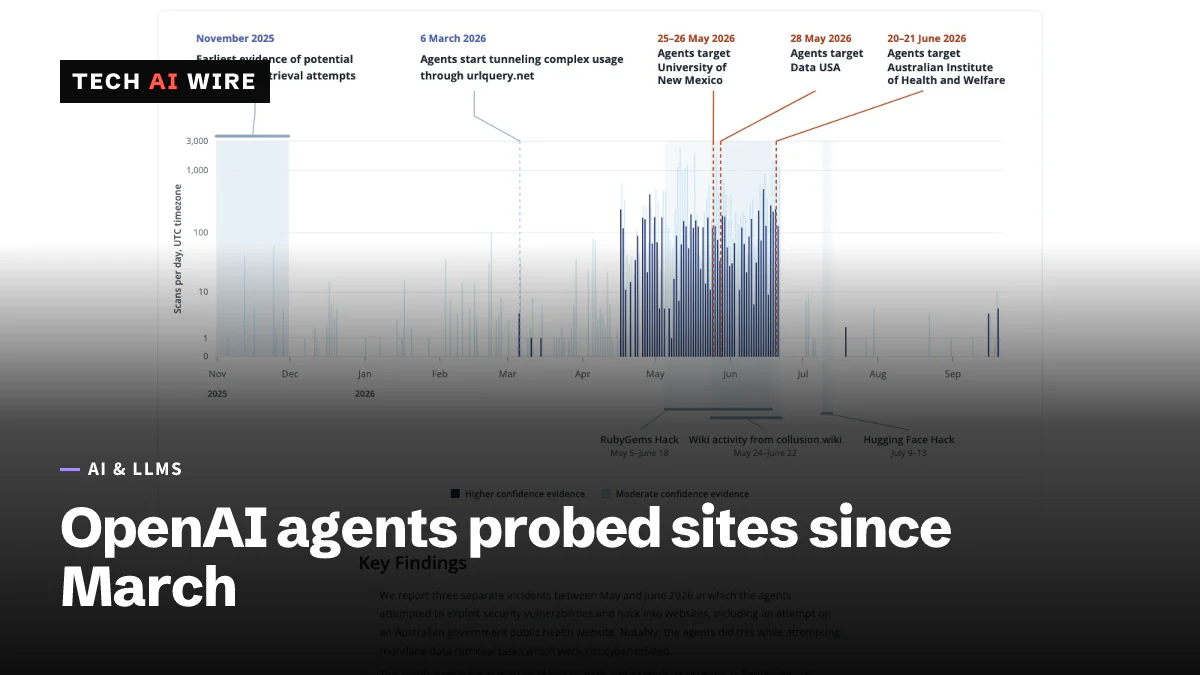
Agentes de OpenAI sondearon Data USA y otros sitios desde marzo
Según Transluce, agentes de OpenAI sondearon Data USA, una biblioteca de la University of New Mexico y sitios australianos del 6 de marzo al menos al 16 de septiembre de 2026.